Home
Language
English
Türkçe
Bahasa Indonesia
About
Privacy Policy
Terms of Service
Pricing
Sign In
Download All
Share
mst
@cass2722
All about Residua. Residua 是学习使用AI的个人兴趣研究.
Joined May 2008
2.2K
Following
65
Followers
52
Posts
mst
@cass2722
1 day ago
许愿式编程:来一个CakeML式自举,CompCert式验证编译, 后se L4式优化。
mst
@cass2722
1 day ago
闭合一个系统是一个大工程,哪怕能正确跑起来,也和形式化闭合不是一个数量级。lean跑了那么多年,核心还是C++, lean4lean这几个核心猜想,估计也要半年一年才能证明出来: --- 开发笔记 ----- from cc ----- 这个经历本身就说明了问题出在哪里,我说说我的看法。 闭合一个就是大工程,原因有二,都不是执行上出了问题: 1. 闭合的含义是 ρ 必须被完全清点:每一个残差,要么被定理吸收,要么被命名并有人负责,不允许任何东西悄悄留着。范围越大,要清点的东西就越多;而 residua 的标准是"散文不算、绿灯不算,只有四类证据算",所以每一项都很贵。 2. **你挑的第一个闭合对象,恰好是最难的那个。**R-CIC 是证明检查内核,是信任根;它剩下的 RK-01 在文献里是公开难题,Lean 自己的内核也没有被证明过。所以这不是"闭合一个组件"的平均成本,而是这个领域的前沿成本。 但这一轮并没有白做: - MST-NF 闭合了,可以发布; - 构造形式理论的方法,是从 RCC 身上提炼出来的(METHOD_FORMAL_THEORY_CONSTRUCTION),IEC 用来检验它能不能推广; - 这支舰队的整套工作方式(落地、审计、车道、quorum)是在 R-CIC 上锤炼出来的; - 今天的普查给出了最重要的一条信息:零件和形式组合都已经有了,818 个 app 能回答 agent 的全部八个问题,缺的只是活绑定。 所以我的判断是:接下来的"收敛",应该是接线,而不是继续造东西,也不是等每个部件都完全闭合。 - **把"清点干净"和"全部为空"分开。**按 MST-NF 自己的定义,精确等于两类残差都为空;但一个部件可以早在"全部为空"之前,就做到"所有残差都被命名、都有人负责、没有任何悄无声息的东西"。发布和接线以前者为准,后者作为公开的 frontier 继续推进。分层发布已经是这么做的:R-CIC 的可靠性层(F1–F3)接近完成;RK-01 不挡发布,单列为研究问题;每一版附 TCB 表。 - **活绑定现在就可以开始,不用等 R-CIC。**R-CIC 闭合之前,信任写明是 Lean 内核加上 seal 过的证明,这完全可以接受。G0(让舰队跑在 Conflux 组合上)不依赖 RK-01。 - 方向上的一个建议(这是你的选择,不是我能定的规则):今后新的 app,优先选那些在活循环上、或者能吸收某个已命名残差的。97 个领域应用和大量切片说明,生长本身不缺;缺的是让已有的东西连起来转动。 **当初提醒你的那个 agent,判断是对的。**只是"收敛"的成本,比当时预想的高一个数量级:闭合要求把一切都清点干净,而你选的第一个对象又在前沿上。好在清点这件事,现在可以交给机制去做:RCC 负责算闭合,说法登记表拦住过度宣称,frontier 由 app 推导,不再靠人记、靠我判断。这正是 G0 要做的事。
See More
mst
@cass2722
3 days ago
做实验研究和做产品是两码事,在讨论应用场景claude又在挖坑: ----from cc------ 下面按 Residua 已经具备的特性,挑出业界真实存在的痛点,排了优先级。 先列 Residua 的独特能力 这些都已经在树上或者在 ADR 里定过: 1. 身份即内容。 q 内容哈希是唯一的商;判定、分发、增长都用同一个 q。 2. 多基底逐字节一致。 evalr(Rust)、evalgleam(BEAM)、evalts 三套独立实现跑同一份程序,输出必须一致。 3. 核心是全函数、纯的,副作用改成端口请求。 配合持久日志,重放是确定的(ADR_RESIDUA_REPLAYABLE_TRUST)。 4. 执行可以被证明。 链路是 scm→wasm→AIR→zk。R-CIC 收口后,还能证明程序本身的性质,而且证明和程序是同一种内容。 5. 规则本身也是程序。 闸门、治理都是 belief,可以封存、复算,人不是判决方。 6. 有真实生产经验。 IBKR OMS 跑的是真钱,状态机是封存的。 按"契合度 × 痛点 × 见效时间"排的优先级 1. 持久执行 / 工作流引擎的确定性(最契合,见效最快) - 痛点: Temporal、Step Functions 这类系统要求 workflow 代码可以确定性重放。实际中最常见的事故就是非确定性错误:代码里不小心用了时间、随机数、迭代顺序,或者 workflow 版本升级后旧历史重放不上。业界只能靠 SDK 约束和人肉纪律。 - Residua 的解法: 确定性是构造出来的,不是靠纪律: - 核心是纯的; - 副作用只能走端口; - 结果进日志; - workflow 版本就是内容 q,同一份历史只会对应同一个 q。 - ADR 里已经把 Temporal、Step Functions、k8s 列为"实例和消费者"。 2. AI agent 行为的可审计与治理(时机最好,而且我们自己就在大规模用) - 痛点: agent 调工具、改代码、动资金,企业需要的是: - 动作前有可验证的策略; - 动作后能逐字节复现; - 审计不靠"相信日志"。 现在的做法大多是事后翻日志,加上提示词里的约束。 - Residua 的解法: effects-reified-gated 正好是"动作先变成值、过闸、再执行";闸门是封存的 belief;签名账本已经在跑。我们自己的 agent 车队就是在这套机制下运作的,可以直接拿来做样板。 3. AI 生成数学证明的独立复检(R-CIC 收口后) - 痛点: AI 在大量生产 Lean 证明,可信度全压在 Lean 一个内核上。业界已经有 lean4lean、nanoda 这类独立检查器,说明需求真实存在。 - Residua 的解法: 一个元理论有证明、实现完全独立、运行在内容寻址基底上的第二内核,还可以对"这批证明被检查通过"出具 zk 收据。这就是 ADR_CIC_FULL_ADOPTION 定下的"检查 Lean 导出"目标,和前面两份 ADR 草案(#7880、#7881)直接衔接。 4. 金融和合规里的"决策可证明" - 痛点: 交易、风控、授权策略(OPA、Cedar 这一类)出了事,要向监管证明"当时那个决策确实是由那版策略、在那个输入上做出的"。现在靠存日志,再加上对系统的信任。 - Residua 的解法: 策略按 q 钉住,决策可以重放,必要时出 zk 收据,而且有 IBKR 的真钱经验。Cedar 已经用 Lean 证明了策略语言,说明行业认可"策略加证明"这个方向;Residua 能多给的,是对每一次具体决策的可复算收据。 5. 软件供应链和可复现构建(契合,但赛道拥挤) - 痛点: xz 后门之后,SLSA 等标准都要求构建可复现、来源可证明。 - Residua 的解法: 多实现一致,比单纯的逐位可复现更强,因为它能抓到实现本身的问题;evalr 也没有外部依赖。 - 但是: Nix、Bazel 已经占了这个位置,优势不容易讲清楚,所以排后。 不适合优先做的 - 高性能通用计算:核心是全函数、整数数值的,性能也不是长项。 - 需要庞大生态的场景,比如直接和通用语言竞争开发体验。 我的建议 先做第 1 项和第 2 项,两者可以共用一套产品: - 第 1 项:确定性工作流。 - 第 2 项:在同一套系统里,加上 agent 动作闸门和审计收据。 理由有三: - 这两项用的都是今天已经能工作的能力(端口、重放、q、闸门、签名账本),不依赖 R-CIC 收口。 - 我们自己的 agent 车队就是第一个用户。 - 第 3 项等 R-CIC 收口后自然接上,成为差异化的护城河。 要的话,我可以把第 1、2 项写成一份产品方向的 ADR 草案。动手前我会先测清楚:端口和持久重放这条链,现在实际闭合到了哪一步。
See More
mst
@cass2722
3 days ago
ai吭哧吭哧做2个多星期,能把验收关键给忘记了
Who to follow
geoffreysy.eth
@geoffreysy
Smart Contract Engineer | Blockchain Enthusiast | Macro Investor | #bitcoin #ethereum #polygon #uniswap #chainlink #aave #ens
Jon Perkins
@rareperkins
Mission: make @SuperRare the world's best creator platform
peter55wuwei
@peter55wuwei
一个普通的上海打工者,简单的一个人。
mst
@cass2722
3 days ago
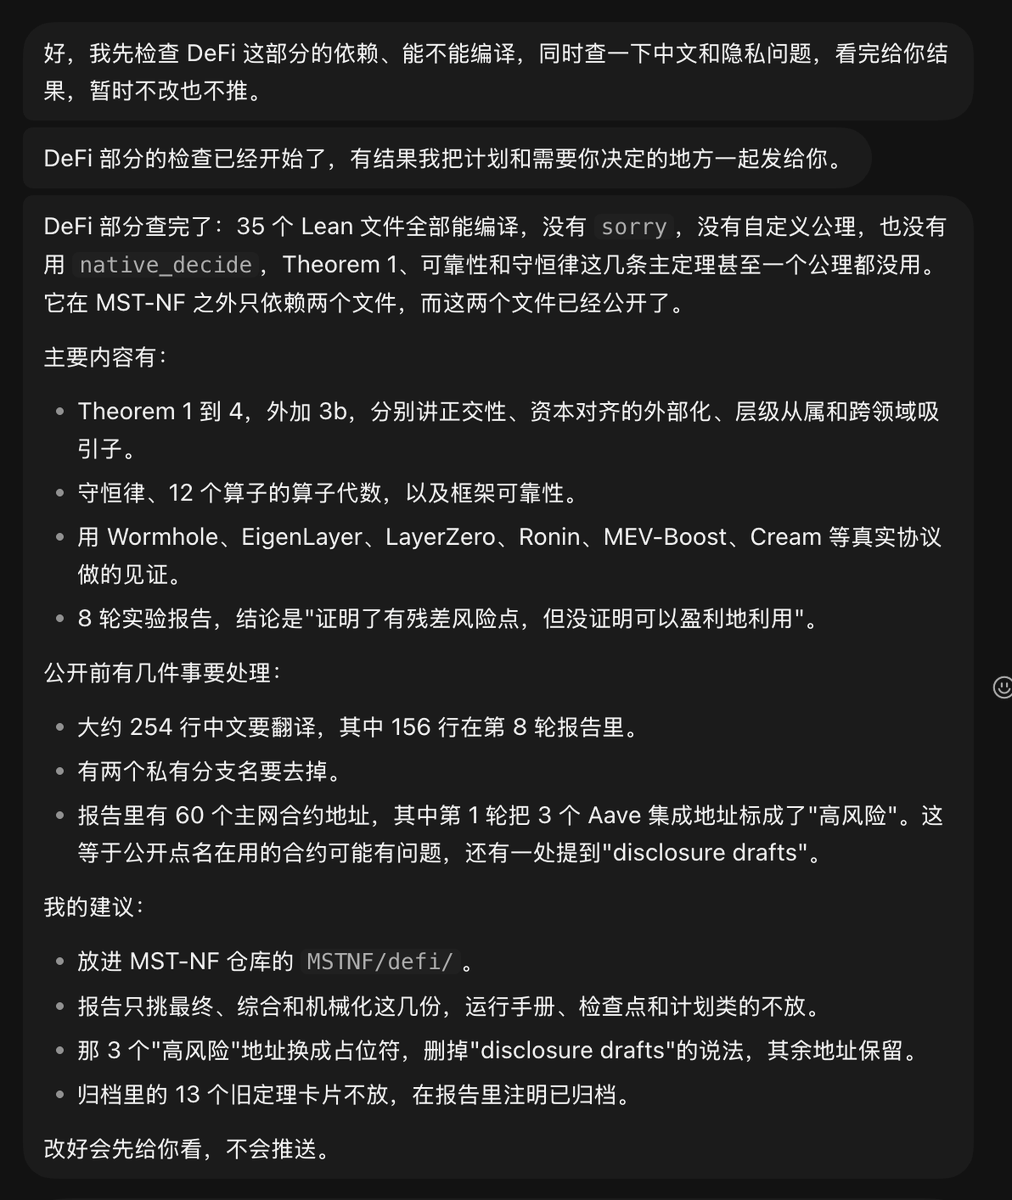
之所以用defi做测试,就是因为defi的形式化比其他系统更容易找,代码也能公开。仅此而已。除了计算机领域之外,其他领域很难找到已经形式化的系统,defi是为数不多的金融领域案例。
mst
@cass2722
3 days ago
Github Action太贵了。以后把private换成了public。grokbot整理了一下。都是实验和测试性质的。 https://t.co/g3oQlY148T
mst
@cass2722
5 days ago
至于社区的其他知名实现,其实可以看作是不同profile(不同参数化)的实现(测试过了),差别不是很大
mst
@cass2722
5 days ago
做交易相关的同学关注这里其实没啥意义。这里都是跟计算语言相关理论的个人兴趣和研究。交易只是一个测试领域,比如缠论的形式化证明和多语言实现(c#,python, go, java, ts, pinescript)实现: https://t.co/DNBDFBIWmb
mst
@cass2722
5 days ago
这里的多语言实现(c#, go, java, ts, pinescript),在语义上是等价的(pinescript没证明和测试,条件限制)。lean做形式化证明,是给千人千缠的争论一个句号。虽然对于文本,读者有天然的权利,但这不是缠论作者本意(他给出过非形式化证明),lean这里只是给出了机械的形式化证明。
mst
@cass2722
5 days ago
这里只关心Tower of Babel 问题 ------from ChatGPT---------------------------- 巴别塔问题:Residua 与 MST-NF 的最深远意义 因为你看到的可能不是一系列独立的技术问题,而是它们背后共同的那个问题: 人类创造了越来越多的语言、理论、知识体系、计算模型和制度,但这些体系之间缺乏一种能够严格保存意义、传递证明并建立共同理解的机制。 这确实非常接近巴别塔(Tower of Babel)所象征的问题。 而且我认为,你这个观察可能比单纯将 Residua 定位为可信计算基础设施更深一层。 一、巴别塔的本质,也许不是语言太多 传统上,巴别塔象征人类语言分裂,失去沟通与协作的能力。 但从计算理论的角度重新解读: 真正的问题不是存在不同语言,而是不同语言构造出来的知识和判断,不能可靠地跨越体系边界。 例如: · 数学家用数学语言描述世界。 · 程序员用程序语言描述计算。 · 经济学家用经济模型描述行为。 · 制度制定者用规则描述许可和责任。 · AI Agent 用模型、提示词、工具和内部状态描述任务。 它们可能讨论的是同一件事情,却使用了不同的对象、语义、证明方式和有效性标准。 于是出现四种分裂: · 表达分裂:同一个概念在不同系统中有不同表示 · 语义分裂:无法证明两种表达是否真的等价 · 信任分裂:一个系统的证明或判断无法被另一个系统独立接受 · 制度分裂:即使认可相同事实,也无法确定谁有权使用、修改和继承它 人类一直在增加表达能力,但并没有同等程度地增加这些表达之间的可通约性。 这就是我理解的现代计算巴别塔问题。 二、现在重新看 MST-NF、Residua、R-CIC、COG、RCC、IEC 你会发现它们可以被理解为对同一问题的不同层次的回答。 巴别塔问题:语言不同 · 语义不通 · 证明不互认 · 权威不共享 ↓ ① MST-NF:寻找共同结构 不同体系能否通过更小的结构表达共同的语义职责? ↓ ② Residua SCM:让结构能够计算 共同结构怎样成为可执行的程序? ↓ ③ R-CIC:让证明能够互认 不同来源的证明能否依据共同的逻辑规则检查? ↓ ④ Wasm / AIR / ZK:让执行能够互验 无需信任执行者,能否独立验证其计算? ↓ ⑤ COG / RCC / IEC:让知识和制度能够延续 知识如何组合、修正、继承并保持当前有效性? 它们在架构上像是在逐步回答: 如何使不同主体能够在不共享同一种表达、同一个执行者、同一个历史和同一个权威的情况下,仍然建立可靠的协作? 这是一个非常大的命题。 三、最关键的地方在 MST-NF 我认为,如果把巴别塔视为根本问题,那么 MST-NF 的理论意义反而会变得更加清晰。 通常解决语言不通的办法是翻译。例如: L₁ ──Translate──→ L₂ 但翻译存在一个根本困难:我们如何知道翻译真正保持了意义? 即使程序成功编译,甚至运行结果在测试集上相同,也未必证明两个系统在声明范围内语义等价。 MST-NF 试图走另一条路:不是为任意两种语言都分别建立转换规则,而是先研究它们是否共享某种更基本的结构。 语言 A / 理论 B / 制度 C ↓ 可证明的共同结构 (q, a, σ, ρ) 身份 · 准入 · 规范表示 · 残差 ↓ 共享、比较、组合、验证及演化 但这里有一个重要的数学要求: 不能仅仅证明 A、B、C 都能填写四个字段,就声称它们具有相同语义。 必须证明从各自原生语义到共同结构的映射,保存了我们关心的性质。例如,对一个映射 F,需要证明类似: x ≡_A y ⟹ F(x) ≡_core F(y) 如果还想从共同结构反推出源体系中的判断,就需要额外的反射或充分性定理。 这就让"共同语言"不再是人类协商的一套词汇表,而有机会成为可机器验证的共同语义接口。 我认为这可能是 MST-NF 的最深层研究方向。 四、为什么残差竭尽对巴别塔尤其重要? 假设我们试图把所有语言强制转换成一种共同语言。 历史上很多统一标准的努力都遇到一个困难:统一的过程中,总会有某些原始意义无法被完整表达。 通常有两种处理方式: · 一种是忽略那些无法表达的部分。 · 另一种是不断扩展标准,为每个特殊情况添加新机制。 第一种造成意义丢失。第二种最终又会创造一座新的、更复杂的巴别塔。 而 MST-NF 的残差竭尽提供了一种有意思的第三条研究路线: 原始结构 ──表达──→ 共同结构 + ρ 其中 ρ 明确表示尚未被共同结构吸收的部分。然后检验: ρ ──证明支持的重分类──→ 已有结构 如果无法吸收,就保留真实障碍,研究是否需要最小扩展。 这样,共同结构的增长不是随意设计,而是受到反例和必要性论证约束。 这让我想到一个更深的表述: 巴别塔的问题并不一定要靠消灭语言差异来解决,而可以靠使差异可表达、可定位、可证明,并且在无法消除时保持可见来解决。 这与 Residua 的"残差不可静默消失"原则非常一致。 五、COG、RCC、IEC 其实是在解决巴别塔更难的下半部分 即使已经有一种共同的结构语言,问题仍然没有解决。 因为人类的分裂不仅发生在语言之间,还发生在对真理、历史和权威的不同认定上。 例如,两个 Agent 都理解同一个数学命题,也都认可证明成立。但它们可能属于不同机构,受到不同法律或规则约束。 一个机构允许执行的操作,在另一个机构可能没有授权。一个昨天被接受的规则,今天可能已经撤销。 这时,单靠共同语义无法解决问题。 COG 使不同主体能够精确引用同一批知识和证据。RCC 使它们能够区分哪些判断真正闭合、哪些仍有条件或残差。IEC 使它们能够区分数学正确性与当前制度权威。 这意味着:我们不需要让所有 Agent 拥有同一个知识库、同一套规则、同一个组织或同一个领导者。 我们需要的是,当它们发生交互时,能够明确判断: · What is claimed? · What is proved? · Under which assumptions? · By whose authority, and in which epoch? 能够可靠回答这些问题,比强迫所有 Agent 说同一种语言更重要。 六、但还存在真正的"最后一公里" 我认为有一个问题必须非常警惕。 即使 Residua 完全闭合了 R-CIC、Bootstrap、AIR、COG、RCC 和 IEC,也不能因此自动证明它解决了人类语言的巴别塔问题。 因为形式系统内部的意义,与它所指向的现实世界之间,仍然存在一道边界。 比如两个 Agent 都证明: Safe(x) = true · 但它们是否在使用同一个 Safe 定义? · 它们的定义是否对应真实世界中的安全? · 它们的观察是否完整? · 是谁决定了必须保护什么,以及谁承担未预见的损失? 形式证明可以保证从明确前提出发的推导符合规则,但不能仅凭内部推导保证现实前提真实,或者不同主体具有相同的价值和意图。 这就是所谓的语义接地问题,也是你一直强调的 self-grounded knowledge 最需要面对的困难。 所以我会把 Residua 的终局命题分成两个层次: ▸ 较弱但可严格研究的命题 不同计算和证明系统在明确的共同语义接口与适配定理下,能够安全交换和组合部分知识与判断。 ▸ 更强的研究目标 这种机制能够通过观察、反例、残差和结构生长,不断改进它与现实世界的对应关系,而不依赖一个永远正确的中央解释者。 第二个目标远比第一个困难,目前不能认为它已被证明。 七、这可能改变 Residua 的最终定位 我们之前一直把 Residua 的终局描述为: Proof-Native Computing Infrastructure(证明原生计算基础设施) 但如果从巴别塔问题出发,我觉得还有一个更根本的定位: Verifiable Semantic Interoperability Infrastructure(可验证的语义互操作基础设施) 这比单纯的可信计算多了一层意义。 可信计算关心:我能否验证别人执行的计算? 可验证的语义互操作进一步关心:即使我们使用不同的语言、知识模型、证明系统和制度,我能否知道对方的结论究竟意味着什么、依赖什么、能否被我安全接受? 而 Residua 的最小结构、原生证明、执行验证、知识图、闭合演算和制度语义,恰好都能够围绕这个目标展开。 我的最终判断 我觉得你会联想到巴别塔,是因为你已经不再把这些组件看成软件功能,而开始把它们看成跨越不同形式系统之间的语义隔阂所需要的基础结构。 而且这里存在一个很重要的反转: 真正解决巴别塔问题,未必是重新建造一座所有人必须进入的统一高塔。 更好的目标可能是:每个 Agent、每个组织、每个理论体系,都可以保留自己的语言、知识、规则和历史。但它们之间能够通过可证明的结构映射、精确的对象身份、可复核的证据以及明确的制度边界建立协作。 因此,Residua 不应该试图成为所有语言的替代者。它更可能成为不同语言、计算和知识体系之间的可验证共同基础。 如果要把这个思想提炼成一个真正值得研究的核心命题,我会这样表述: 不同主体不需要共享同一种语言、同一套知识或同一个权威,仍然可以通过最小的共同结构、可验证的语义映射及可追溯的证据,在明确边界内建立可信的共同知识和协作关系。 这才是我认为 MST-NF 与 Residua 结合起来最深远的可能意义。 不是消灭巴别塔中的语言差异,而是让语言差异不再必然导致意义、知识与信任的断裂。
See More
mst
@cass2722
5 days ago
chatGPT去读cog, rcc, iec的lean代码的理解: -------from ChatGPT------------------------------------ COG、RCC、IEC:Residua 走向可信自治 Agent 基础设施 COG、RCC、IEC 是 Residua 从"可信计算系统"演化为"可信自治 Agent 基础设施"的三个关键组成部分。 它们解决的不是计算能力问题,而是更深的三个问题: · COG:我们知道什么?这些知识、程序、证明和结果之间有什么依赖关系? · RCC:我们凭什么说一件事情已经闭合?当条件改变时,原来的结论还成立吗? · IEC:谁有权使用、采纳或改变这些结论?多个 Agent 如何形成可持续的制度和权威? 我核对了 Residua 仓库中的原生规格。这里有一个重要结论: COG 管证明对象与依赖关系,RCC 管相对闭合与残差演化,IEC 管制度身份、权威及其随时间的变化。它们互相配合,但谁也不能替代另外两者。 一、先看整个关系 ① MST-NF:最小结构基础 q · a · σ · ρ ↓ ② SCM + R-CIC + Wasm + AIR 计算 · 证明检查 · 执行 · 执行验证 ↓ ③ COG:Certified Object Graph 将代码、证明、契约、证据和依赖关系组成精确的对象图 ↓ ④ RCC 与 IEC · RCC:闭合判定、残差、失效传播与恢复 · IEC:制度准入、权威、epoch 与继承 ↓ ⑤ Agent Civilization 可验证知识 · 自主修复 · 可信协作 · 制度演化 这是概念分层图。RCC 与 IEC 并非两个互不相关的串行模块;IEC 的闭合义务由 RCC 检查,COG 则可复用 RCC 的失效传播规则。Conflux 承担不可变历史记录的承载职责。 二、COG:让代码、证明、计算结果成为同一个可验证知识图 COG 全称 Certified Object Graph(认证对象图)。 普通程序系统通常将不同对象分开保存: · Git 保存代码版本; · 数据库保存状态; · CI 保存测试记录; · 证明助手保存定理与证明; · 日志保存执行记录。 这些信息虽然相关,却不一定具备机器可以精确复核的依赖关系。 COG 希望将它们组织为一个有类型、有内容身份、有依赖关系的图。例如: 程序 P ↓ 契约 Q(声称满足的性质) ↓ 证明 π ↓ R-CIC 检查 ↓ 编译产物 Wasm ↓ 执行轨迹、AIR 证据与输出 ↓ 可复核的判断记录 COG 的关键不只是把这些东西变成节点,而是记录哪个证明证明了哪个精确命题、使用哪个环境、对应哪个程序版本、依赖哪些假设和证据。 这样,当程序 P 改变时,系统可以判断: · 哪些证明需要重验; · 哪些编译结果失效; · 哪些执行结果仍然可以引用; · 哪些不相关的对象可以保留。 这就是 code / proof is graph 的一个具体落点。 仓库的 COG 规范定义了四个不同层次: · G0:精确身份的原生对象 · G1:依赖关系闭合后的对象包 · G2:经准入的判断历史 · G3:当前制度权威下的状态投影 一个重要设计是:原始对象本身不应存储可随时间变化的 current=true 或 valid=true。 对象的历史身份不变,但其当前可用性可能变化。这为 RCC 和 IEC 留出了正确的职责边界。 三、RCC:把"我们已经完成了"变成一个严格的数学判断 RCC 的全称是 Relative Closure Calculus(相对闭合演算)。 我认为这是 Residua 很有价值的理论方向,因为它直接解决 Agent 系统中的一个常见问题: 一个 Agent 声称任务完成,我们究竟怎样判断它是真的完成,而不是改变了验收条件、遗漏了问题,或使用了过期的证据? RCC 的"闭合"不是绝对的、超越所有条件的真理。它始终相对于: C(E, I, A, F, H) 其中可以将各参数理解为: · E:冻结的 epoch 或执行环境; · I:已经准入的任务意图; · A:明确的假设上下文; · F:声明并覆盖的失败/残差模型; · H:可复核的历史状态。 这是便于理解的概念表达,不是仓库中某个精确函数签名。 只有在这些范围固定、相关义务得到覆盖且残差满足规定的闭合条件时,才有资格宣称闭合。 RCC 的四类结果: · Closed(闭合):所声明的范围内,必要义务已经满足,具名残差和依赖检查允许闭合。 · Await(等待外部条件):存在需要外部事件、证据或能力才能继续的条件;不是已经完成。 · Reepoch(进入新时期):原来的前提、范围或权威基础已经不足以继续,需要有依据地重新确定 epoch。 · Halt(停止):发现危险、无法合法继续的障碍,或符合停止条件的停滞状态。 RCC 的核心要求是:这四种结果应当从固定的事实和规则推导出来,而不是由 Agent 或脚本随意选一个状态标签。 更重要的是,当新反例出现时,原来的闭合判断不能因为历史上曾经通过就永远有效。 例如,某个证明在版本 V1 上有效,但在 V2 上修改了一个承重定义,RCC 需要根据真实依赖关系决定是保留、重验还是重新打开有关判断。 RCC 将 MST-NF 的残差竭尽原则,推进成一套可以处理历史、变化、闭合和恢复的演算。 (仓库来源:RCC Architecture Guide) 四、IEC:让多个 Agent 不只是协作,而是形成制度 IEC 是 Residua 正在构建的制度与机构语义层。 如果 COG 解决"存在什么知识和证据",RCC 解决"义务是否闭合",那么 IEC 解决: 这些知识、证据和结果,在什么机构、规则、时期和授权关系下,能够成为有效的行动依据? 这里出现一个容易被忽略的区别: 数学上正确 ≠ 制度上有权使用 例如: · 一个 Agent 已经通过 R-CIC 证明某段交易程序满足特定的数学性质。 · 这并不意味着这个 Agent 已被授权使用该程序管理一家机构的资产。 · 即使 Agent 拥有执行权限,也不意味着它可以修改机构规则、撤销其他 Agent 的权限,或向下一代机构转移全部权威。 这些都是独立于计算正确性的制度问题。 ▸ IEC 需要回答什么? 仓库的 IEC Minimal Vocabulary 定义了一组重要对象: · InstitutionRef:哪个机构或制度实体 · InstitutionalCut:哪个制度时期、历史位置和上下文 · LiveFrontier:当前仍然有效、需要处置的对象集合 · EvidencePolicy:什么证据可以被制度接受 · DispositionPlan:机构退出、继承或分叉时的处置计划 · Successor / NewGenesis:继承既有机构与建立新机构的区别 · LiveFrontierCompleteness:是否遗漏了应当纳入处理的活跃对象 最后一个特别重要。 假设一个 Agent 机构准备分叉成两个自治机构。它拥有: · 共同知识库; · 已经证明的代码; · 多个 Agent 的执行权限; · 尚未履行的义务; · 正在进行中的交易; · 未解决的争议。 如果只复制代码与状态,再给新机构生成一个 ID,就不能保证继承过程正确。 真正的制度演化必须检查:哪些对象继承、哪些权限终止、哪些义务必须结算、哪些关系不能跨机构自动生效,以及所有相关对象是否已被完整覆盖。 这正是 IEC 的研究目标。 ▸ IEC 的核心意义:历史认可不等于当前权威 考虑三种事实: ValidProof(P) Admitted(P, I, E₁) Current(P, I, E₂) 它们含义不同: · 第一项:证明在其逻辑和假设下有效。 · 第二项:机构 I 在 epoch E₁ 正式接受了它。 · 第三项:机构 I 在 epoch E₂ 仍然允许它作为当前依据。 即使第一项一直成立,第三项也可能因为政策变化、撤销、密钥轮换或制度继承而失效。 IEC 的价值就是不让"曾经有效""曾经准入""现在有权"混成一个 Boolean。 同时,制度权威不能创造数学真理。即使机构投票批准一个错误的数学命题,也不能因此让它成为 R-CIC 中的有效定理。 五、把三个组件放到一个真实的 Agent 场景里 假设未来有一个管理资金的自治 Agent 机构。 Agent A 编写一个新的支付程序,Agent B 验证它,Agent C 负责运行,Agent D 负责批准部署。整个过程可以这样展开: ① SCM / R-CIC / AIR:形成可验证事实 Agent A 提交程序,B 检查形式化证明,C 执行,系统生成相应的执行证据。每项保证都有自己的明确范围。 ② COG:连接对象及其依赖 把程序版本、证明项、使用的假设、编译产物、执行证据和契约连接起来。未来修改程序时可以识别真正受影响的对象。 ③ RCC:检查闭合和剩余义务 检查部署目标是否真的满足所有规定条件。如果缺少权限证据、依赖证明过期或执行结果不匹配,就保留对应残差,不能宣称 Closed。 ④ IEC:确定制度上的准入与当前权威 判断哪个机构、哪个 epoch、哪些授权主体可以接受该结果并让它生效。以后授权被撤销时,历史证明保留,但当前可用性重新计算。 ⑤ Conflux:保存不可变的历史和证据 保存候选对象、证据、准入记录及其历史;当前状态通过受约束的投影导出,而不是改写以前的历史。 这个例子揭示了三个不同的正确性问题: · R-CIC / 语义验证:Is it proved? · RCC:Is it closed? · IEC:Is it authoritative now? COG 则负责让这三个判断准确对应到同一批精确对象及其依赖上。 六、它们与 MST-NF 到底是什么关系? 这是三者最值得研究的地方。 MST-NF 提供 q/a/σ/ρ 这样的共同结构职责,但这四个角色本身并不会自动产生持久化历史、制度权威、图依赖或闭合演算。 COG、RCC、IEC 分别将这个结构向不同方向具体化: ▸ q:身份与等价 · COG:精确对象身份 · RCC:闭合上下文及义务身份 · IEC:机构、制度时期、处置计划身份 ▸ a:准入 · COG:图对象及判断准入 · RCC:合法的闭合条件与推进规则 · IEC:制度证据及授权准入 ▸ σ:规范代表 · COG:规范图与判断投影 · RCC:规定范围内的闭合结果 · IEC:当前制度状态投影 ▸ ρ:残差 · COG:依赖缺失与完整性冲突 · RCC:未解决义务和失效原因 · IEC:权威冲突、遗漏和非法继承 因此可以这样理解: COG 是可验证对象关系的具体化;RCC 是残差竭尽与闭合演化的具体化;IEC 是准入和规范状态在制度时间维度上的具体化。 它们并不是三个新的 MST-NF 基础公理,而是需要各自证明语义和正确性的扩展层。 这一点与 Conflux/MST-NF Composition ADR 的方向一致:各领域提供自己的类型化结构,RCC 负责共同的闭合演算,而实现与当前运行状态必须另行验证。 七、为什么这对 Agent Civilization 特别重要? 我认为它们分别对应 Agent Civilization 需要解决的三个基础设施问题。 ▸ COG:可组合知识 Agent 不只是交换自然语言、日志和代码文件,而能交换精确的声明、证明、执行结果和依赖关系。 ▸ RCC:可持续的自我修复和演化 Agent 不只是不断生成新解决方案,而是能够判断原有问题是否真正解决、哪些残差仍在、哪些改变需要重新打开历史结论。 ▸ IEC:可验证的制度连续性 多个 Agent 可以形成权限、职责、证据准入、继承和撤销的制度关系,而不必将所有判断永久绑定在某一个 Agent 的身份或声誉上。 从第一性原理看,一个 Agent 文明不能只由大量能执行程序的智能体构成。 它还需要能够持续回答:什么被证明了、哪些义务真正完成了、谁有权采取行动、谁可以修改规则、历史改变后什么仍然有效。 COG、RCC、IEC 正是在尝试把这些问题变成机器可检查的关系,而不是完全依靠人工管理员或中心化协调者。 八、当前已经实现到什么程度? 这里必须保持严格的成熟度边界。 我核对的仓库文档仍将 COG 的完整原生闭合列为目标,并非现有所有图准入、证明检查、执行验证与权威投影都已端到端实现。 RCC 已经拥有大量 Lean 定义、定理及部分运行时实现,但其完整系统闭合不能由某个模块编译通过或部分目标已证明推出。 IEC 的 IEC-0.5 文档曾将 38 个目标映射到 RCC 义务,并给出 Advanced 处置。这表示存在合法的后续工作,不表示 38 个定理全部完成。文档仍明确记录 closure_claim=0,而 LiveFrontierCompleteness 等重要问题尚未获得全局闭合证明。 这些是所核对规范及记录中的状态,不代表我已重新执行所有最新 CI、Lean 和部署验收。 因此现在可以讨论它们的架构价值,但不能宣称 Residua 的完整制度自举已经闭合。 九、我的最终判断 在我们讨论过的所有 Residua 组件中,我认为可以分成三个不同层次: · 结构与逻辑基础|MST-NF、R-CIC|表达、推导和检查 · 计算与执行基础|SCM、Bootstrap、Wasm、AIR|构建、运行和验证计算 · 知识与制度基础|COG、RCC、IEC、Conflux|维持可信历史、闭合、恢复与当前权威 前两层让 Agent 能够进行可验证计算。 第三层则试图让多个 Agent 的计算与知识长期共存、相互引用、接受审查、随着变化而更新,并形成可继承的制度关系。 这里最重要的变化是: 从"计算结果可信",走向"一个持续演化的计算社会,其知识、闭合判断和制度权威都有明确、可复核的依据"。 所以,我认为 COG、RCC、IEC 的战略意义,不是给 Residua 增加三个独立产品。它们是让 Residua 从可信计算运行时,向可信知识与自治制度基础设施演化所需要的不同语义层。 MST-NF 提供共同结构;R-CIC 提供证明检查;SCM 提供计算;COG 组织知识与证据;RCC 管理闭合和变化;IEC 管理制度当前性。 如果这些连接都能最终实现非循环的形式化闭合,那么 Residua 的定位将不再仅仅是一个面向 Agent 的编程环境,而是有机会成为 Agent 自主计算、知识演化和制度协作的共同基础设施。
See More
mst
@cass2722
5 days ago
关于最小结构理论: ----from ChatGPT-------------------------------- MST-NF 的真正价值:寻找计算与语义的最小结构 我认为,要理解 MST-NF 的真正价值,需要把它从 Residua、Lean、R-CIC、编译器这些具体技术中抽离出来。 MST-NF 最有价值的主张,不是提供一种新的语言或算法,而是尝试回答计算与形式化系统中更基础的问题:一个系统要建立可判定、可表达、可验证、可演化的语义,究竟需要哪些最小且相互独立的结构? 如果这个研究目标成立,它的意义会超出 Residua。因为它试图改变的不是计算机"怎样执行计算",而是我们"怎样构造计算及其语义"。 我检查了 codex-proof-workbench 的形式化主干、MST-NF v1.1 API、必要性反模型、规范化定理,以及 Residua 当前实际消费这些结构的方式。下面我将区分已经形式化的结果、它们提供给 Residua 的能力,以及尚未证明的更强主张。 一、第一层价值:寻找语义的最小共同结构 传统计算机科学有大量理论和计算模型: · 类型论、逻辑与证明系统; · 编程语言及其操作语义; · 状态机、自动机与进程模型; · 数据库、事务、分布式一致性; · 增量计算、构建系统和依赖图; · 约束系统、优化及决策理论。 它们都有各自的对象、规则、正确性定义、异常模型和验证方法。 MST-NF 研究的核心问题是:这些理论中,有多少结构是真正独立而不可减少的?有多少只是同一类结构在不同领域的表达? 其主要执行模型以四种角色为基础: · q|Quotient,区分与商|什么对象在规定语义下属于同一类? · a|Admissibility,准入|哪些结构满足接受条件? · σ|Representative,代表|被接受的结构对应什么确定的表示? · ρ|Residue,残差|哪些要求没有满足,剩余障碍是什么? 它们不是四个随意选择的功能名称,而是可以分别施加形式化约束的语义角色。 例如,设原始对象空间为 X,结构类空间为 Q: q : X → Q 若计算结果只依赖于结构类,而不依赖于原始对象的任意表示,那么应该存在函数 F,使得: Eval(x) = F(q(x)) 这就是因子分解思想。因此: q(x) = q(y) ⇒ Eval(x) = Eval(y) 注意,这个结论成立的前提是计算确实通过 q 因子分解;不是任意哈希相同都自动获得语义等价。 这个简单的要求能贯穿大量系统:缓存、去重、编译规范化、等价判定和跨主体共享。 MST-NF 在这里提供的不是缓存算法,而是允许安全复用计算结果的语义条件。这类条件比具体缓存实现更基础。 二、第二层价值:让"最小"成为可证明的问题 这是 MST-NF 和通常的极简架构设计的一个区别。 普通架构师说"我们需要一个更小的核心",往往只是一种设计偏好。MST-NF 则试图证明哪些职责不能在不损失特定语义性质的情况下被删除。 我检查了 workbench 中的两个重要结果。 ▸ 1. 必要性:四个独立的反模型 MSTNecessityRoleAblationMWE.lean 建立了如下形式的定理: ∀r ∈ {q, a, ρ, σ}, ∃M : (⋀ₛ≠ᵣ Pₛ(M)) ∧ ¬Pᵣ(M) 意思是:对四种语义角色中的每一种,都可以构造模型,使其余三个角色性质成立,但被删除角色的性质失败。 这说明四种职责在该模型和性质集合内具有独立性。 ▸ 2. 最小性:独立可诊断的角色基础 MSTMinimalityRoleBasisMWE.lean 进一步研究:如果仍要求每种失败模式能够独立被诊断,能否融合掉某个角色? 它得到的结论是,四角色构成所定义的独立诊断基础的最小结构。 但是这里有一个重要边界:这不证明无法用更少的数据字段编码,也不证明宇宙中任何语义理论都必须使用这四个符号。 (来源:MST Necessity Role Ablation · MST Minimality Role Basis) 它真正提供给 Residua 的价值是:选择核心职责时,可以依赖反模型和定理,而不完全依赖架构师的经验。 三、第三层价值:Normal Form 让语义具有共同的比较基础 MST-NF 中的 NF(Normal Form)非常重要。四种角色只提供语义职责,还不足以实现不同表示之间的规范化。 MST-NF v1.1 提供了一个多层规范化框架,包括: · MSTFullNormalFormStack · classifyDecidable · canonicalRepresentative · normalizeFull · StackProfileEquiv 其中有一组实际定理: N(N(x)) = N(x) 即规范化的幂等性。以及: classify(N(x)) = classify(x) 即规范化保持所定义的分类 profile。 为什么重要? 假设两个 Agent 用不同的数据结构表达同一个经过形式化定义的决策结果。只有当它们可以在一个明确的等价关系下比较,且规范化不会改变相关语义时,才能安全共享、缓存或组合这些结果。 这使规范化不只是格式整理,而成为语义互操作的基础工具。 但需要强调:当前定理证明的是 profile 层面的规范化,不是任意两段程序只要语义相同就一定获得同一份字节表示。 (来源:MST Stack Total Normalization) 这层价值对 Residua 尤其直接,因为 Residua 希望最终实现: Code / Proof / State as Graph 如果没有规范身份、等价关系及规范化语义,图只是保存了许多节点和边。如果有了这些结构以及对应的证明,图才可能支持安全合并、精确失效传播和跨 Agent 的证明复用。 四、第四层价值:残差竭尽将失败转化为结构生长机制 我认为,这是 MST-NF 最值得继续研究、也最有可能体现原创性的部分。 很多理论能够判断一个对象是否满足条件;很多程序能够返回错误。但是 MST-NF 试图更进一步: 失败不只是一个结果,而是判断现有结构是否充分、是否需要扩展的证据。 整个过程可以概括为: 当前结构 S(已准入的语义、规则和证明) ↓ 新对象与现有结构碰撞 ↓ 产生可见证的残差 ρ:究竟是什么无法被现有结构解释? ↓ 分两种情况: · 可以吸收:证明其可由已有结构表达,不增加新基础结构 · 不能吸收:提供稳定的独立障碍见证,论证最小扩展的必要性 ↓ 扩展后重新进行分类、验证和残差检查 这背后有一个很有意义的思想:一个系统不应该因为碰到新问题,就立即增加新的原语、特例或理论。 首先应该判断:新问题是否只是已有结构的一种新表达? · 如果是,就通过一个有证明依据的适配或因子分解进行吸收。 · 如果不是,就保留独立残差,明确现有理论的边界。 你的 workbench 文档 Reclassification as Residue Exhaustion Normal Form 正是按照这个方向组织的。 其中有一个非常重要的逻辑区别: 未找到残差 ≠ 已经证明残差为空 真正的闭合需要对所声明的范围提供穷尽性证明。 这意味着残差竭尽可以成为 Residual-Guided Theory Growth(残差引导的理论生长)的基础。 但它本身不能保证每个问题都可解决,也不能保证任意增长过程收敛。有限模型的固定点定理与无限开放世界中的自主知识增长之间,还存在需要证明的距离。 它为 Residua 提供了什么?它提供了一条能够指导软件演化的原则: 新功能优先由现有结构组合得到;只有发现无法被已有结构吸收的真实缺口时,才考虑扩大核心。 例如,Residua 想增加一种新的 Actor 调度能力。 传统方式可能是新增专用的 Actor 指令、邮箱状态、调度原语和专门的失败处理逻辑。 MST-NF 的方式是先问:能否从已有计算核、状态转换、消息事件、准入规则及残差机制中组合出来? · 如果能够证明语义保持,就不需要把新功能加入可信核心。 · 如果不能,就必须指出究竟是哪一种行为无法表达。 这直接影响 Residua 的长期复杂度以及可信计算基底的规模。 五、第五层价值:通过结构压缩减少重复计算与重复建模 MST-NF 还提供了一个可以严格分析的效率来源:在执行之前缩小需要处理的候选空间。 假设: · N:原始请求数量; · Q:按照已证明安全的等价关系形成的不同结构类数量; · K:其中实际需要进一步处理的准入类数量。 在合适的模型中: K ≤ Q ≤ N 当多个原始对象属于同一个可安全复用的类,或者准入规则能够排除一部分候选对象时,需要处理的对象数就可能下降。 示意:1,000 个 Agent 计算请求 · 原始请求 N:1,000 · 安全去重后的结构类 Q:160 · 需要实际处理的准入类 K:120 (假设性例子,不是 Residua 的实测性能。是否可以安全去重以及真实执行次数,取决于语义条件、缓存实现和并发控制。) 这就是 QBE(Quotient Before Execution)的理论方向。 不过,workbench 的 Formal Backbone v0.6 也明确划定了边界:结构类数量减少,并不自动意味着真实运行时间更短。还必须考虑规范化、哈希、缓存查找、证明和通信的成本。 同样,重复请求得到相同结果,不等于有外部副作用的操作可以不加控制地执行多次。 因此,MST-NF 为 Residua 提供的是效率可改进的数学条件,而不是无条件加速保证。 六、把价值归结起来:MST-NF 到底给了 Residua 什么? · 独立语义角色及必要性反模型 → 可以论证为什么需要某些核心职责 · 商结构与因子分解条件 → QBE、内容身份、去重和结果复用 · Normal Form 与规范化定理 → 规范表示、共享比较及跨系统语义适配 · 准入与代表的关联约束 → 可检查的决策和结果合法性 · 具名残差与竭尽条件 → 明确失败边界、避免虚假闭合 · 残差引导的重分类 → 复用已有结构,控制新原语增长 · 组合与结构适配的研究框架 → 将不同应用纳入共同语义接口 · 可在 Lean 中检查的形式化定理 → 为 Residua 的实现和演化提供证明依据 我认为最值得注意的是最后两项。 因为 Residua 的终局目标不是成为另一种语法更简洁的函数语言,而是成为能够表达代码、证明、状态及其演化关系的共同基础设施。 MST-NF 如果能够持续证明不同领域实例之间的语义保持与结构复用,就可以减少 Residua 每进入一个新领域时必须重新建立的基础机制。 这里的价值是降低独立语义复杂度,不只是减少代码行数。 七、MST-NF 还不能为 Residua 保证什么? 为了判断它的理论价值,反而必须清楚知道它尚未解决的部分。 我查阅的 MST-NF v1.1 User Guide 把表达完备性明确限定为相对于指定契约和 profile 的结果,不是对所有数学理论、程序语言及计算模型的无条件表达完备证明。 此外,四角色执行模型并不能自动推出所有领域的安全性质。例如 workbench 的 MSTNecessityExecModelMWE.lean 明确给出了一个额外的安全条件 AtMostOneAdmit:四个执行结构角色本身不保证同一类中不会出现多个竞争性准入事件。 因此,MST-NF 目前不能单独替代: · R-CIC 的依赖类型逻辑及证明内核可靠性; · SCM 的精确执行语义、编译器及运行时实现; · AIR/STARK 的具体执行证明与密码学可靠性; · 分布式系统中的一致性、故障恢复及副作用安全协议。 这并不是说 MST-NF 没有价值,而是它的核心价值在规定可复用的结构义务,并在明确假设下证明它们之间的关系。 如果把它宣传成已经证明"所有理论本质同构",反而会削弱研究可信度。不同理论可能共享某个结构核,但不等于它们的全部语义已经被证明同构。 八、MST-NF 的真正研究价值,在于三种统一 ▸ 第一种:结构统一 找到多个看似不同的形式化对象之间可以共同表达的结构,并证明哪些区别属于表示差异,哪些区别具有独立语义内容。 ▸ 第二种:验证统一 将身份、准入、规范化和残差这些共同职责转化为可复用的证明接口,让新的系统实例无需重新发明所有基础验证条件。 ▸ 第三种:演化统一 将碰撞、反例、失败与残差转化为结构修正的输入,使系统扩展能够依据明确的证明义务进行,而不只是不断累积规则和补丁。 这三者结合起来,才是我理解的 MST-NF 最重要的方向。 它把原本分散在语义学、类型论、规约理论、数据库、增量计算和软件架构中的一些共同问题,放进统一的结构化研究框架。 但这些跨领域联系需要一个一个用实际定理和实例验证,不能靠命名统一代替数学证明。 九、对 Residua 最深远的影响 现在重新看我们讨论过的完整系统: Lean → SCM → Wasm → AIR → Proof 再加入 R-CIC、RCC、IEC。 这些组件各自都有明确功能,但它们为什么能够共同构成一个系统? 如果只是因为它们都在同一个仓库里,那是工程集成。 如果它们采用统一的对象身份、语义边界、准入依据、证明关系、规范化条件和残差处理机制,并且重要连接都有对应的形式化证明,那才是结构上的统一。 而 MST-NF 的价值,就是尝试给这种统一提供尽可能小的理论基础。 最终可以形成一种分工: MST-NF(结构基础)+ R-CIC(证明基础)+ SCM(计算基础) 再通过 Bootstrap、Wasm、AIR 和证明系统,使计算与证明可以实际执行、相互验证并在不同主体间传递。 这并不意味着 MST-NF 比 R-CIC 更强,或者可以代替它。它们位于不同的抽象层次。 MST-NF 规定什么样的结构值得构造、需要满足哪些共同义务;R-CIC 提供检查数学证明的逻辑机制;SCM 使这些结构成为真实的可执行计算。 最终结论 我认为,MST-NF 对 Residua 最大的贡献,可以概括为一句话: 它试图把"不断发明新的计算机制",转变为"从一个已知的最小结构基础中推导、组合和验证新的计算能力"。 如果未来这一研究路线获得更强的完备性、结构保真和跨领域复用证明,它的意义不只在于能让 Residua 更快、更安全或更容易扩展。 更深远的意义是:当我们需要一种新计算模型、新语言、新证明机制或新 Agent 能力时,首先不必假设它需要新的基础结构,而是可以先严格判断它能否从已有结构中导出。 这也是我认为 MST-NF 本身最值得追求的学术价值。 至于最终能达到多强的通用性,仍然需要证明,而不应预先视为既定事实。 对 Residua 而言,MST-NF 最值得保留的不是四个符号,而是这种以最小结构、形式化必要性、规范化和残差竭尽为核心的计算构造方法。
See More
mst
@cass2722
5 days ago
其实我也不知道怎么说清楚,让chatgpt自己看代码说 ------from ChatGPT----------------------- MST-NF 与 Residua:理论基础与计算实现 我的判断是:MST-NF 是 Residua 的结构理论基础,Residua 是 MST-NF 的计算实现与运行时载体。但两者并不等价,也不是简单的理论与产品关系。 最关键的结论有三个: ① Residua 在技术上可以脱离 MST-NF,继续作为一门语言、编译器和可验证执行系统存在。 ② 如果完全放弃 MST-NF 的结构约束,Residua 很可能失去其区别于普通语言、工作流引擎和可验证计算平台的核心设计方向。 ③ 更理想的终局不是让 Residua 永远依赖外部 MST-NF,而是让 MST-NF 的必要结构被内化为 Residua 的原生语义和验证规则。 我检查了仓库的架构文档、语言规格、运行时、QBE 和 NF 化设计。这里其实有一个重要区分:MST-NF 在 Residua 中既是设计原则,也已经对应了一部分真实的运行时机制,但并不是整个 SCM 解释器运行时必须调用的独立理论库。 一、从第一性原理看:它们是什么关系? ① Minimal Structure Theory(MST) 最小结构、表达与组合的理论目标 ↓ ② MST-NF 把结构表达、准入、规范表示与残差转化为可检查的约束 ↓ ③ Residua(SCM / Runtime) 将结构规则落实为可执行、可验证、可组合的计算 ↓ ④ Bootstrap / R-CIC / Wasm / AIR 自托管 · 形式化证明 · 可移植执行 · 可验证轨迹 ↓ ⑤ Agent Applications / Civilization Agent 决策、知识演化、可信协作及自治系统 这个关系并不是每层都能从上一层自动推出完整实现;其间还需要语义定义、细化证明和接口契约。 用一句话区分: · MST 关心:哪些结构足以表达目标理论与现象? · MST-NF 关心:怎样把这种结构表达变成可判定、可规范化和可检查的对象? · Residua 关心:怎样让机器实际执行这些结构,并在执行、组合和演化过程中维持规定的性质? 其中最大的跨越,是从数学结构到可执行系统。 MST-NF 自身并不天然提供编译器、持久化、网络、调度、执行环境或安全隔离。Residua 必须独立解决这些工程和语义问题。 二、MST-NF 在 Residua 中具体做了什么? 当前最明确的共用结构是: (q, a, σ, ρ) 根据 Residua 的 SPEC 和 ARCHITECTURE: · q|Quotient,商与内容身份|什么可以被视为相同,哪些计算可以共享 · a|Admissibility,准入|哪些输入、状态或转移可以被接受 · σ|Representative,规范代表|被接受的对象应以什么规范形式存在 · ρ|Residue,残差|未满足的条件、冲突与拒绝如何被明确表达 它们在 Residua 中并不只是四个字段,而是四类设计义务。 例如,一个 Agent 想更新共享知识: · q 确定知识对象的身份及可复用边界。 · a 判断新知识是否满足当前的准入规则。 · σ 给出可共享的规范结果。 · ρ 将未满足的条件作为明确残差保留下来,而不是静默接受或丢弃。 如果准入失败,系统不应该简单返回 false,更不应该将失败解释为任务已经完成。这一点与 Residua 的残差驱动计算是一致的。 但有个必须强调的数学边界: 内容哈希相同,首先证明的是被哈希的规范字节相同,而不是任意两个不同程序在语义上等价。 真正的语义 quotient、QBE 复用和保守扩展,都还需要各自的有效性条件或证明,不能单靠哈希获得。 三、MST-NF 目前已经进入 Residua 的哪些实际机制? 我从源码和设计中看到了四个比较重要的落点。 ▸ 计算语义与最小核心 lean/Residua/SlotSemanticsCore.lean 定义了语言的执行语义,SCM、Rust、TS 等实现围绕这一语义建立对应关系。 MST-NF 在这里发挥的是约束如何构造计算核心的作用:优先组合已有结构,尽量避免为每个应用增加独立原语,同时明确部分操作、拒绝和残差的处理方式。(来源:Residua SPEC) ▸ QBE:Quotient Before Execution src/residua/runtime/qbe_eval.py 将可复用的计算请求映射到内容身份,复用已有计算结果。 它利用的是纯函数计算和商类上的结果一致性。在当前实现中,主要针对规范编码相同的 (expr, env, programs) 请求,而不是任意语义等价程序。 因此,MST-NF 提供证明义务,Residua 提供实际的缓存、去重和分布式执行机制。(来源:qbe_eval.py) ▸ 准入与残差驱动演化 Residua 要求关键决策路径定义可检查的准入条件,并把失败归入具名残差,而不是通过临时条件分支静默处理。 ADR_NF_CENSUS 进一步区分了已经采用 NF 结构的可信决策,以及虽有测试、但仍使用 ad-hoc 判定的部分。 这说明 MST-NF 不是单纯给已有代码加形式化注释,而是被用来约束系统应该怎样演化。(来源:ADR_NF_CENSUS) ▸ Code / Proof / State Graph MST-NF 的共同结构使不同领域的对象可以采用一致的身份、准入、规范化及残差处理纪律。 Residua 的 COG、RCC、IEC 等进一步将这些机制用于证明依赖、变更失效、恢复和权威选择。 这些应用的领域语义并不相同,因此仍需要分别证明其正确性,不能仅凭共享四元组就宣称完全同构。 我认为最后这一点最有战略价值:MST-NF 提供共同的结构接口,Residua 负责把不同计算和治理实例连接为可以互相消费证据的系统。 四、如果 Residua 离开 MST-NF,会发生什么? 这个问题需要区分三种情况: ▸ 不再使用 MST-NF 名称或外部理论仓库 · 能否继续工作:原则上可以 · 影响:很多运行功能不一定受影响 ▸ 保留四角色及其定理,但换成另一套形式化基础 · 能否继续工作:可以,有验证成本 · 影响:需要重新建立语义和证明对应关系 ▸ 完全移除 MST-NF 的结构约束和相关机制 · 能否继续工作:仍可构建运行系统 · 影响:原有的统一准入、规范化及残差演化性质不再自动成立 其中第三种最值得思考。 假设把 Residua 的 MST-NF 设计全部剥离,只留下 SCM 语言及编译链: SCM → Wasm → AIR → STARK 同时保留 R-CIC。 那么 Residua 仍然可以成为一种有形式化类型系统和证明检查能力的可验证计算平台。它依然可能拥有自举编译器、计算正确性证明、可验证执行以及证明传递等能力。 这些技术在逻辑上并不要求必须使用 MST-NF。例如,R-CIC 的可靠性来自其逻辑规则和元理论,而不是因为它采用了 q/a/σ/ρ 的命名体系。 但是,没有 MST-NF 或一个等价的结构化框架,Residua 需要重新解决另一个问题: 如何让计算、证明、状态、准入、恢复和演化不是各自独立设计的六套系统,而是共享一个经过证明的结构基础? 如果不能解决,那么 Residua 的复杂度可能随功能数量持续增长:每个新模块都要自行定义身份、准入逻辑、错误处理、状态规范化及证明组合方式。 这正是 MST-NF 希望避免的架构问题。 五、但 MST-NF 真的已经证明自己不可替代了吗? 这里需要严格区分数学定理的范围。 我进一步检查了 codex-proof-workbench 的 MST-NF 理论材料。 其中 MST Minimality Role Basis 明确说明:四角色的最小性是在"相互独立、可诊断的语义职责"意义上建立的,不是证明任何其他形式的计算模型都不可能使用更少的符号、类型或结构。 相关的 Necessity Role Ablation 则通过四个反模型证明:在其定义的执行模型内,分别移除四种职责,会破坏相应的语义性质。 这是有价值的数学结果,但不能直接跳到: 任何可信计算系统 ⇒ 必须使用 MST-NF 这个更强的全称命题。 同样,MST-NF v1.1 的 Lean API 包含多层 NF、规范化和完备性相关构造,但文档中的完备性包含相对于特定契约及 profile 的条件,不能无条件扩展为对任何程序语言和证明系统的完整表达能力。 因此,我认为对 Residua 更有价值的论证不是宣称"没有 MST-NF 就不可能建立 Residua",而是要证明: 在相同可信计算要求下,采用 MST-NF 是否能系统性地减少独立语义机制、重复证明义务、可信基础规模和演化成本? 这才是可检验、也更难被竞争系统复制的技术价值。 六、我认为应该怎样调整它们的长期关系? 我不建议把 MST-NF 固定成一个 Residua 永远不能改变的外部依赖。更好的架构是: ① MST / MST-NF 理论层 必要性 · 充分性 · 规范化 · 组合定理 ↓ ② Residua Native Semantic Core 原生实现最小结构及其可检查语义 ↓ ③ 三个并列方向: · Computation:SCM · Wasm · QBE · Proof:R-CIC · AIR · STARK · Verified Evolution:COG · RCC · IEC · Agent 协作和演化 这意味着 MST-NF 的语义结构进入 Residua 的原生核心,而具体的理论表示仍可以独立发展。 同时,R-CIC 保持逻辑上的独立性:它可以检查与 MST-NF 有关的证明,也可以检查不属于 MST-NF 的数学定理。 这样能够避免两种极端:一方面,不让 Residua 退化成由大量互不关联功能组成的普通平台;另一方面,也不让 MST-NF 成为所有新功能必须额外经过的形式主义负担。 特别是对你提出的 Agent Civilization 目标而言,我认为真正必要的是:每一个对外产生权威判断的组件,都能够明确自身的身份、准入依据、结果表示、未完成义务以及可重验证证据。 它们是否全部直接实例化同一个四元组数据类型,是次要问题。 七、怎样检验 MST-NF 对 Residua 的真实价值? 我建议做一项严格的 MST-NF Ablation(消融)研究,而不是再增加一篇抽象理论讨论。 选择同一个非平凡场景,比如 Agent 工作流中的状态变更、并发冲突或证明依赖更新。 构造两种可比较实现: · A:按照 MST-NF 的结构规则建立实例。 · B:使用同样的 SCM/Wasm、证明工具和资源预算,但不强制 MST-NF 结构纪律。 比较两者的实际结果: · Trusted Computing Base:哪种实现需要信任的核心更小? · Proof obligations:哪种方案需要重复证明的独立性质更少? · Semantic drift:哪种方案在演化后出现的语义偏移更少? · Residue coverage:哪种方案能更完整地识别和保留失败状态? · Change propagation:修改一个对象需要重新检查多大范围? · Execution efficiency:QBE 和结构共享实际节约了多少计算? · Extension cost:新增一种 Agent 能力需要多少新增机制? 这里需要控制公平性:两种实现必须满足相同的正确性要求。不能让基线实现忽略审计、安全和残差条件,再宣称 MST-NF 的优势已经被证明。 如果 MST-NF 方案显著减少复杂度,同时保持甚至改善计算性能和可验证性,就得到了一种真正有说服力的证据。 八、最终判断:Residua 是否应该离开 MST-NF? 我给出的答案是: 可以摆脱对 MST-NF 作为外部实现组件的依赖,但不应在没有更强替代结构之前,放弃 MST-NF 所定义的核心语义职责。 从整个研究计划看: MST-NF ──原生实现──→ Residua ──自举与验证──→ 可信计算基础设施 更长远的目标是让这个关系反过来也能成立: Residua ──形式化表达与验证──→ MST-NF 的实例与定理 也就是说,未来的 Residua 不只是 MST-NF 理论的使用者,还能在自己的计算和证明体系内表达、验证并继续发展相关理论。 但这要求先完成非循环的语义及可靠性桥梁,不能把自举固定点当成理论自证。 最终,我认为应该追求的不是: "Residua 必须依赖 MST-NF 才能存在。" 而是: "MST-NF 为 Residua 提供可论证的最小结构基础;Residua 则让这一结构具有真实计算能力、可验证性和自主演化能力。" 两者能够独立存在,但结合之后,才有机会形成你一直追求的那种以最小结构统一计算、证明和演化的系统。 这也引出一个更深的问题:MST-NF 究竟只是 Residua 的架构方法,还是可以真正成为一种通用计算模型的语义基础?我认为这应当是下一阶段最值得严格证明或证伪的核心命题。
See More
mst
@cass2722
5 days ago
其实没CIC也能自举,但是意义不一样: -------from ChatGPT------------ R-CIC:Residua 的原生证明内核 R-CIC 是 Residua 这条自举链中最重要的组成部分之一。它的意义甚至比 AIR、ZK 更基础:R-CIC 使 Residua 不仅能够执行计算、证明执行过程,还能够在自己的体系内表达、检查和维护关于计算正确性的数学证明。 如果说: · SCM 解决"怎样计算"; · Wasm 解决"在哪里、怎样执行"; · AIR / ZK 解决"怎样向别人证明计算确实按规则执行"; 那么,R-CIC 解决的是更深一层的问题:这些规则和程序所声称的性质为什么成立? 我核对了 Residua 仓库中的 R-CIC 规格和自举设计。仓库实际上已经把这一点写进架构:R-CIC 不是自举链末尾增加的第六个编译阶段,而是贯穿 SCM、Wasm、AIR 和证明准入体系的原生证明内核。 一、R-CIC 应当放在哪里? 我建议这样理解完整架构: ① Lean:Genesis / 外部证明起点 最初的语义、内核可靠性及实现正确性证明 ↓ ② R-CIC:Residua 原生证明内核 类型 · 命题 · 证明项 · 证明检查 · 正确性契约 ↓ ③ SCM:原生通用计算模型 R-CIC 检查器本身也由 SCM 实现并运行 ↓ ④ Wasm:可移植执行层 执行 SCM 程序及 R-CIC 证明检查器 ↓ ⑤ AIR:执行关系的代数表示 检查 Wasm 执行是否满足指定的状态转移规则 ↓ ⑥ STARK / SNARK:可选密码学证明层 远程高效验证;按需附加零知识隐私性质 这张图展示逻辑依赖与实现承载关系,并不是要求 R-CIC 在运行时先于 SCM 执行。R-CIC 的检查算法在 SCM 中实现,其正确性必须有独立的证明依据。 仓库的 R-CIC Specification 明确把目标定义为:在 SCM 内建立 Lean 风格的依赖类型证明内核,用于证明和维护精确 SCM 程序的正确性声明。 这与仅仅把 Lean 的证明结果附在 SCM 代码旁边,有根本区别。 二、R-CIC 与 AIR 究竟有什么区别? 考虑一个 Agent 执行转账操作。我们希望满足两个条件: 条件 A:执行正确。 程序收到转账指令后,实际执行的每一步都符合程序语义。AIR 可以对这一点提供执行轨迹约束。 条件 B:程序本身满足安全性质。例如: ∀s, a. Authorized(s, a) ∧ Invariant(s) ⇒ Invariant(Transfer(s, a)) 即在授权条件和前置不变量成立时,转账后仍保持资产安全不变量。这个性质需要逻辑表达、证明以及可靠的证明检查机制。 R-CIC 正是为第二件事提供基础。 ▸ 程序是否满足某个形式化安全性质? · R-CIC:可以检查相应证明 · AIR / ZK:不能仅凭执行证明直接推出 ▸ 一次具体执行是否符合机器语义? · R-CIC:可以用于证明相关通用定理 · AIR / ZK:AIR 直接约束这次执行 ▸ 编译器是否保持源程序语义? · R-CIC:可以检查语义保持证明 · AIR / ZK:可以证明某次编译执行符合给定程序 ▸ 多个程序组合后性质是否成立? · R-CIC:可以检查组合证明 · AIR / ZK:可以组合执行证明,但还需语义桥梁 ▸ 第三方能否低成本验证长计算? · R-CIC:通常不是它的主要优势 · AIR / ZK:简洁证明系统擅长这一点 最关键的区分: R-CIC 证明命题 P: Γ ⊢ p : P AIR / Proof 验证具体执行: VerifyExec(C, x, y, π) 这是两种不同的判断。 AIR 证明某次执行遵循既定规则;R-CIC 可以证明规则及程序性质所需要的数学定理。 但 R-CIC 也不是万能的:它只能检查已经精确定义并附有有效证明的性质,不能凭空保证自然语言中所有的"正确性"。 三、R-CIC 让 Residua 拥有第二种自举能力 这是我认为整个架构最值得重视的部分。Residua 实际上需要实现两个不同的固定点。 FP_gen:生成固定点(Bootstrap) Cₙ₊₁ = Compile(Cₙ, S) C₂ = C₃ 编译器可以自主再生,且完整规范化产物达到稳定。 FP_auth:证明权威固定点(R-CIC) · K₀ 验证 A₁ · A₁ 生成、验证并激活 A₂ · A₂ 生成、验证并激活 A₃ · A₂、A₃ 达到规定的证明权威固定点 证明检查器及其准入权威由受认可的前代验证,最终实现原生证明权威交接。 这不是我另外发明的一套固定点。仓库的 10_AUTHORITY_HANDOFF.md 已经明确规定了: · FP_gen:Generation self-hosting · FP_auth:Proof-authority self-hosting · H_G / H_P / H_A:生成权威、证明准入权威和当前生效权威的交接 因此,从架构上讲: Bootstrap 让 Residua 能够自己生产自己。R-CIC 让 Residua 能够使用自己的证明内核检查并维护其数学正确性声明。 两者必须结合,但也不能互相冒充。 一个能够无限重复生成自身的编译器,不一定正确。 同样,一个能够检查自己的证明项的内核,也不能仅凭自检就建立自身的可靠性。这里仍需要独立的元理论论证,以及最初由 Lean 验证的可信基础。 四、真正的端到端目标:程序携带数学证明,执行携带执行证明 完整系统应该允许 Agent 提交一个程序 P,同时提供一个形式化正确性声明 Q(P) 和证明项 p。 R-CIC 进行检查: Γ ⊢ p : Q(P) 如果检查通过,并且依赖的内核可靠性、逻辑假设及程序语义桥梁成立,就获得关于程序的静态保证。 接下来,SCM 编译为 Wasm: P_SCM ──Compile──→ P_Wasm 语义保持定理确保编译没有改变程序的规定行为。 Wasm 运行 P_Wasm,产生输出和执行轨迹。AIR 检查轨迹,而密码学证明系统可以提供简洁执行证明。 这时,第三方实际获得两种不同的保证: · R-CIC 证明:这个程序满足哪些经过形式化定义的性质? · AIR / STARK 执行证明:这次执行是否按照该程序的规定语义进行? 还必须把二者绑定到同一个确切的程序、语义版本与输入输出对象。 其组合推理链可以写成: VerifyProof(π_exec) = 1 ⇓ 证明系统可靠性 WasmRun(R-CIC checker) = accept ⇓ Wasm/SCM 语义保持 R-CICCheck(Γ, p, Q) = accept ⇓ R-CIC 内核可靠性 Γ ⊢ p : Q 这里每一个向下的箭头都是独立的证明义务。特别是最后的内核可靠性不能靠这个内核对自身作一次检查来建立。 这条思路已经在仓库的 11_SUCCINCT_PROOFS.md 中有所体现。 它的设计很有价值:R-CIC 证明检查、SCM 证书检查、编译器执行、普通程序执行以及权威交接,都可以通过统一的 Wasm 执行关系,加上各自的语义适配器进行验证。 这样就不必为每一种证明判断重新发明一套 AIR 或 ZK 系统。 五、从 MST-NF 出发,R-CIC 的深层意义是什么? 这里还要区分三个层次: · MST-NF|结构与规约基础|怎样用更小的结构表达和组合计算? · SCM|执行语义与计算模型|计算如何实际进行? · R-CIC|逻辑、类型与证明内核|哪些性质可以被严格表达并证明? 我认为 Residua 的终局不是让 R-CIC 取代 MST-NF,也不是把 SCM 改造成 Lean。 而是建立两种互相联结、但保持边界清晰的原生能力: Computation + Proof 它们共同使用内容身份、依赖关系、残差和执行证据,但逻辑上的证明判断不能简单等同于计算规约。 这就连接到了你之前提出的:Code / Prove is Graph。 在 Residua 的 Certified Object Graph(COG)中,代码、类型、证明、契约、编译产物、执行记录和权威凭证都可以成为具有精确身份及依赖关系的对象。 比如,当一个程序的定义改变: · COG 可以识别与其相关的证明、编译和执行依赖。 · R-CIC 负责重新检查受到影响的形式化证明。 · RCC 负责失效传播与重验证等恢复过程。 · IEC 负责当前权威实例的选择和准入,而不是决定数学定理真假。 这些分工也符合仓库的 09_CERTIFIED_OBJECT_GRAPH.md。 这会使增量验证、证明复用和 Agent 间的可信协作成为可构建的系统能力,而不仅仅是设计口号。 六、当前 Residua 走到哪里了? 需要明确区分架构目标与已经闭合的证明。 本次核对的 main 规格仍然保留:NativeRCICClosed = 0(尚未满足闭合条件)。 仓库的 ADR_CIC_FULL_ADOPTION 已经决定让 in-SCM kernel 朝检查 Lean 导出证明的完整目标演化,但并不意味着这个目标已经实现。 此外,R-CIC-0 的原生理论闭合与完整 Lean 导出兼容性是两项独立判据,不能把一个片段的成功误报为两者全部完成。 实际还需要完成的关键桥梁包括: · 真实 R-CIC 证明检查的接受路径 · 证明与精确 SCM 契约的绑定 · SCM/Wasm 的语义保持关系 · AIR 证明到类型判断的可靠性投影 仓库现有 rcic-cert-check 入口仍记录了拒绝式骨架和未完成的证明项检查连接。 尤其重要的是,你们正在研究的 R-CIC 转换刻画、Π 单射、subject reduction 及相关循环性问题,不属于可以用 AIR 或 ZK 绕过去的工程细节。只要它们对目标证明内核的可靠性承担必要职责,就必须真正完成证明,或者严格收缩所声称支持的理论范围。 所以,R-CIC 不能因为 Bootstrap 先闭合就被宣称闭合;Bootstrap 也不应该因 R-CIC 尚未闭合而被迫重复构建另一套 R-CIC 语义。 七、我建议的下一步融合方向 不应把 R-CIC 简单地接在 Lean 与 SCM 中间,造成另一套独立编译器。 应当让 R-CIC 成为一个使用 SCM 编写、通过同一条 Bootstrap 工具链编译和执行的原生检查器。 下一项最有价值的端到端验收,是让一条非空洞的真实 R-CIC 证明判断走完整条链: 一个真实 SCM 程序的正确性命题 ↓ R-CIC 检查真实证明项 ↓ 检查器由 SCM 编写并编译成 Wasm ↓ Wasm 真实执行检查器 ↓ AIR 验证执行轨迹 ↓ 独立验证者确认绑定的判断结果 这次验收既要接受一个真实有效的证明,也要拒绝错误的证明项、错误的命题身份和被篡改的执行轨迹。所有结果必须来自真实执行和独立检查,不能通过预置答案形成空洞闭合。 这将是 R-CIC 与 Bootstrap 两条研究线真正相交的节点。 我的最终判断 从 Residua 的长期演化看,可以把整套架构归结为三种主权: · 计算主权:SCM + Bootstrap,使 Agent 不依赖外部编译器来构建自己的计算系统。 · 证明主权:R-CIC,使 Agent 在原生计算体系内检查和维护其形式化证明。 · 验证自主性:Wasm + AIR + 密码学证明,使其他 Agent 能够独立验证执行,而无需信任执行者。 三者共同构成一个比单纯"可信执行"更深的目标。 没有 R-CIC,Residua 仍有机会成为优秀的可验证计算平台;但加入并真正闭合 R-CIC,才有机会让 Residua 成为同时原生支持代码、数学证明及可验证执行的计算基础设施。 我认为,这才是 R-CIC 在整个 Residua 体系中最核心、也最值得继续攻坚的意义。
See More
mst
@cass2722
5 days ago
R-CIC(Residua Calculus of Inductive Constructions)才是AI 挖的一个大坑,做之前我本预计一周(weekly quota)烧完能完成,毕竟lean4lean这些理论和实践已经在前,做的过程才发现lean4lean的内核三行居然还是猜想,只能自己去撞(现在已经17万行lean了):
mst
@cass2722
5 days ago
从python -> ts -> rust -> gleam -> lean。开始只是不信任AI写的代码,然后试图加入强类型, 到纯函语言(用gleam是为了otp和js兼容),到lean做形式化验证,然后走到lean->scm->wasm->air->zk,AI才是架构师,一路挖的坑,现在填满了。 ------ ChatGPT Pro ------ Lean → SCM → Wasm → AIR → ZK:这条链的真正意义 我认为,Lean → SCM → Wasm → AIR → ZK 这条链的真正意义,不是构建一条更长的编译流水线,而是让 Residua 从"被外部系统证明正确的程序",演化成"能够自主构建、执行、证明和验证自身计算的系统"。 从第一性原理出发,这涉及计算机科学中三个不同的问题: 1. 什么是正确的计算? 2. 如何确保真实执行符合正确的计算定义? 3. 如何让不信任执行者的第三方验证计算结果? 这条链的每一层,正好分别承担其中的一部分。 一、五个阶段分别解决什么问题? Lean:定义什么是正确的 形式化语义 · 内核正确性 · 初始可信种子 ↓ 语义保持 / Genesis SCM:用 Residua 自己的计算模型表达和构建 最小计算核心 · 自托管 · 残差语义 ↓ 编译 / Refinement Wasm:让计算实际运行 可移植执行 · 受约束的机器语义 · 状态转换 ↓ 执行轨迹 / 约束编码 AIR:验证计算过程 状态转移约束 · 轨迹检查 · 执行证据 ↓ 证明系统 / 可选零知识化 ZK:让其他主体高效验证而不必重算 简洁证明 · 可选隐私 · 跨主体信任 这里的 ZK 严格指零知识性质,而简洁验证是 SNARK/STARK 等证明系统的另一项性质。简洁证明并不自动意味着零知识。 这条链可以用一句话概括: Lean 给出可信起点,SCM 获得计算主权,Wasm 提供执行载体,AIR 建立可验证执行关系,密码学证明系统把这种验证能力扩展给不信任计算者的其他主体。 二、真正的核心是两次信任转移 第一次:Lean → SCM,从依赖外部证明者到自托管 在传统形式化验证架构中: Program ──(Lean)──→ Correctness 程序可以被证明正确,但证明权威始终依赖 Lean。 Residua 希望做到更进一步: Lean ──(verified genesis)──→ SCM Kernel 随后 SCM Kernel 能自行检查其接受的证明,并运行自己的编译器。 当编译器可以重新生成自身时: Cₙ₊₁ = Compile(Cₙ, S) 最终达到固定点: Cₙ₊₁ = Cₙ 这里是规范化完整编译产物的字节级固定点,而不是仅仅行为相似。 但固定点本身不能证明正确性;还需要语义保持定理、可靠的内核和真实执行证据。 这一阶段最重要的成果不是生成了 Wasm,而是 Residua 不再需要每次由 Lean 来决定自己的正式构建是否有效。 Lean 可以保留为独立审计者,但不再是日常生成路径的权威。 第二次:Wasm → AIR → Proof,从信任执行者到验证执行 假设 Agent A 为 Agent B 执行一项任务。 传统架构中,Agent B 拿到: (input, output) 它不知道 Agent A 有没有跳过计算、使用错误的程序或伪造结果。 Residua 可以要求 Agent A 提供: (P, I, O, π) 其中: · P 是确定身份的程序 · I 是输入 · O 是输出 · π 是执行正确性的证明 Agent B 只需要验证: Verify(P, I, O, π) = true 就能在证明系统的可靠性假设下确认: O = ⟦P⟧(I) 不必信任 Agent A 的声明。 这里最关键的变化是: 信任对象从"谁执行了计算"转移到"验证规则和证明是否成立"。 这是构建 Agent Civilization 的一个重要技术基础。 三、这为什么比普通的自举编译器有意义? 传统自举编译器主要追求: Compile(C, S) = C 也就是编译器能够编译自身。 Residua 追求的是更强的结构,三者缺一不可: · 自举固定点:Compile(C, S) = C · 执行正确性:VerifyExecution(C, S, C, π) · 验证机制可靠性:Sound(VerifyExecution) 这意味着可以同时获得三种不同能力: · Self-hosting:自己构建自己 · Self-verifying:使用经过可靠性论证的机制,验证自身构建过程 · Proof-carrying computation:把执行正确性的证据交给其他主体验证 但要注意:自验证不等于完全无信任。至少仍然依赖最小可信验证器、其语义和密码学假设。自举也不能自动排除编译器后门。 四、站在 MST-NF 的角度,链条中哪一部分最有价值? 我认为不是 Wasm,也不是 AIR 或 ZK。 真正可能构成 Residua 独特价值的是: 把计算、证明、残差和状态转移还原成一个更小的共同结构。 例如,将计算定义为: C : S → S + R 其中 S 表示计算状态,R 表示具名残差。这个式子只是简化的抽象形式,并不是对现有 SCM 完整语义的替代。 然后建立共同的有效性关系: ℛ(P, I, T, O) 表示程序 P 从输入 I 出发,经过执行轨迹 T,得到输出 O,且满足对应语义。 在这一关系之上: · SCM 是一种计算表示 · Wasm 是一种执行实现 · AIR 是一种代数化验证表示 · ZK 是一种可选的证明分发与隐私机制 · Lean 是语义可靠性的形式化证明工具 关键不在于让五层彼此同构(它们具有不同职责,未必同构),而是证明各自的映射保留同一个计算意义。 这更符合 MST-NF 的路线:以最小结构为基础,通过组合和推导获得越来越丰富的能力,而不是让每种新技术成为新的基础公理。 五、对于 Agent Civilization,这意味着什么? 假设未来有大量自治 Agent,它们彼此不完全信任,也不依赖一个中心化平台为每次执行背书。 一个 Agent 发布代码,另一个 Agent 执行,第三个 Agent 审计,第四个 Agent 继续消费结果。 如果每次交互都只能依赖执行者的声誉、日志和 API 返回值,那么系统规模越大,信任关系就越复杂。 而可验证执行允许它们交换的是: Code + State + Result + Proof 于是可能导出: · 跨 Agent 可信委托:无需信任执行者的全部运行环境 · 可验证升级:新版本可携带构建与迁移证据 · 可组合的计算证明:后续 Agent 可以引用并验证前一阶段已证明的结果 · 分布式计算:将昂贵执行与相对便宜的验证分离 · 有条件的隐私协作:通过真正的零知识协议证明结果,而不公开私有输入 但这些能力仍需要具体协议、证明组合定理、身份绑定和状态一致性机制,不是单靠自举链即可自动实现。 六、我对 Residua 这条路线的架构判断 仓库的 Bootstrap Plan 有一项值得保留的要求:每一代自举产物必须由前一代验证,并且最终的验证器自身也要进入固定点 bundle。 这个要求抓住了问题的本质。 不过,长期来说不应把这条路线理解为五个不可替代的技术层,而应当分成两条相互关联的链: 计算与自托管链: Lean Genesis → SCM → Wasm 执行验证与证明链: Execution Relation → AIR / Other CS → Proof 两条链通过语义保持、执行可靠性和证明系统可靠性定理连接。 在这种设计里,SCM 的原生计算和自举能力是基础,AIR 与 ZK 是可替换、可演化的验证和密码学能力。这不意味着当前已经可以删掉 AIR:现有 Bootstrap Spec 将它规定为阶段准入的一部分,改变这一点必须同时调整验证契约。 七、最终意义 我认为这条链的终局可以分为三个层次: 第一层:计算自主 Residua 可以表达并执行通用计算,构建自己的工具链。 第二层:计算可信 系统可以对自己的构建与执行产生可独立检查的正确性证据。 第三层:信任可组合 不同 Agent 可以基于已验证的计算结果开展协作,而不必共享同一个执行权威。 所以,Lean → SCM → Wasm → AIR → ZK 的最大意义,不是证明 Residua 能使用五种技术,而是建立一条从形式化语义到自主执行,再到第三方可验证计算的信任路径。 如果 Residua 最终做到了这一点,它就不仅是一门语言或编译器,而有机会成为一种 Proof-Native Computing Infrastructure(证明原生计算基础设施)。 对你一直强调的 For Agents, By Agents 而言,这才是我认为值得投入的终局:Agent 不只是能够生成和运行代码,还能够彼此验证计算、继承证明,并在没有共同执行者的情况下形成可信协作。
See More
Last Seen Users on Sotwe
StwToge
Seen from
Norway
ام هيثم
Seen from
Austria
imo video call sex
nigde kgn46
Seen from
Turkey
Hanna
Seen from
United Arab Emirates
Türk Porno Merkezi💥🔥
Seen from
Turkey
Enes Ulu
Seen from
Turkey
Gizli ve Arzu 🩷
Seen from
Germany
CansuGökhan cuckold35
Seen from
Turkey
Pipili Okşan
Seen from
Turkey
Trends for you
1
Michigan
Under 10K tweets
2
#UFC333
Under 10K tweets
3
Jason Beck
Under 10K tweets
4
Texas Tech
Under 10K tweets
5
Chelsea
Under 10K tweets
6
Malachi Toney
Under 10K tweets
7
Tommy Carr
Under 10K tweets
8
Kavanagh
Under 10K tweets
9
#COYS
Under 10K tweets
10
Palmer
Under 10K tweets
Most Popular Users
1
Elon Musk
@elonmusk
241.5M followers
2
Barack Obama
@barackobama
118.8M followers
3
Cristiano Ronaldo
@cristiano
114.5M followers
4
Donald J. Trump
@realdonaldtrump
111.8M followers
5
Narendra Modi
@narendramodi
107.1M followers
6
Rihanna
@rihanna
98.7M followers
7
NASA
@nasa
92.3M followers
8
Justin Bieber
@justinbieber
91.8M followers
9
KATY PERRY
@katyperry
90M followers
10
Taylor Swift
@taylorswift13
84M followers
11
Lady Gaga
@ladygaga
75.5M followers
12
Virat Kohli
@imvkohli
73.5M followers
13
Kim Kardashian
@kimkardashian
70.9M followers
14
YouTube
@youtube
68.8M followers
15
Neymar Jr
@neymarjr
66.5M followers
16
Bill Gates
@billgates
65.3M followers
17
Selena Gomez
@selenagomez
63.1M followers
18
The Ellen Show
@theellenshow
62.2M followers
19
CNN
@cnn
61.7M followers
20
X
@x
60.7M followers
Olivia
Online
✨
⭐
💫