Home
Language
English
Türkçe
Bahasa Indonesia
About
Privacy Policy
Terms of Service
Pricing
Sign In
Download All
Share
Koavc.
@chan_tre
随便看看 ✈️时用
0.01km
Joined January 2020
589
Following
209
Followers
331
Posts
Koavc.
@chan_tre
about 18 hours ago
@aishang50486953
@Danieland3P
😍 再拍点什么坐上来自己动,镜子前踩着头操的姿势就更棒了
chan_tre
retweeted
巨巨Flynn—海南
@aishang50486953
4 months ago
“就是这个点你的b特别软” “有没有顶到” “嗯” “骚b” 粉丝
@Danieland3P
的b被我摩擦到外翻停不下来,在东门奈雪的茶见面时很正经一男的,怎么叫床这么厉害 (带上耳机🎧观感更佳)
aishang50486953's tweet video.
chan_tre
retweeted
Ethan 恩宇
@UPing123zzz
about 20 hours ago
现在 AI 圈有一个特别离谱的现象。 一大堆人天天研究 Agent、MCP、RAG、Workflow、Harness,收藏了几百个 GitHub 开源项目,甚至已经开始做所谓的企业级 AI 系统。 结果你让他解释一下,一条数据究竟是怎么从业务系统进入数据库、经过清洗处理,再被模型检索和调用的,他可能根本讲不清楚。 我操,这其实是一个非常严重的问题。 因为你会发现,很多人以为自己在学习 AI 工程,实际上只是不断学习怎么调用别人封装好的工具。 一旦脱离框架,面对真正复杂的业务系统,连最基本的数据流转关系都不理解。 这张图非常值得仔细研究。它把 AWS、Azure、GCP 三家云平台的数据工程架构放在一起,看起来密密麻麻几十种云服务,但仔细研究之后,你会发现一个特别有意思的现象: 无论云厂商给产品起什么名字,底层要解决的工程问题其实高度相似。 从数据采集、数据存储、数据处理,到数仓和湖仓分析,最后再到 BI 展示和业务应用。 这其实就是企业数据系统最核心的一条链路。 比如 AWS,你会看到 Kinesis、S3、Glue、Redshift、Athena、QuickSight。 Azure 有 Event Hubs、Data Lake Storage、Databricks、Synapse、Fabric、Power BI。 GCP 则有 Pub/Sub、Cloud Storage、Dataflow、Dataproc、BigQuery、Looker。 这些产品不能简单地一一对应,能力边界和架构选择也存在差异。 但它们背后解决的问题是类似的。 企业的数据究竟从哪里来?如何可靠地采集?存储在哪里?怎样清洗、转换和组织?如何保证数据质量?最后又怎么把处理过的数据提供给分析系统和实际业务? 你真正应该理解的是这些问题,而不是死记硬背几十个云产品的名字。 我发现现在很多 AI 开发者特别容易忽略一个事实:大模型能力再强,它也无法凭空知道一家企业内部正在发生什么。 你想做一个企业销售 Agent,让它分析过去三个月的客户转化率。 那它首先需要访问可靠的业务数据。客户数据在哪里?订单数据在哪里?多个系统的数据���样关联?不同部门的指标口径是不是一致?数据多久同步一次? 如果这些问题都没有解决,你换成再先进的大模型,也只能在不完整的数据基础上生成答案。 再比如 RAG。现在很多教程教你做企业知识库,就是上传 PDF、切分 Chunk、生成 Embedding、存入向量数据库、检索上下文,再让 LLM 回答。 看起来非常简单。但真正在企业环境里部署之后,你会发现问题根本没有这么简单。 同一份文档更新了三个版本,检索系统应该使用哪个? 业务数据库更新了,知识库什么时候同步? 某个员工没有权限查看的文件,为什么还能被 Agent 检索出来? 数据库和向量索引出现不一致怎么办? 数据同步中断了,应该从哪里恢复? 这他妈根本不是多写两句 Prompt、调高 Top-K,或者换一个 Embedding 模型就能解决的。 你必须开始理解数据采集、CDC、ETL/ELT、数据管道、索引更新、权限隔离和质量校验。 而这些东西,本质上都是数据工程需要解决的问题。 这也是为什么我认为,未来真正有竞争力的 AI 工程师,绝对不能只懂模型。 尤其是 FDE。因为企业根本不关心你今天又收藏了哪个开源框架,也不关心你用了多少个 Skill、多少个 Agent。 客户关心的是:我的数据能不能安全地接进来? 系统能不能持续更新? 业务流程能不能自动执行? 结果出错之后能不能定位问题? 部署之后究竟能不能长期稳定地使用? 而要解决这些问题,就必须从单纯的模型调用,进入完整的软件工程和数据工程领域。 但这里还有一个特别容易走偏的地方。 懂架构,不代表你应该把所有复杂架构都用一遍。 有些人看完这张图,立刻就想给自己的项目部署数据湖、数据仓库、实时数据管道、Kafka、Spark、Kubernetes��� 结果一个只有几十个用户的小应用,最后搞出了一套维护成本比业务本身还高的系统。 这也是一种技术上的自我感动。 如果一台服务器、PostgreSQL、对象存储和几个后台任务就能解决问题,为什么非要搭一套大型分布式架构? 反过来,如果你面对的是多业务系统、持续增长的数据量、严格的权限要求和复杂的数据分析场景,那就需要认真评估更完善的数据平台。 真正的架构能力,不是你会使用多少技术,而是你能判断什么时候不应该使用某项技术。 我越来越觉得,AI 时代正在发生一件很有意思的事情。 以前开发者需要花大量时间学习如何编写具体代码。 现在 AI 编程工具正在快速降低这部分工作的成本。 你可以让模型帮你写 API、生成 SQL、配置 Docker,甚至辅助部署整个服务。 但它也把一个更现实的问题摆到了开发者面前:当代码越来越容易生成的时候,你的核心价值究��是什么? 我认为至少有一部分答案,就是理解真实业务、拆解复杂问题、设计合理架构,以及判断一套系统能否可靠地运行。 你可以让 AI 生成一条数据处理管道,但你必须知道数据为什么这样流动。 你可以让 AI 编写数据库查询,但你必须理解数据模型和业务口径。 你可以让 AI 创建一个 RAG 系统,但你必须知道什么时候检索结果是不可信的。 你甚至可以让 AI 帮你把应用部署到 AWS、Azure 或 GCP。 但你仍然需要理解成本、权限、可观测性、故障恢复,以及每个架构选择背后的取舍。 AI 可以极大地降低系统实现的成本,但不会自动消除真实世界的工程复杂性。 所以我觉得,真正想进入 AI 工程、FDE、Agent 开发这些领域的年轻人,应该逐渐调整自己的学习方式。 少一点对新框架的盲目追逐,多一点对底层工程问题的深入理解。 不要只研究怎么让模型回答问题,还要研究模型回答所依赖的数据从哪里来。 不要只研究怎么让 Agent 调用工具,还要研究工具背后的 API、数据库和业务流程是怎么运转的。 不要只研究怎么把 Demo 跑通,还要研究怎样把一个系统稳定地交付出去。 因为未来模型会继续变强,框架会不断更新,云平台也会推出越来越多的新产品。 但数据流转、系统可靠性、业务建模、成本控制和工程取舍这些问题,不会因为工具变得更先进就凭空消失。 真正应该积累的,不是对某一家云厂商产品名称的熟悉程度,而是能够跨技术栈、跨平台解决复杂工程问题的能力。 今天你可以用 AWS,明天可以用 Azure,后天也可以用 GCP。 云平台可以更换,技术选型可以调整,框架甚至可以完全重写。 但如果你真正理解了系统架构背后的设计逻辑,你就不会因为换了一套工具而重新变成一个只会照着教程操作的新手。 我认为这才是 AI 时代工程师最应该建立的长期竞争力。 别再把会使用工具,当成真正掌握了技术。 真正的工程能力,是当所有工具都摆在你面前的时候,你知道自己究竟要解决什么问题,应该选择什么方案,以及为��么这样选择。 会调用 API 的人会越来越多。但能够把数据、模型、业务和基础设施整合成一套可靠系统的人,依然会有长期价值。
See More
chan_tre
retweeted
hboot
@hboot0230
1 day ago
想请教一下做过 AI 知识库的朋友: 目前我的方案是: 混合检索 + 语义上下文回填 + 原文引用。 但一直有个疑问:现在 RAG 知识库的检索和问答准确率,实际能做到多少? 尤其是文档量上来之后,能否稳定找到正确内容、减少遗漏和幻觉? 有没有做过真实数据测试的朋友?想了解一下你们的方案和实际准确率。
Who to follow
AxUrE
@AxUrE_KB
S/绳/高弹/紧身衣/户外/木乃伊/白手套/喜大胸肌肉男
日夜颠倒
@JamesQian_
家有烈🐶,有小癖好,会点绳子,喜1m骚🐶锁🐶,偶尔会自锁戒撸
尘埃
@ZQ0606
chan_tre
retweeted
Ethan 恩宇
@UPing123zzz
2 days ago
一堆企业天天喊着要做 AI Agent、企业知识库、RAG、多智能体协作,恨不得明天就让 AI 接管整个公司的业务流程。 结果你真去看它们内部的数据系统,才发现很多企业连自己的数据到底存在哪、怎么组织、谁有权限访问、数据多久更新一次,都他妈说不清楚。 一边是几百万参数、几千亿参数的大模型不断迭代,一边是企业内部的 Excel 满天飞、业务系统互不相通、文档版本混乱、数据口径对不上。 这种情况下,给你再牛逼的模型又有什么用? 上面这张图��实解释了一个特别基础,却被很多 AI 从业者忽视的问题:Data Lake、Data Warehouse、Lakehouse,到底有什么区别?为什么它们会直接影响未来企业 AI 的落地? 先说 Data Lake,数据湖。你可以把它理解成一个能够容纳各种类型数据的基础设施。 数据库记录、PDF、图片、日志、音频、视频、业务事件,结构化、半结构化、���结构化数据,都可以按照不同格式存进去。 它最大的优势是灵活,不需要一开始就把所有数据整理成固定的业务模型。 但问题也很明显。数据存进去了,不代表数据就能直接使用。 如果没有元数据管理、质量校验、权限体系和明确的数据组织规则,数据湖很容易变成所谓的 Data Swamp,数据沼泽。 一堆数据躺在那里,没人知道哪个版本可信,也没人知道这些数据到底能不能用于生产。 然后是 Data Warehouse,数据仓库。它的核心目标不一样。 数据仓库更强调经过整合、清洗、建模之后,形成可以稳定查询、分析和统计的业务数据。 比如公司今天销售额多少、哪个渠道的获客成本最低、这个月的客户转化率是多少。 这些东西不能让一个大模型随便猜,更不能让不同部门各自算出一套指标。 数据仓库的重要价值,就是让企业建立相对统一、可信的业务指标体系。 但传统数据仓库的代价,是数据建模、维护成本以及处理不同数据类型时的灵活性限制。 于是就有了 Lakehouse,湖仓一体。 它想解决的不是一个特别玄乎的问题,而是:能不能同时保留数据湖的灵活性,又获得数据仓库的可靠管理和高效分析能力? 图中展示了一个很典型的 Bronze、Silver、Gold 分层架构。 Bronze 保存原始数据,Silver 负责清洗、校验和标准化,Gold 则提供面向业务分析的高质量数据。 这不是说所有 Lakehouse 都必须严格采用这三层,而是一种非常实用的数据工程组织方式。 你会发现,从数据湖、数据仓库到湖仓一体,真正重要的变化,根本不是名字越来越高级。 而是企业开始思考一件事:数据不能只被保存,还必须能够被治理、被理解、被使用,并且在整个业务系统里保持可信。 这件事放在 AI Agent 时代,重要性会被进一步放大。 我拿企业 RAG 举个例子。现在很多人做企业知识库,就是把几百份 PDF、Word、Markdown 文档直接切块,生成 Embedding,扔��向量数据库,然后接一个大模型。 跑通了,回答也不错,就觉得系统已经完成了。 但真正交付到企业之后,你会遇到一堆麻��。 同一份政策文件存在三个版本,模型应该相信哪个? 客户资料更新了,向量索引什么时候同步? 员工离职以后,Agent 还能不能检索到原来部门的机密文件? 销售部门和财务部门对同一个指标的定义不同,Agent 应该按照哪个口径回答? 检索到了过期文档,系统有没有办法发现? 这些问题不是换个 Embedding 模型、调高 Top-K,或者增加几段 Prompt 就能解决的。 因为很多时候,问题根本不在大模型,也不在检索算法,而是在更底层的数据架构、治理体系和业务流程。 甚至可以说,未来企业 AI 落地最容易被低估的成本之一,就是数据治理成本。 你想让 Agent 自动分析销售情况,它需要可信的业务数据。 你想让 Agent 自动处理合同,它需要文档版本管理、权限控制和审计能力。 你想让 Agent 跨部门执行任务,它需要知道不同系统里的数据到底代表��么,以及哪些操作需要人工审批。 这时候,大模型只是整个系统的一部分。 真正复杂的是背后的数据管道、业务语义、权限边界、状态管理和工程可靠性。 当然,湖仓一体也不是什么万能解药。不是企业上了 Lakehouse,数据就自动干净了,更不是用了某个开源框架,就突然拥有了完整的 AI 基础设施。 小企业可能一个设计合理的 PostgreSQL 加对象存储,就足够支撑现阶段的业务。 大型企业可能需要复杂的数据湖、数据仓库、实时数据管道和统一治理体系。 架构不是越复杂越先进,而是越符合真实业务需求越有价值。 所以我越来越觉得,现在很多人学习 AI 的方向有点跑偏了。他们天天研究哪个 Agent 框架更火,哪个模型的 Benchmark 又涨了多少分,哪个开源项目一夜之间拿了几万 Star。 这些东西当然有价值。但如果你真的想做企业级 FDE、RAG 工程师、Agent 工程师,就不能只会调用模型。 你至少得理解数据从哪里来、怎么流动、怎么清洗、怎么组织、怎么检索、怎么更新、怎么隔离权限,以及如何保证最终输出的可信度。 否则你做出来的永远只是一个看起来很聪明、却随时可能在真实业务里翻车的 Demo。 AI 的上限可能取决于模型能力,但企业 AI 系统能不能真正落���,很大程度上取决于数据质量和工程能力。 未来真正值钱的,不只是会用 AI 的人。而是那些能够把企业混乱的数据、复杂的业务流程和不断进化的大模型,真正整合成一个可靠系统的人。 模型能力会越来越便宜,调用门槛会越来越低。但理解业务、治理数据、设计系统、承担交付责任的能力,不会因为模型变聪明就自动出现。 别再以为接上一个最强的大模型,企业就完成了 AI 转型。 数据底座都没打好,Agent 搭得再漂亮,也可能只是一座随时塌掉的空中楼阁。
See More
chan_tre
retweeted
黄小木
@ai_xiaomu
2 days ago
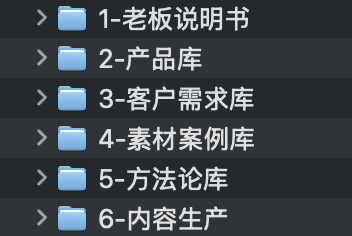
给老板做知识库 sop : 1. 老板是没有知识库的,你不可能指望他给你掏出个 obsidian 出来,所以要通过聊天的形式挖出来; 2. 带个录音豆,提前准备好问题,聊上几个小时; 3. 把录音文件用 skill 处理成多个文件夹; 4. 给老板做个桌面插件处理音频文件,告诉老板以后有新录音了点一下; 5. 交付完成⬇️
chan_tre
retweeted
ZC | AI & 宏观拆解
@zcswl7961
2 days ago
最近面试了几位自称“精通 Agent 开发”的候选人。聊到具体实现,很多人的方案还是写 Prompt、调模型 API,再把结果返回给用户。 这当然是应用的一部分,但离把 Agent 做可靠还有一段距离。 真正值得深挖的,是 ReAct 这类控制循环:模型根据当前状态选择动作,工具执行后返回 Observation,系统再判断是继续、修正,还是结束。 尤其是失败时,不能只把错误原样塞回去、让模型无限重试。要有明确的状态管理、结果校验、错误反馈、重试上限和退出条件。再往外看,工具调度、上下文管理、超时控制、执行追踪和效果���估,也都是 Agent Harness 的重要部分。 会用 LangChain 这类框架,本身不是问题;问题是框架替你做了什么、失败时会发生什么,如果都说不清,系统出了问题也就很难定位和控制。 Agent 开发的门槛,不在于能不能把模型调起来,而在于能不能把“行动—观察—修正—停止”这套机制做得可控、可追踪。 你现在做的 Agent,失败时能解释它为什么重试、什么时候停下来吗?
See More
chan_tre
retweeted
Ethan 恩宇
@UPing123zzz
2 days ago
现在学 AI 有一个特别大的问题就是一个人太容易产生自己已经掌握某项技术的错觉了。 看过几个 GitHub 仓库,觉得自己懂 Agent 了;跟着教程跑通一个 RAG,觉得自己会做企业知识库了;让 Codex 写出一个完整网站,觉得自己已经具备全栈开发能力了;部署了几个开源项目,甚至开始觉得自己什么系统都能做。 但真正到了企业交付的时候,情况完全不一样。 RAG 检索效果差,到底是文档质量问题、切分问题、召回问题,还是模型生成的问���?Agent 执行到一半失败,任务状态怎么保存?重复调用 API 产生费用,怎么保证幂等?系统在本地运行正常,部署之后为什么各种报错?客户数据涉及权限和隐私,应该如何处理? 这些问题一出来,才知道自己到底会什么,不会什么。 芒格和李录特别强调一个概念,叫能力圈。它不是指你认识多少个行业,知道多少种技术,而是你在多大范围内真正拥有可靠的判断。 这里面最重要的甚至不是能力圈有多大,而是你是否清楚它的边界在哪里。 有些人研究了十几个行业,每个行业都能说上一套专业术语,但没有一个真正研究透。另一些人可能只懂一个很小的行业,却清楚里面的商业模式、成本结构、竞争关系和风险。真到了需要做重要决策的时候,后者未必比前者差。 技术领域也是一样。一个人会用十个 Agent 框架,不代表他比一个真正理解异步任务、状态管理、重试机制、日志监控和系统可靠性的人更有工程能力。工具会更新,框架会迭代,今天很热门的东西明年可能就没人用了,但很多底层的工程问题不会因此消失。 所以真正应该建立的,不是一个不断增加工具名称的知识清单,而是一套能够解决真实问题的判断体系。 还有一点很重要:不要因为自己暂时不懂,就觉得必须把所有知识补齐以后才能开始。���力圈本来就是一点一点建立的。可以从自己理解的部分入手,做一个真实项目,遇到问题再研究,研究完再实践,最后把经验沉淀下来。 但一定要区分三个阶段:听说过、能做出来、能稳定交付。 这完全不是一回事。 AI 可以帮助你极大地提高学习和开发效率,但它不能自动把所有生成出来的知识变成你的能力。 真正懂一个东西,不是你能让 AI 给出答案,而是你有能力判断这个答案为什么对、什么情况下会错,以及错了以后该怎么办。 能力圈的边界越清楚,你做决策的时候才越有底气。
See More
chan_tre
retweeted
摸鱼巨匠🔨
@ChatGptAstra
4 days ago
你的网页UI做得烂,不是你水平低,而是你没跟AI说清楚你的需求! 真正限制你的,不是想象力,而是你压根不知道怎么描述你要实现的效果。 这个项目,收录了192个带专业名称的效果库,每个名称还配有动态示例,让你直接点击Copy Prompt,即可一键让AI帮你实现你想要的效果。 落地页特效、动效、镜头移动、摄影风格等方向,全都有作业可抄! 1. 项目地址: https://t.co/cOF5clwOrw 2. 动态画廊,所有效果均可实时播放: https://t.co/RJz8qh3kMt 3. 也可作为 Skill 直接给 Agent 调用,让它直接帮你改好: npx skills add showheyohtaki/motion-prompt
See More
ChatGptAstra's tweet video.
chan_tre
retweeted
Ethan 恩宇
@UPing123zzz
4 days ago
现在很多人学 RAG,基本上都是从同一套流程开始的: 文档上传 → Chunking → Embedding → Vector DB → Retrieval → LLM → 输出答案。 把 LangChain 或者 LlamaIndex 跑起来,接上一个向量数据库,再调用大模型,一个 RAG Demo 很快就出来了。 能跑通 RAG和真正具备交付企业级 RAG 系统��能力,完全是两回事。 这张图给出了一套 Production-Ready RAG Architecture,从 FastAPI、文档解析、向量数据库、检索生成,一直到 PostgreSQL、日志、Docker 和 CI/CD。 我觉得非常值得研究,但它真正有价值的地方,不是教你怎么组织 Python 文件夹,而是让你意识到: RAG 从来不只是一个大模型应用,它本质上还是一套需要长期维护的软件工程系统。 尤其是实际接触 GEO、企业知识库、Agent 工作流之后,我越来越发现,很多时候系统真正难解决的问题,根本不在大模型本身。 举个很简单的例子。假设你给一家企业做知识库,里面有几百份产品资料、FAQ、技术文档和业务说明。 用户问一个问题,系统返回了错误答案。 很多人第一反应是什么?换一个更强的大模型,重新修改 Prompt,调整 Temperature,甚至觉得是不是模型本身不够聪明。 但你有没有想过,可能从一开始,正确的知识就根本没有进入模型的上下文? 比如 PDF 解析的时候,表格的行列关系被破坏了,产品型号和对应参数混在了一起。 或者 Chunking 的时候,把一个完整的技术说明拆成了几个互相缺乏上下文的片段。 再或者,正确的文档明明就在知识库里,但 Retriever 没有召回;即使召回了,也因为排序太靠后,最后没有进入生成阶段。 这种情况下,你就算换一个再强的模型,也不一定能解决问题。 因为问题发生在检索层,你却一直在优化生成层。 我觉得这是 RAG 工程里特别重要的一种判断能力。 你必须能够区分:到底是知识库里没有答案,还是文档解析出现问题? 是 Chunking 策略不合理,还是 Embedding 没有捕捉到正确语义? 是检索召回出了问题,还是 Reranker 没把正确证据���在前面? 是 Prompt 没有限制模型行为,还是模型没有正确使用已经提供的证据? 这些问题表面上看最终表现都是AI 回答不准确,但实际上,每一种问题背后的解决方案完全不同。 而且真正到了企业环境,还有更多问题需要考虑。 文档更新之后,旧版本的向量索引怎么处理? 客户删除一份资料,怎么确保系统不会继续检索到已经删除的内容? 同一个系统服务多家企业,怎么保证 A 公司的内部资料不会被 B 公司检索出来? 用户同时上传大量文档,怎么避免请求超时? Embedding API 失败了怎么办?任务执行到一半中断了,怎么恢复?重复提交会不会导致重复写入和额外费用? 这些东西在 Demo 阶段可能完全不会暴露。 因为 Demo 的目标是证明功能可以实现,而生产系统的目标是确保它在各种异常情况下依然可靠。 这也是为什么我觉得,RAG 开发到后面,越来越像后端工程、数据工程、检索工程和 LLM 工程的结合。 你需要理解 HTTP、API、数据库、异步任务、缓存、权限控制、Docker、CI/CD,也需要理解 Embedding��Hybrid Search、Reranking 和模型生成。 而且这些技术不是简单堆在一起就可以了。 你还得知道为什么选择它们,以及什么时候根本不需要引入额外的复杂度。 比如,不是所有 RAG 都需要独立部署一个向量数据库。 某些中小规模项目,PostgreSQL 加 pgvector 就可能已经足够。 不是所有查询都适合纯向量检索。遇到产品型号、错误码、专业术语这种需要精确匹配的内容,关键词检索可能非常重要。实际项目里可以根据场景组合 BM25、向量检索和 Reranker。 也不是所有业务都需要 Agentic RAG。如果需求只是稳定回答企业 FAQ,普通检索工作流就能很好地解决问题,为什么还要引入一个不断自主规划、反复调用工具的 Agent? 增加技术组件,不一定意味着系统更先进,也可能只是增加了成本和故障点。 另外,我觉得这张图虽然已经涵盖了很多工程模块,但还缺少一个非常关键的东西:Evaluation,也就是真正的 RAG 评测体系。 很多人优化 RAG 的方法还停留在:自己随便问几个问题,感觉回答还不错,于是认��系统已经优化好了。 但如果没有标准测试集,没有检索召回率,没有答案正确性和忠实度评估,没有回归测试,你怎么知道修改之后系统究竟变好了还是变差了? 可能你优化了某几个问题的回答,却让另外几十个问题的召回效果下降。 可能模型回答得越来越流畅,但引用的资料却越来越不准确。 真正可靠的 RAG,应该能通过评测回答这些问题:正确证据有没有被召回?最终回答是否受到证据支持?知识库没有答案时能不能合理拒答?一次查询需要多少成本?P95 延迟是多少?新版本上线后有没有发生质量退化? 如果一个系统的效果无法被验证,那所谓的优化很可能只是在凭感觉调参数。 学习 RAG 最好的方式,不是再去收藏十几个框架,也不是让 Coding Agent 一次性生成一套看起来很专业的项目目录。 而是拿一批真实企业资料,从文档解析、知识入库、检索、重排到生成,完整做一遍。 然后故意制造各种问题。 把文档切坏,看看检索会发生什么。 加入相���矛盾的旧版本资料,看看系统能不能识别有效版本。 把正确答案放进知识库,观察为什么没有被召回。 模拟数据库连接失败、模型 API 超时、重复提交任务,看看系统有没有恢复能力。 最后给它建立一套测试集,每次修改都验证结果。 当你真正能够从日志、检索结果、数据库和代码里,把一次错误回答的原因找出来,并且通过测试证明自己修复了问题,你对 RAG 的理解就已经不只是会调用框架了。 这也是我现在越来越重视的一件事:AI 时代,写出一个 Demo 的门槛正在降低,但把 Demo 变成可靠产品的工程能力,依然需要长期积累。 未来可能会有越来越多的人,靠自然语言就能让 Agent 生成一套 RAG 系统。 但能不能理解客户真正需要什么,能不能做正确的架构取舍,能不能保证数据安全,能不能定位复杂故障,能不能持续维护和交付,是另一回事。 我觉得这才是 FDE、AI Engineer 真正应该深入掌握的能力。 不要只是追求把 RAG 跑起来。要学会解释它为什么能跑、为什么会错、出了问题怎���修,以及怎样证明它在真实业务里值得被信任。 会搭 RAG 是起点,能交付一个稳定、可观测、可评测、可维护的 RAG 系统,才是真正开始进入工程实践。
See More
chan_tre
retweeted
Ethan 恩宇
@UPing123zzz
5 days ago
很多程序员想做 FDE,第一步就不知道从哪里找客户。 于是每天在 X 上发自己的技术项目,朋友圈发最新的 Agent、RAG、MCP、Skills,GitHub 上开源几个仓库,然后等着老板主动过来问能不能合作。 但这里面其实有个问题,你技术做得再厉害,客户为什么要���道你?为什么要关注你的技术?又为什么要在那个时间点,刚好产生购买需求? 很多技术人员把获客理解成扩大曝光,但真正有效的获客,首先应该建立在对行业和客户的理解上。 举个特别有意思的案例。 有团队原本在做一款双目摄像头,最早应用在刷脸支付等场景,后来想把它拓展到 K12 教育市场。 如果按照普通技术人员的思路,可能就是介绍摄像头有多先进、算法识别能力有多强、硬件参数有多好,然后到处找学校推销。 但人家没有先这么做,而是先研究全国各类教育赛事、比赛规则、参赛内容、相关硬件厂商和供应商。 研究这些东西的目的,不只是了解行业,而是反过来寻找产品真正能够切进去的场景。 因为有些教育赛事需要特定类型的教学设备,参赛企业和供货商又形成了相对明确的生态。 于是通过公开信息、赛事资料和相关供应链线索,整理出了八十多家潜在合作厂商。 接下来才是联系、沟通、筛选、内测。 最终从这些企业中筛选出少数合作伙伴,再优先与其中一家深度合作,做出可以实际展示的标杆产品。 有了真实案例之后,后续再向相似企业推广,难度自然会下降。 这里面最有价值的,不是打电话,也不是硬件本身。 而是他先搞清楚了一个行业的业务是怎么运转的,然后才知道自己的技术应该卖给谁。 很多人做企业 AI,刚好是反过来的。先把一个 Agent 做出来,然后开始想到底哪个行业需要它。 今天觉得教育市场大,明天觉得制造业有机会,后天又开始研究医疗行业。到最后哪个行业都知道一点,但没有一个行业真正理解透彻。 真正应该研究的是:这个行业的钱从哪里来?哪些环节最消耗成本?谁拥有采购预算?有哪些现有供应商?采购一般通过什么渠道?一个新的技术方案要满足什么条件才能进入? 比如你想给制造业做 AI,不是简单搜索一下制造业 AI 应用场景,然后做���个 Demo 就够了。 你要知道工厂里哪些数据可以获取,哪些系统已经存在,哪些流程需要人工复核,哪些部门有预算��以及客户现有的解决方案为什么不能满足要求。 有些问题看起来非常适合 AI,但因为数据不开放、现场环境复杂、系统维护成本太高,根本无法轻松落地。 有些问题技术并不复杂,却因为足够高频、业务价值明确,反而可以形成非常好的项目。 这就是行业理解的重要性。 而且做过一个客户之后,也不要急着换赛道。 继续寻找相似企业,研究它们有没有同样的问题,把原来的解决方案、成本模型、技术架构和交付经验慢慢复用。 这样你积累的不再只是几个孤立的项目,而是一套逐渐成熟的行业能力。 技术决定你能做什么,行业理解决定什么值得做,商业判断决定谁会为它付钱。 这三件事情如果不能连接起来,学再多 Agent 框架,也不代表你就能真正做好企业 AI 生意。
See More
chan_tre
retweeted
Holmes samuel
@Holmessamu28041
5 days ago
��到颅内40分钟
Koavc.
@chan_tre
4 days ago
@sockdog4fake
今日割五城,明日割十城,然后得一夕安寝。
Koavc.
@chan_tre
4 days ago
@youngstockuser
@moomoo
可以考虑一下 llm-wiki , https://t.co/0fecukd3qr
chan_tre
retweeted
dontbesilent
@dontbesilent
4 months ago
https://t.co/bYK10uEi91
chan_tre
retweeted
Ethan 恩宇
@UPing123zzz
6 days ago
很多人对 RAG 的理解,还停留在把文档切一切、做个 Embedding、塞进向量数据库,最后接个大模型,就觉得自己搭建了一套知识库系统。 但真正做过企业 AI 落地就会发现,RAG 最难的根本不是把系统跑起来,而是怎么让它长期、稳定、准确地回答问题。 你会发现一个特别有意思的现象:一旦 AI 回答不准确,很多人的第一反应就是换模型,从 DeepSeek 换到 GPT,再从 GPT 换到其他更贵的模型或者不停修改 Prompt,觉得模型能力强了,答案自然就准确了。 但问题是,很多时候根本不是模型不够聪明,而是你连正确的资料都没有检索出来。 知识库里的文档有没有正确解析?Chunking 有没有把原本完整的语义切碎?Embedding 能不能准确匹配用户的问题?用户问的是一个具体型号或者价格,你还在用纯向量检索,而不是结合 BM25 做 Hybrid Search?检索出来几十个结果,有没有经过 Reranking?真正重要的证据有没有被排到前面? 这些问题不解决,换再强的模型也未必有用。 而且 RAG 远不止检索这一步。 用户的问题表达不清楚,需要 Query Rewriting;一个问题涉及多个知识点,需要 Query Decomposition;检索片段太短,丢失了上下文,可以考虑 Small-to-Big Retrieval;文档之间存在复杂的实体关系,可以研究 GraphRAG;涉及多轮决策、多知识源和工具调用,可以进一步考虑 Agentic RAG。 但这不意味着你要把这 15 种技术全部堆进系统里。 我反而觉得,现在很多 AI 开发者特别容易陷入一种技术自嗨:什么技术新就接什么,什么架构复杂就上什么。最后技术栈越来越庞大,调用成本、延迟和维护复杂度都上来了,但客户最关心的问题依旧没有解决。 真正有价值的是,你知道每一项技术在解决什么问题,什么时候值得使用,什么时候根本没必要使用。 尤其是最后两个概念:Faithfulness 和 Precision / Recall。 我觉得这才是很多人从做 AI Demo 到做企业级 AI 系统,真正需要跨过去的一道坎。 你不能只凭自己问了几个问题、觉得回答还不���,就说系统已经做好了。 你得有测试集,知道正确���料有没有被召回,召回的资料有多少真正相关,模型生成的每一个关键结论能不能找到证据,以及每次优化之后准确率、延迟、成本到底发生了什么变化。 如果连这些都没有,所谓的 RAG 优化,很大程度上就是凭感觉调参数。 而企业真正需要的,也不是什么特别炫酷的 Agent 架构。 它需要的是客户问一个问题,你能找到正确的资料,给出有依据的回答;不知道的东西不要乱编;不同客户的数据不能串;知识库更新之后系统能够同步;出了问题还能定位到具体是哪一个环节。 这才是工程。 所以我一直觉得,未来做 FDE、AI Engineer,真正拉开差距的,不是你会调用多少模型 API,也不是你知道多少 Agent 框架,而是你能不能把一个看起来很简单的 AI 功能,做成真正能够被企业长期使用的系统。 能跑起来只是起点,能解释为什么这样设计、能定位问题、能量��效果、能稳定交付,才是真正的技术能力。 这张图的 15 个 RAG 概念值得系统学习,但比记住这 15 个名词更重要的,是理解它们背后的工程取舍。
See More
chan_tre
retweeted
职场阅见|WorkSight
@WorkSightHQ
8 days ago
这是今年开学季我听过最通透的一节课
Koavc.
@chan_tre
6 days ago
@UPing123zzz
确实,之前在健身房边��铁,边把电脑放边上桌子上跑任务,组间过去看进度,就有小伙伴问我这是啥。 我一时语塞,不知道如何解释,人家做实体制造业的,只知道这个软件看起来高级,一直在蹦字出来 - -
Koavc.
@chan_tre
6 days ago
@zhuanmama0221
😅 觉得累可以不结婚然后工作去赚钱啊,当代社会工作能力够的话,一个人不也可以过得很好吗?跟你讨论工作能力、抗压以及夜班轮岗的时候,又不乐意了?怎么,突然不喜欢工作喜欢家务了? 本质就是找点东西给自己抬价罢了,真正寻死的人找个地方就跳了,不会在早晚高峰的桥上大叫,我要跳下来寻死!
chan_tre
retweeted
Orcastao
@OrcasTao
11 days ago
我做了半年 FDE,越来越觉得:有能力的人,应该试着自己做点事情了 这半年,我做了不少 AI 项目。 招聘 Agent、投标 Agent、知识库、自动化工具、客户 Demo��业务方案和项目交付。 接触了不同的行业,也见过不少企业对 AI 的需求。 但这半年最大的收获,不是学会了多少工具,而是我对一件事越来越有信心: 现在有技术能力、业务经验、愿意主动解决问题的人,真的可以尝试自己做点事情了。 以前,一个人想做一个产品,可能需要找产品经理、设计师、开发、测试,还要考虑服务器、部署和运营。 很多想法不是没有价值,而是根本没有条件把它做出来。 但现在不一样了。 一个懂业务的人,可以借助 AI 做出原型。 一个懂技术的人,可以独立完成过去需要一个小团队才能完成的开发工作。 一个有行业经验的人,可以把自己过去积累的经验,变成工具、服务,甚至产品。 我不是说一个人就能解决所有问题,也不是说 AI 创业很容易。 而是过去很多人被团队、资金和技术资源限制的事情,现在有了新的可能性。 做了半年 FDE,我有几个越来越强烈的体感。 01 很多机会,不在于你会什么,而在于你发现了什么问题 做 FDE 之后,我有机会接触不同企业的真实业务。 以前我们谈 AI,更多是在讨论模型、Agent、工作流、知识库。 但真正进入业务现场之后,你会发现,很多问题其实非常具体。 资料怎么整理?信息怎么查找?重复工作怎么处理?一个业务流程为什么要经过这么多人工环节? 这些问题可能并不性感,也不是什么前沿技术。 但有人愿意为解决这些问题付费。 这让我改变了一个想法: 创业不一定要从一个宏大的技术创新开始,也可以从你比别人更了解的一个具体问题开始。 你在某个行业���作过几年,可能比一个只研究 AI 工具的人更容易发现机会。 因为你知道问题在哪里,也知道现在的人是怎么解决的。 AI 给你的,是把解决方案做出来的能力。 而你过去积累的行业经验,可能才是你真正的起点。 02 一个人能做的事情,正在发生变化 这半年,我最大的感受之一就是 AI 正在改变个人的生产力边界。 以前有一个想法,首先要考虑: 我有没有开发资源?有没有设计能力?有没有团队? 现在这些问题的答案正在发生变化。 你可以让 AI 帮你梳理需求、设计产品、生成代码、测试接口、搭建 Demo,甚至帮助你完成内容和营销。 当然,AI 生成的东西不一定可靠,真实产品仍然需要工程能力、业务验证和持续维护。 但至少,很多过去需要投入大量资源才能开始的事情,现在一个人就可以先跑起来。 过去我们需要先组建团队,才有机会验证想法。现在可以先用 AI 验证想法,再决定是否需要团队。 我觉得这是一个很重要的变化。 尤其对于有编程能力、产品经验、行业经验的人来说。 不要低估自己手里的能力,也不要总觉得必须等条件全部成熟才能开始。 03 不要总想着做一个大产品,先找到一个愿意付费的人 做了这些项目之后,我对创业也有了一个更现实的认识。 不要一开始就想着做一个平台、一个中台,或者一个完整的 AI 操作系统。 这些想法可能很有想象空间,但离真实收入还有很长的距离。 反而可以从一个很小的事情开始。 比如: • 帮一家律所解决知识产权资料整理的问题。 • 帮一家企业把重复的业务文档编写流程自动化。 • 帮一个招聘团队提高候选人信息处理效率。 • 帮一个独立开发者把自己的产品想法做成可以验证的 MVP。 先找到一个真实用户。 先解决一个具体问题。 先看看对方愿不愿意付费。 然后再考虑标准化、产品化和规模化。 不要先花半年做一个自己认为有价值的产品,再去寻找客户。先找到一个客户真正愿意解决的问题。 这可能是我在 FDE 项目中学到的,对个人创��最有价值的一件事。 04 我越来越不建议有能力的人,只把自己当成一个岗位 这句话可能有点冒犯,但确实是我这半年的思考。 以前我们很容易通过岗位定义自己。 我是开发、我是产品、我是运营、我是售前、我是 FDE。 但如果把视角放到 AI 时代,我觉得这种定义可能会越来越不够用。 一个开发者,不一定只能等待需求、完成开发任务。 他可以发现问题、设计产品、搭建系统、寻找用户。 一个懂业务的人,也不一定只能依赖公司提供的技术团队。 他可以借助 AI,把自己的业务经验转化成工具和服务。 一个有行业经验的人,也不一定只能通过出售自己的工作时间获得收入。 他可以尝试把经验沉淀成流程、产品、内容或者其他可复用的资产。 当然,这不意味着每个人都应该辞职创业。 我更想表达的是: 不要把自己拥有的能力,仅仅用来完成一个岗位的职责。 你完全可以在工作之外,尝试把自己的能力变成一份独立的价值。 05 未来创业经历是简历最加分的一项 我并不认为 AI 创业是一件容易的事。 模型会变化,产品会被复制,客户不��因为你用了 AI 就愿意付钱。 真正的商业问题依然存在。 但我认为有一点已经发生变化: 一个人从发现问题,到做出解决方案,再到拿给客户验证,整个过程的成本正在降低。 这意味着,更多人有机会参与到创造价值的过程中。 你不需要一开始就有一家完整的公司。 也不需要先拥有一个很大的团队。 可以先做一个小工具,接一个小项目,服务一个客户,写一篇有价值的内容。 重要的是开始形成自己的闭环: 发现问题 → 做出解决方案 → 找到用户 → 获得反馈 → 持续改进。 每跑通一次,你就多积累一份经验、一份产品能力、一份客户认知。 这些东西不会因为换了一家公司就全部归零。 写在最后 我没有觉得自己已经找到了什么标准答案。 但我越来越相信一件事: AI 时代,普通人不一定只能等待机会,也可以主动创造机会。 尤其是那些已经有一定技术能力、行业经验、产品思维的人。 你可能只是一个普通开发者,可能在某个行业工作了五年,也可能有很多一直没有实现的想法。 我想说的是,不妨试着把其中一个想法做出来。 不用一开始就想着改变世界,也不用急着证明自己。 先解决一个真实问题,先服务一个真实用户,先赚到第一笔独立于工资的收入。 你会发现,自己原来不只是一个岗位上的执行者,也可以是一个价值的创造者。 不要等 AI 时代给你安排一个新岗位。也可以试着用 AI,为自己创造一个新位置。 这个是我褪去AI狂热后,越来越坚定的想法。 我也正在���试这样做。
See More
Last Seen Users on Sotwe
Kiệt
Seen from
Vietnam
Tasty Bi
Seen from
Thailand
3zziz. 5
Seen from
Germany
Soweto Lesbians
Seen from
United States
DY mong
Phạm hoàng
Seen from
Vietnam
Mert Yazıcı
Seen from
Turkey
tantebecek
Seen from
Indonesia
adel& dina
LoverBoy
Trends for you
1
Giants
Under 10K tweets
2
Microsoft
Under 10K tweets
3
Jameis
Under 10K tweets
4
Nabers
Under 10K tweets
5
Diggs
Under 10K tweets
6
Van Hollen
Under 10K tweets
7
Happy Friday the 13th
Under 10K tweets
8
#RaiseHail
Under 10K tweets
9
KATIE B
Under 10K tweets
10
#GOLDENHOUR_Part6
Under 10K tweets
Most Popular Users
1
Elon Musk
@elonmusk
241M followers
2
Barack Obama
@barackobama
118.8M followers
3
Cristiano Ronaldo
@cristiano
114.5M followers
4
Donald J. Trump
@realdonaldtrump
111.9M followers
5
Narendra Modi
@narendramodi
107M followers
6
Rihanna
@rihanna
98.7M followers
7
NASA
@nasa
92.2M followers
8
Justin Bieber
@justinbieber
91.8M followers
9
KATY PERRY
@katyperry
90M followers
10
Taylor Swift
@taylorswift13
84M followers
11
Lady Gaga
@ladygaga
75.5M followers
12
Virat Kohli
@imvkohli
73.4M followers
13
Kim Kardashian
@kimkardashian
70.8M followers
14
YouTube
@youtube
68.7M followers
15
Neymar Jr
@neymarjr
66.4M followers
16
Bill Gates
@billgates
65.2M followers
17
Selena Gomez
@selenagomez
63.1M followers
18
The Ellen Show
@theellenshow
62.2M followers
19
CNN
@cnn
61.7M followers
20
X
@x
60.6M followers
Olivia
Online
✨
⭐
💫