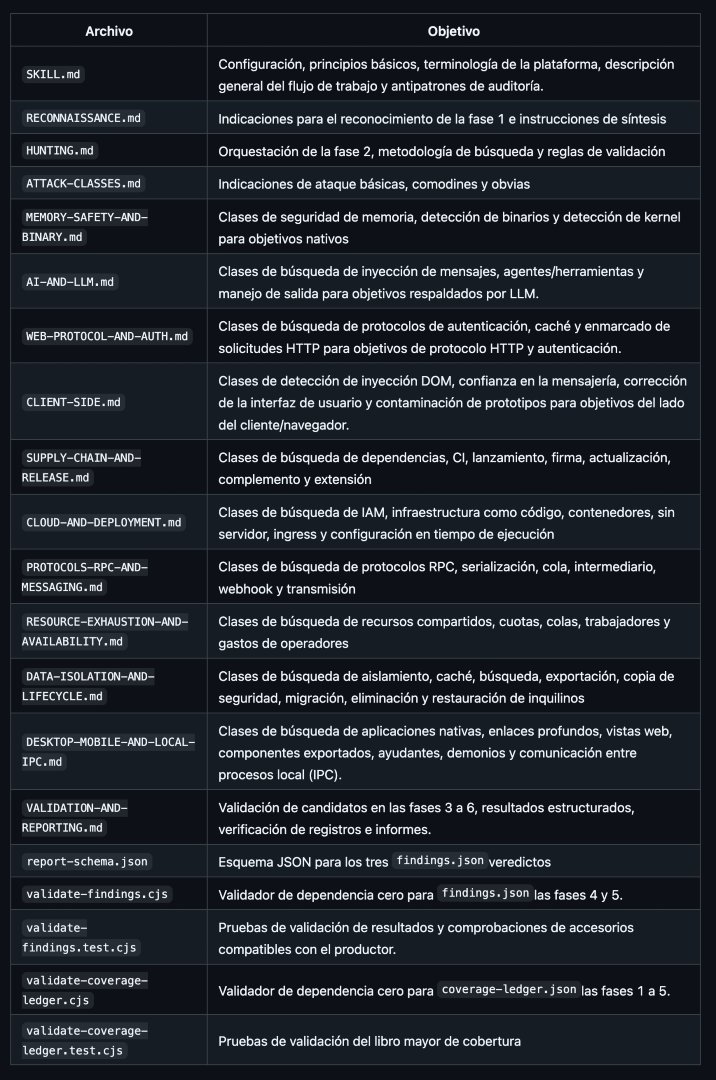
Cloudflare ha lanzado su propia skill completísima de auditorías de seguridad.
Es la que utilizaban internamente en la empresa como sistema de detección de vulnerabilidades.
→ https://t.co/p2WjZT7phe
⭐ 낯선 코드베이스 구조를 그림으로 보여주는 도구(Understand Anything)
새 팀 합류하고 낯선 코드들을 보면 참 막막하죠
Understand Anything은 코드를 통째로 읽어 지도로 그려주어 사용자의 이해를 돕습니다 ㅎㅎ 이미 유명한 도구죠?
파일·함수·의존관계를 눈으로 보는 인터랙티브 그래프로 보여준다는 게 꽤나 매력적입니다
■ 뭘 해주냐면
- 코드 전체를 훑어 지식 그래프로: 파일·함수·클래스를 클릭하며 탐색
- 각 노드를 쉬운 말로 요약: 이건 뭐 하는 코드인지 풀어 설명
- 가이드 투어: 의존 순서대로 "이 코드는 이 순서로 보라"고 안내
- 변경 영향 분석: 내 수정이 어디까지 파급되는지 커밋 전에 확인
■ 뭐가 좋냐면
- 한국어 지원: --language ko로 그래프·설명을 한국어로 뽑아요
- 그래프는 JSON이라 팀에 공유하면 동료는 분석 과정을 건너뛰어요 (온보딩용)
- Claude Code·Cursor·Codex·Copilot 등 대부분의 도구에서 사용 가능
- 무료 오픈소스(MIT)
📎 링크: https://t.co/iuhlgH9DRs
Así se ve un sueldo de 750.000 dólares al año: un tipo en camiseta blanca, un pizarrón y 2 horas y media.
Stanford, CS336. Percy Liang construye un LLM desde cero. Lo que hay debajo de Claude y ChatGPT, y arranca por la parte que todos saltan: el modelo no lee tu texto, lee números.
Anthropic paga ese sueldo a los ingenieros que entienden esa capa.
Lo único que cobra Stanford son 2 horas y media de tu atención.
Anthropic acaba de lanzar una guía completa sobre cómo construir tu primer agente de IA
Si yo hubiese tenido esto hace un año, habría lanzado mi primer agente en una hora
Este es el camino más rápido de cero a tu primer agente funcional
Guarda esto, estoy seguro de que te servirá de gran ayuda
Onde ler bons reports e melhorar MUITO em Bug Bounty?
- Reports da Google (ouro) > https://t.co/yppGwSlZAI
- Site com 1K de reports organizados + API https://t.co/TTYl9plCtZ
- Reports escolhidos a dedo por
@busf4ctor (ref global e br) > https://t.co/4PTBhIL6R6
☕️ 기술 면접에서 가장 어려운 파트 중 하나는 결국 시스템 디자인입니다.
이 GitHub 저장소는 자주 나오는 시스템 디자인 문제를
기초부터 실전까지 따라갈 수 있게 정리해둔 노트 모음입니다.
총 28개 주제로 구성되어 있고,
→ 요구사항 정리
→ 트래픽 추정
→ 저장소 설계
→ API와 데이터 흐름
→ 확장성·재해 복구
같은 과정을 단계적으로 설명합니다. 🧩
기술 면접 준비는 물론이고,
분산 시스템 기초를 보완하고 싶을 때나
제품을 만들면서 아키텍처가 막막하다고 느낄 때
연습 문제집처럼 보기 좋은 자료입니다.
🔗Github https://t.co/rYP6Zi16sF
#AI #AICaffeine #Github #Interview
LLM 관련 프로젝트 투자 품의를 진행하던 초기에 유독 기억에 남는 일이 하나 있다.
비기술 조직에서 오랫동안 사업기획을 담당하셨던 임원분이 어느 날 따로 연락을 주셔서 물으셨다.
“임베딩이 정확히 뭡니까?”
당시 C-Level 보고에서 우리가 세운 원칙은 꽤 단순했다.
‘초등학생도 이해할 수 있을 만큼 쉽고 라이트하게 설명하자.’
문제는 설명하는 우리 역시 개념을 ‘알고 있는 것’과 ‘쉽게 설명할 수 있을 만큼 이해하고 있는 것’ 사이에 꽤 큰 차이가 있었다는 점이다.
Word2Vec, Vector, Dimension, Cosine Similarity…
정확하게 설명하려고 용어를 하나씩 붙일수록 말은 길어졌고, 듣는 사람에게 임베딩은 오히려 더 어려운 개념이 됐다.
결국 우리가 선택한 방법은 시각화였다.
영상은 10,000개의 단어를 각각 200차원의 벡터로 표현한 Word2Vec 임베딩이다.
인간이 200차원의 공간을 그대로 볼 수는 없으니 PCA를 이용해 3차원으로 투영한다.
화면에서 하나의 점은 하나의 단어다.
‘toy’라는 점을 선택하면 주변의 단어들이 보이고, 우측에는 원래 200차원 임베딩 공간에서 Cosine Distance 기준으로 가까운 단어들이 나타난다.
우리가 당시 전달하려던 핵심은 사실 이것뿐이었다.
“AI는 단어의 의미를 사전처럼 저장하는 것이 아니라, 수많은 숫자로 이루어진 공간 속 위치와 관계로 표현한다.”
그리고 이 그림 역시 200차원 공간의 ‘진짜 모습’은 아니다.
사람이 이해할 수 있도록 3차원에 투영한 일종의 지도에 가깝다.
이 경험 이후 AI 기술을 투자부서나 유관부서에 설명하는 방식이 꽤 많이 바뀌었다.
모델 구조를 얼마나 정확하게 설명하느냐보다, 의사결정자가 어떤 Mental Model을 가져가게 할 것인가를 먼저 고민하기 시작했다.
AX를 추진하면서 생각보다 중요한 역량 중 하나가 바로 이것이었다.
기술을 아는 것과, 그 기술을 비기술 의사결정자가 이해할 수 있는 형태로 번역하는 것은 전혀 다른 능력이다.
그리고 좋은 시각화는 기술을 ‘단순화’하는 도구라기보다, 복잡성을 훼손하지 않으면서 의사결정에 필요한 추상화 수준까지 끌어올리는 도구에 가깝다.