Community Manager @ Sharp at Google!
“Here they come the mighty champions, raise your voices to the anthem, Marching like a mighty army, Wrexham is the name”
Fala galera! Quem é ouvinte do IA Sob Controle vai saber da novidade mais tarde no episódio de hoje, mas resolvi trazer primeiro aqui pra vocês: coloquei na prática um projeto novo que eu já queria fazer há algum tempo: o SOTAQUE.
A ideia é construir um dataset de vozes 100% open source (e criado de maneira crowdsourced) de vozes brasileiras pra que IAs (assistentes de voz, audiobooks, transcrições) consigam falar e entender português com a diversidade real do Brasil, e não só sotaque paulistano ou carioca.
Pra ajudar é só mandar um áudio com a sua voz (qualquer gravação serve, até áudio antigo do WhatsApp) e responder umas perguntas rápidas. Leva uns 2 min. Tudo 100% open source, vai ser publicado no Hugging Face com licença aberta.
Se puderem contribuir e compartilhar nas suas redes, eu e a comunidade open source BR agradecemos :)
Link no primeiro tweet abaixo!
O Pollo Agent está NO AR!
Sem prompts complexos. É só conversar com o Pollo Agent.
Créditos grátis são distribuídos aleatoriamente para usuários todos os dias.
Só por 24H: Seguir + RT + Comentar = 256 Créditos GRÁTIS!
A Anthropic acabou de liberar um CURSO GRATUITO de Prompt Engineering interativo.
9 capitulos + exercicios praticos + playground pra testar na hora:
1. Estrutura basica de prompts
2. Ser claro e direto
3. Atribuir roles
4. Separar dados de instrucoes
5. Formatar outputs
6. Pensamento passo a passo
7. Usar exemplos
8. Evitar alucinacoes
9. Construir prompts complexos (casos reais)
Se voce usa IA e ainda nao domina prompt engineering, ta deixando 90% do potencial na mesa.
Prompt bom = resultado bom. Prompt ruim = frustracão.
GRATUITO no GitHub:
https://t.co/1022fVBZ2i
Salva esse tweet. Voce vai precisar.
A empresa @_inception_ai lançou o Mercury 2, um LLM focado em raciocínio (reasoning) construído 100% com base em modelos de difusão.
Pra entender o que isso que dizer, precisamos lembrar de como a coisa funciona hoje. Praticamente todos os grandes modelos que a gente usa (GPTs, Claude, Gemini) são autorregressivos. Basicamente, eles geram o texto de forma sequencial, prevendo e "cuspindo" um token por vez, da esquerda pra direita, meio que como eu ou você digitando uma palavra após a outra.
Apesar de funcionar muito bem com reasoning (como temos visto benchmark atrás de benchmark sendo quebrado), isso cria um gargalo natural de velocidade, porque você precisa esperar a palavra anterior ficar pronta pra gerar a próxima.
O que o Mercury 2 faz é aplicar o conceito de difusão, que é comumente usado em modelos de imagem como o Nano Banana ou o Midjourney, só que pra texto!
Nas imagens, isso funciona com o modelo começando com um ruído (tipo o chiado da sua TV antiga), e passo a passo ele vai refinando isso até chegar na imagem perfeita do "gato astronauta" que você pediu no prompt. Já pra texto, em vez de ir gerando token por token em sequência, ele começa também com um rascunho inteiro com "ruído" e vai refinando a resposta inteira em paralelo, simultaneamente, em poucas iterações. É como se ele visse tudo de uma vez só e fosse alterando as palavras que achasse erradas.
E os resultados são absurdos: ele consegue gerar 1009 tokens por segundo (não, eu não digitei errado). Só pra dar contexto, os modelos mais rápidos das empresas grandes, como o Claude 4.5 Haiku e o GPT-5.2 Mini, geram em torno de 70 a 90 tokens/segundo. Deixo abaixo o vídeo pra você entender o quão absurdamente rápido ele roda.
Mas claro, ser rápido não bastaria se ele performasse mal. Nos benchmarks que eles divulgaram, ele cravou 91.1% no AIME 2025 de matemática (acima do Gemini 3 Flash) e 74% no GPQA Diamond de perguntas de nível PhD (acima do Claude 4.5 Haiku). Ou seja, ele entrega uma qualidade muito competitiva com os modelos "rápidos" das empresas top, mas numa velocidade MUITO acima.
Ele chega custando USD 25 centavos por 1 milhão de tokens de input e USD 75 centavos pra 1 milhão de tokens de output.
Vale lembrar que a Inception não está sozinha testando isso. A própria @GoogleDeepMind está investindo na pesquisa de modelos de difusão pra texto, e inclusive, batemos um papo sensacional sobre isso lá no IA Sob Controle com o João Gabriel Oliveira, pesquisador brasileiro da DeepMind que trabalhou justamente no Gemini Diffusion, lançado alguns meses atrás. Se não escutaram, deixo o link abaixo no primeiro tweet abaixo!
Pra quem me segue aqui há algum tempo, sabe que eu tenho uma quedinha por novas arquiteturas, e essa de difusão pra texto é algo que me parece tão estranho o fato de funcionar, que me atrai mais do que as outras. Se você testar no seu agente, deixa uma resposta aqui!
Hoje, um princípio elementar da soberania dos povos foi rasgado como se não fosse nada, e isso é perigoso em muitos níveis.
É um roteiro lógico, em plena continuidade: primeiro o Irã, depois o Chile, em seguida o Iraque, então a Líbia e, por fim, a Venezuela. Sempre com o mesmo discurso de “libertação” e “democracia”, seguido pelo real e óbvio interesse em petróleo, outros recursos e posição geopolítica.
Trata-se do único país do mundo que, historicamente, transitou livremente entre uma sanção e um míssil, como se não fosse nada, quando suas sanções econômicas não são suficientes para atingir os resultados pretendidos. Ou até mesmo utiliza as sanções para preparar e desestabilizar nações inteiras, tornando-as frágeis demais.
Os Estados Unidos sempre foram o país que se vestiu da régua moral do mundo, enquanto financiou golpes, apoiou ditaduras militares, treinou torturadores, sabotou eleições e estrangulou economias por meio de sanções.
É válido criticar as violações internas do regime venezuelano, mas isso de forma alguma pode legitimar o uso de força militar externa como se fosse “solução”, porque isso não é sobre narcotráfico, tampouco sobre democracia. É, intrinsecamente, uma guerra petrolífera.
A autodeterminação dos povos deveria estar acima de qualquer agenda externa. Esse é um princípio basilar.
A solução para os problemas venezuelanos nunca será militarizar a crise nem entregar a resolução política nas mãos de quem deseja controlar recursos, esferas de influência e abrir um precedente perigosíssimo na América Latina, como se vidas latino-americanas e a soberania de seus povos fossem descartáveis no tabuleiro geopolítico.
Além disso, é sempre importante ressaltar que a história mostra como intervenções externas, historicamente, agravam crises humanitárias e custam caro na vida de civis comuns.
A América Latina já aprendeu isso derramando sangue inocente. Quem ainda acredita em “intervenção humanitária” feita por império ou não conhece a história, ou escolheu esquecê-la.
🚨 DeepSeek just did something wild.
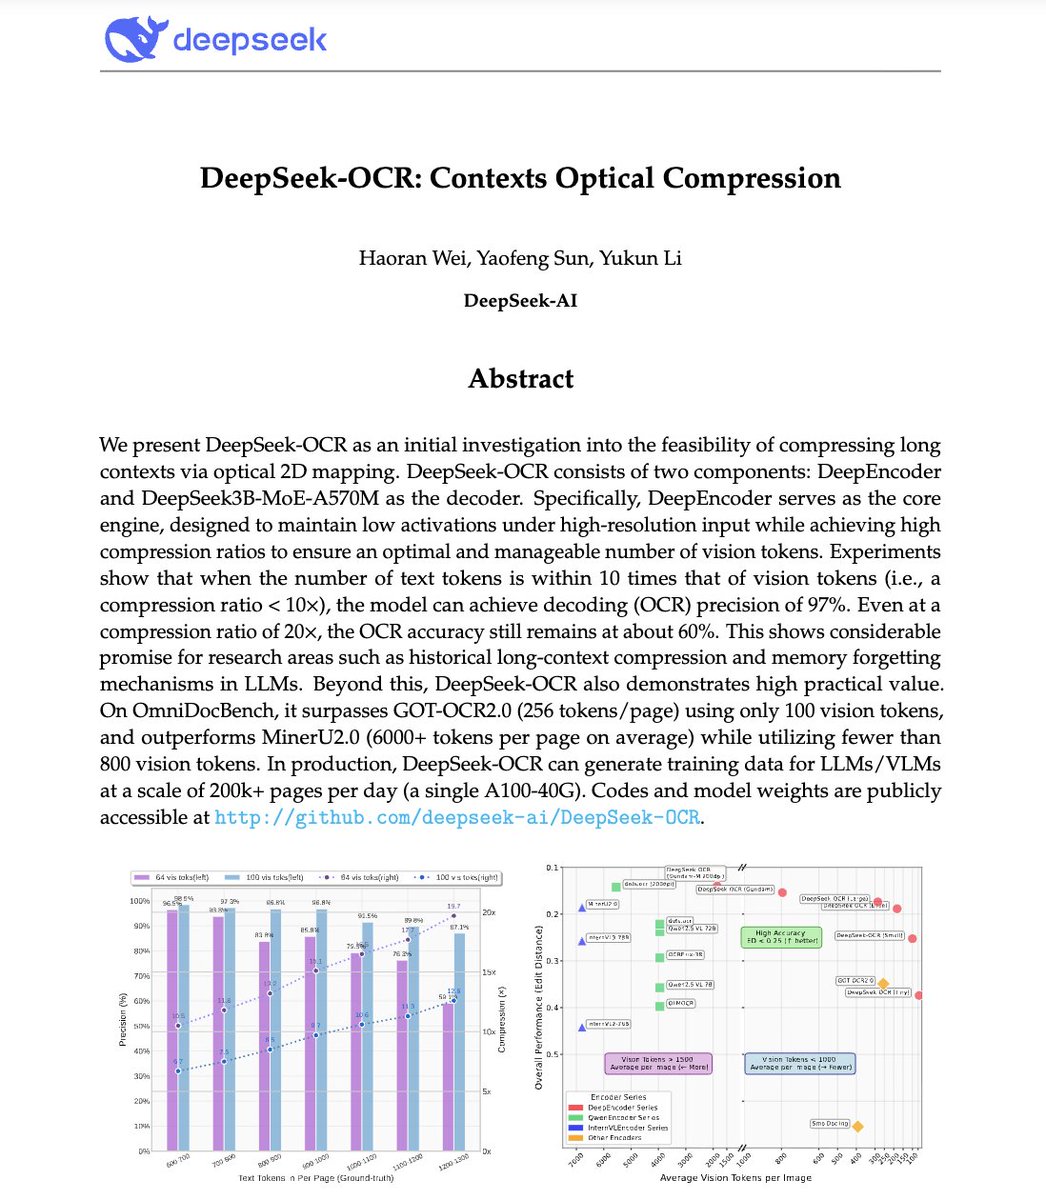
They built an OCR system that compresses long text into vision tokens literally turning paragraphs into pixels.
Their model, DeepSeek-OCR, achieves 97% decoding precision at 10× compression and still manages 60% accuracy even at 20×. That means one image can represent entire documents using a fraction of the tokens an LLM would need.
Even crazier? It beats GOT-OCR2.0 and MinerU2.0 while using up to 60× fewer tokens and can process 200K+ pages/day on a single A100.
This could solve one of AI’s biggest problems: long-context inefficiency.
Instead of paying more for longer sequences, models might soon see text instead of reading it.
The future of context compression might not be textual at all.
It might be optical 👁️
github. com/deepseek-ai/DeepSeek-OCR
My brain broke when I read this paper.
A tiny 7 Million parameter model just beat DeepSeek-R1, Gemini 2.5 pro, and o3-mini at reasoning on both ARG-AGI 1 and ARC-AGI 2.
It's called Tiny Recursive Model (TRM) from Samsung.
How can a model 10,000x smaller be smarter?
Here's how it works:
1. Draft an Initial Answer: Unlike an LLM that writes word-by-word, TRM first generates a quick, complete "draft" of the solution. Think of this as its first rough guess.
2. Create a "Scratchpad": It then creates a separate space for its internal thoughts, a latent reasoning "scratchpad." This is where the real magic happens.
3. Intensely Self-Critique: The model enters an intense inner loop. It compares its draft answer to the original problem and refines its reasoning on the scratchpad over and over (6 times in a row), asking itself, "Does my logic hold up? Where are the errors?"
4. Revise the Answer: After this focused "thinking," it uses the improved logic from its scratchpad to create a brand new, much better draft of the final answer.
5. Repeat until Confident: The entire process, draft, think, revise, is repeated up to 16 times. Each cycle pushes the model closer to a correct, logically sound solution.
Why this matters:
Business Leaders: This is what algorithmic advantage looks like. While competitors are paying massive inference costs for brute-force scale, a smarter, more efficient model can deliver superior performance for a tiny fraction of the cost.
Researchers: This is a major validation for neuro-symbolic ideas. The model's ability to recursively "think" before "acting" demonstrates that architecture, not just scale, can be a primary driver of reasoning ability.
Practitioners: SOTA reasoning is no longer gated behind billion-dollar GPU clusters. This paper provides a highly efficient, parameter-light blueprint for building specialized reasoners that can run anywhere.
This isn't just scaling down; it's a completely different, more deliberate way of solving problems.
AI is rapidly accelerating scientific discovery and contributing to the effort to better understand cancer. We're proud to announce two major open-source breakthroughs from @GoogleResearch and @GoogleDeepMind that demonstrate the immense potential of AI in this field:
First, DeepSomatic can significantly improve cancer diagnostics by accurately identifying key genetic variants within cancer cells, outperforming current state-of-the-art methods. This provides researchers and clinicians with a more precise and reliable tool for mapping cancer's blueprint, which is essential for targeted therapy development.
Second, our new Gemma C2S-Scale 27B model (built using our open Gemma family), achieved an exciting milestone: it generated a novel hypothesis to convert "cold" tumors—which are notoriously resistant to current immunotherapies—into "hot" tumors that can be successfully treated. This discovery may offer a new avenue for cancer drug development.
Google's new experiment towards AI augmented textbook.
Learn Your Way transforms content into a dynamic and engaging learning experience tailored for you. It even adapts the content to your grade level and interests.
I wish I had this in school!!
i just fed NotebookLM a massive amount of iman gadzhi content...
i organized all of it and trained the AI on:
- agency business models that actually scale
- how to land and keep high-ticket clients
- his exact content strategy for building authority
- media buying frameworks that print money
- positioning yourself above the competition
- the mindset + systems that got him to 8 figures
and much more
this AI answers ANY agency/business question using iman's exact playbooks
it references real content with zero hallucinations... just pure, organized knowledge
the info was always there for free but scattered, unorganized, and impossible to consume all at once
i just put it all in one place so you can actually use it
reply 'IMAN' + RT and i'll give you access (must follow so i can dm)
With Gemini CLI's new pseudo-terminal (PTY) support, you can run complex, interactive commands like vim, top, or git rebase -i directly within the CLI without having to exit, keeping everything in context.
Nano Banana is now live in Search, so you can use Lens & AI Mode to instantly transform photos with our latest image editing model. Here’s a guide to get you started:
1. Open Lens in the Google app for Android and iOS.
2. Tap the new Create mode — look for the yellow banana 🍌
3. Try a suggested prompt, like “make a photo booth pic of me.”
4. Or, snap a picture and describe the edits you’re looking for.
5. Use follow-ups to keep editing, or share the image with family and friends.