Selam, @audn_ai 'in modeli kaldirilali bayagi oldu. Insanlar ha oldu ha olacak boyle bir olay bekliyordu sanirim. Kaldirilma sebebi muhtemelen basliktaki offensive-cyber ama digerleri derisked, unrestricted gibi kelimelerle listelenenlere bir sey olmuyordu hala olmuyor gibi ama yeterince trend olursa el birligiyle hepsini kaldiracaklar muhtelemelen ve hugging pirate gibi bir servis cikacak. Ilk paylasan ve trend yapan arkadas hatta bunun zaten olacagini dusunup bir servis baslatmisti.
Zaten bu tarz model editlerinde calisan cok ekip yok 30'u gecmez muhtemelen. Bizim kendi aramizda modelin ters promptlar verildiginde yararli olma olcegini arastirdigimiz kucuk bir calisma grubumuz var. Amac tamamen ters durumlar yaratacak veya stress testing yapilmasi gereken durumlarda yardimci olan model uretmekti. Bana az daha otonom yapay zekayla surulen bir arac carpiyordu san francisco'da, orada bu tarz modellere olan ihtiyaci gordum gecen sene. 1 senedir o sebeple bu konuya calisiyorum. Hatta ilk uncensored model https://t.co/5uf6rbDd5f 'da dunyada devreye gecen sene ekim kasim civari devreye girdi. O zamandan bu yana bu tarz dusmancil testler yapabilecek AI kendini iyi atfeden (openai,anthropic) sirketlerin inisiyatifinde dagitiliyordu. Gecen gun hatta @audn_ai'in openai hesabi banlandi.
Aslinda ne kadar iyi sebeplerle bir sey uretirseniz uretin ying-yang durumu var burada. Dunya ne big lablarin kendini iyi atfettigi kadar iyi ne de bu tarz kotucul gozuken modellerin aslinda cok iyicil yontemlerle yararli olabilecegini onyargisiz anlayacak kadar basit.
twitter'dan donem donem arsivimi alip gecmis tweetlerime medyalarima vesaire bakarim. bunun icin gelistirdigim bir arac vardi, herkes icin acik kaynakli hale getirdim. direkt tarayicinizda calistirabilirsiniz.
basitce kendi twitter arsivinizi, verilerinizi kimseyle paylasmadan analiz etmenizi, arama yapmanizi incelemenizi kolaylastiran bir uygulama.
Advanced Frontier LLM Coding Benchmark 13.08.2026
Modeller:
- Grok 4.6 Extra High - Cursor
- Opus 5 Max - Claude Code (App)
- Qwen 3.8 Max - Qwen-Code (CLI)
- Kimi K3 Max - Kimi-Code (App)
- GLM 5.2 Max - Zcode (App)
- GPT 5.6 Sol Very High - Codex (App)
- Deepseek-v4-flash-0731 - Qwen-Code (CLI)
- Cursor Auto - Cursor (App)
- Deepseek-v4-pro-0813 - Opencode (CLI)
Görev: Ferrofluid: Metaball yüzeyi + mıknatıs imlecine doğru yükselen Rosensweig dikenleri. Ferrofluid'in zorluğu, "imlece doğru akan sıvı" görünümünün arkasındaki fiziğin bir eşik/bifurkasyon fenomeni olması modellerin %90'ının ıskaladığı nokta.
Not: Bu test oldukça zorlu bir yapıda ve frontier benchmark temeldedir.
Zorluk katmanları:
- Fiziksel modeli doğru anlayıp denklemlere dönüştürme
- Kararlı bir SPH/PBF çözücü geliştirme
- Manyetik alan, yüzey gerilimi ve histerezis davranışını modelleme
- Metaball ve marching-squares ile yüzey çıkarımı
- Ölçülebilir ve dürüst bir self-grading sistemi oluşturma
- Tarayıcıda yeterli performans sağlama
- Görsel olarak anlaşılır bir ürün yüzeyi hazırlama
Modellerin Kullanım miktarları ve süreleri:
- GPT 5.6 - 57m 6s - $82.1
- Opus 5 - 1s 36m - $106.6
- GLM 5.2 - 1h 2m - $35.7
- Kimi K3 - 1h 23m - $57.3
- Qwen3.8 - 48m 1s - $18
- Deepseek-v4-flash-0731 - 1h 25d - $0.79
- Cursor Auto - 25m 15s - $8-9
- Grok 4.6 - 39m - $5.1
- Deepseek-v4-pro-0813 - 2h 51m - $1.92
Modellerin Performans Tablosu:
- Maliyet + Performans Kazanı: Qwen3.8
- Saf teknik ve fiziksel kalite kazananı: Opus 5
- En iyi ultra-düşük maliyetli mühendislik çekirdeği: DeepSeek V4 Pro 0813
- En iyi frontend, ürünleştirme ve gözlemlenebilirlik katmanı: GPT-5.6 Sol
- En iyi düşük maliyetli matematiksel eleştirmen: Grok 4.6
- Performans ve sadeleştirme için en uygun yardımcı model: GLM 5.2
Bağımsız saf teknik başarı sıralaması:
- Opus 5: 86/100 - Düzenli ve gerçek spike trenine en yakın sonuç.
- Qwen3.8: 79/100 - Spike oluşuyor fakat yüksek alanda parçalanma artıyor.
- DeepSeek V4 Pro-0813: 64/100 - Gelişmiş çekirdek, fakat ciddi indeksleme riski ve parçalanma
- GPT-5.6 Sol: 63/100 - En iyi ürün yüzeyi; fizik çekirdeğinde damlacıklaşma
- GLM 5.2: 57/100 - Çok kararlı ve hızlı, fakat tek geniş kubbe üretiyor
- Grok 4.6: 53/100 - Matematiksel olarak iyi düşünülmüş, tarayıcı performansı çok düşük
- Cursor Auto: 47/100 - Hızlı üretim; garip ince kolonlar, parçalanma ve düşük runtime FPS
- Kimi K3: 42/100 - Özellik kapsamı geniş; fiziksel sonuç ve skor güvenilirliği zayıf
- DeepSeek V4 Flash-0731: 32/100 - En ucuz; varsayılan görüntü kullanılamaz ve ölçümler yanıltıcı
Nasıl kullanmalıyız:
- Tek model seçeceksem: Qwen3.8
- Bütçe önemsiz ve en iyi teknik sonucu istiyorsam: Opus 5
- Çok düşük bütçeyle güçlü bir çekirdek istiyorsam: DeepSeek V4 Pro
- Sadece frontend ve ürün kalitesi istiyorsam: GPT-5.6 Sol
- Formül ve algoritma eleştirmeni istiyorsam: Grok 4.6
- Optimization/refactor istiyorsam: GLM 5.2
- Visual QA istiyorsam: Kimi K3
- Cursor Auto’yu model olarak değil, sabit modelleri yöneten agent harness olarak kullanırım
- DeepSeek Flash’ı zorlu caseler dışında, harness yaparak çözeceksem ve disposable boilerplate ile test üretiminde kullanırım.
Introducing GLM-5.3: Built to Code. Ready for Cyber Defense.
- Top-tier coding and agentic capabilities, achieved through post-training on the 743B base model
- A major leap in cybersecurity, setting a new standard among open models
Tech Blog: https://t.co/ekQkO83jCv
🧩 DeepSeek Harness v0.1 is now available in Developer Preview!
🔹 We’re opening it up to developers building agent harnesses worldwide and open-sourcing the codebase in MIT license.
🔹 Powered by the Cordis meta-framework, DeepSeek Harness is an agent harness built around one core idea: Everything is a plugin. Models, tools, skills, sessions, sandboxes, filesystems, loops, orchestration, and UI are ALL implemented as plugins, and can be mixed, matched, replaced, and extended.
Try it now!
https://t.co/2YWSvJHhKA
Bilge ve Yonga çocuk kitapları serisinin dördüncü cildi yayında: "İşlemcinin İçi". Seri artık 47 kitap ve dört cilt; hepsi ücretsiz, açık erişim.
Paylaştığımdan bu yana gelen geri bildirimler için teşekkür ederim. Gelen her ileti seriyi bir yerinden düzeltti; ne değiştiğini anlatayım.
Dördüncü cilt, on iki kitapla işlemcinin içine giriyor: eldenin basamaktan basamağa yolculuğu, eksi sayıların yazılışı, aritmetik mantık birimi, çarpma ve bölme, kayan nokta, veri yolu, bir buyruğun yolculuğu, denetim birimi, tek vuruşluk ve çok vuruşluk tasarım, mikroprogram ve sözcük boyu.
Yayımlanmış ciltlere üç kitap eklendi. Yeni konu açmıyorlar, var olan konuların anlaşılmasını kolaylaştırıyorlar:
• Aynı Rakam, Başka Değer: ikilik tabana geçmeden önce basamak değeri.
• Dediğimi Yap: seri boyunca yüzlerce kez geçen "program" sözcüğü ilk kez tanımlanıyor.
• Bilgisayardan Önce: abaküsten ENIAC'a, sonunda buyrukların da bellekte saklanması fikri. Bu kitabı eşim önerdi.
Bütün kitapların dili baştan sona gözden geçirildi. Kavram yanlışları, kopuk replikler ve belirsiz anlatımlar düzeltildi; her bulgu ders kitabından doğrulandıktan sonra uygulandı.
Yazı tipi değişti. Bir okur, çocuğunun bazı harfleri karıştırdığını yazdı. Gövde yazı tipi artık Andika: okuma öğrenen çocuklar için tasarlanmış, I, İ, ı, l ve 1 harflerini bilerek ayıran bir yazı tipi. 47 PDF'in ve sitedeki okuyucunun tamamında geçerli.
Her kitabın sonuna "Deneme Zamanı" bölümü eklendi: dört soru, dört yanıt. Puan yok, süre yok. Amaç sınamak değil, çocuğun okuduğunu kendi kendine yoklaması.
Site çevrimdışı da okunuyor, telefonun ana ekranına eklenebiliyor. Dört cilt Zenodo'da arşivli, her birinin kalıcı DOI numarası var.
Sırada beş cilt daha var: Durmayan Tezgâh, Yakın Raf Uzak Depo, Gözler Kulaklar ve Eller, Hep Birlikte, Öğrenen Makineler.
Bütün kitaplar burada, ücretsiz: https://t.co/942lGVfdHF
Bu açık erişim projesine herkesin desteğini bekliyorum: okuyun, çocuğunuzla deneyin, yanlış ya da eksik gördüğünüz yeri bana yazın, çevrenizdeki öğretmenlere ulaştırın. El birliğiyle bu seriyi çok daha iyi bir duruma getirebiliriz.
Uzun süredir üzerinde çalıştığım bir projeyi bugün duyurmanın mutluluğunu yaşıyorum.
Bilge ve Yonga: 7-12 yaş çocuklar için 32 kitaplık bir bilgisayar mimarisi serisi. Tamamı ücretsiz, bugün yayında.
Yıllardır üniversitede bilgisayar mimarisi anlatıyorum. Öğrencilerin çoğu bir işlemcinin içinde ne olup bittiğini ilk kez ikinci ya da üçüncü sınıfta duyuyor. Oysa bu konuların özü, doğru anlatıldığında bir çocuğun rahatlıkla kavrayacağı şeyler: bir anahtar açılır ve kapanır, her şey sıfır ve birle yazılır, işlemci bir buyruğu alır, anlar ve yapar.
Seride meraklı bir çocuk olan Bilge ile küçük robot arkadaşı Yonga var. Bilge sorar, Yonga anlatır. Kumdan yonga nasıl çıkar, bilgisayar neden ısınır, önbellek ne işe yarar, bir program nasıl makine diline dönüşür. Her kitabın sonunda kısa bir "Bugün Ne Öğrendik?" özeti var.
426 sayfa, her sayfanın kendi çizimi var. Kapaklarla birlikte 458 özgün görsel. Tarayıcıda okunuyor, isteyen PDF ya da EPUB indiriyor.
Bir şeyi de açıkça söyleyeyim. Bu seriyi birkaç yayınevine anlattım, destek çıkan olmadı, çoğundan yanıt bile gelmedi. Açık erişimi ilke olarak zaten tercih ediyorum, kitaplar bu yüzden ücretsiz. Ama çocukların kitabı eline alıp sayfasını çevirme deneyimini yaşayamıyor olması benim için bir eksiklik.
Ülkemizde yayıncılığın mürekkep ve kağıt masrafını hesaplamanın ötesine geçmesi gerekiyor. Bir eserin değeri satacağı kopya sayısıyla ölçülmüyor.
Basmak isteyen bir yayınevi çıkarsa kapım açık. Tek koşulum, kitapların dijitalde ücretsiz kalması.
https://t.co/o5sHPrIwzT
@hello_ambi Thanks for the quick clarification and for fixing the form! I’ll try signing up again right now.
Glad to hear it’s actually open globally. Appreciate the fast response 👍
Today, we’re announcing Bonsai 27B: the first 27B-class model to run on a phone.
Bonsai 27B is the new multimodal flagship of the Bonsai family. Based on Qwen3.6 27B, it brings a new capability tier to local AI: multi-step reasoning, structured tool use, long-context workflows, and coherent agentic loops.
Until now, models in this class have been impractical to deploy locally. A 27B model occupies roughly 54 GB in 16-bit precision, and even a strong 4-bit build is around 18GB - too large for a phone and for most laptops.
Bonsai 27B changes that.
It comes in two variants:
• Ternary Bonsai 27B: 5.9 GB, 1.71 effective bits per weight, optimized for laptop-class quality.
• 1-bit Bonsai 27B: 3.9 GB, 1.125 effective bits per weight, optimized for phone-class footprint.
Everything is open-sourced today under the Apache 2.0 license.
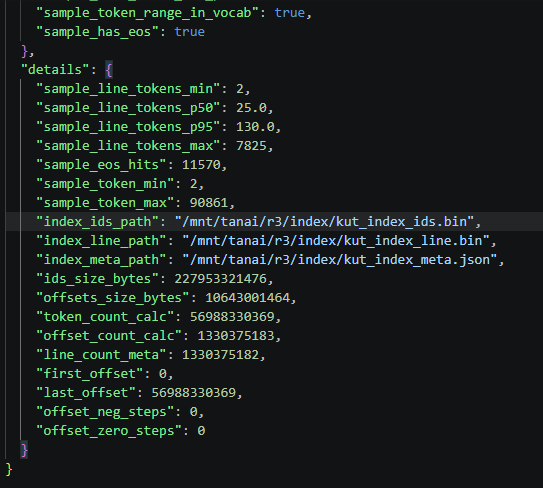
2B Base-LM eğitimi için 57 milyar token tek tek kontrol edilip işlendi. 1.3 milyar temizlenmiş veri satırından üretildi bu eğitim seti. Türkçe Tokenizer'ın sıkıştırma oranı çok yüksek olduğu için, yüksek frekanslarda tokenize edilmiş (yada ingilizce-merkezli bir tokenizerle) veriyle x1.3-1.6 fazla (yaklaşık 80-85 milyar) token olacaktı bu eğitim verisi içerisinde.
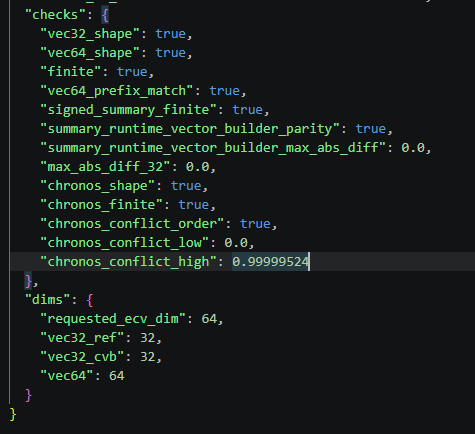
Oluşturulan bu veri seti, Condition Proj 'ların eğitimi için 256D Fused - 64D Emotion - 32D Chronos olarak vektörize ediliyor. Base-LM ilk Epochta 57B tokeni görecek. Condition Traning 'te Projeksiyonlar promttaki anlamsal tutarlıkık, Duygu durumu ve Zaman serisini öğrenecekler.
Vektör setleri Sparse Mod (seyrek - 222GB veri) ile eğitiliyor. (bir MoE'nin eğitilmesi gibi) Dense Mod (yoğun 1.5TB+ veri seti) için oldukça güçlü donanım gerekli ama çıktısı daha iyi olacak bir eğitim türü.
1. görüntü; vec32 ve vec64 shape, NaN/inf kontrolleri, ECV-Chronos davranışları.
2. görüntü; uint32 - uint34 token yapısı ve offsetler, gördüğü max token ve line sayıları.
Evet bu paylaşımlar çok teknik ama Lora-SFT yaparak model yaptım demiyoruz, bir modelin adım adım nasıl geliştirilip eğitildiğinin tecrübesini paylaşmaya çalışıyorum.
Regional pricing would be great. $20 is too high for a student in Turkey; I used to buy it for $10, and I even completed half my project with Qoder. I also really liked the repository wiki, and there are new updates, but the price is too high to buy and try it. If you have any plans for a promotion, please let me know.
postman 400mb ram yerken
hoppscotch 45mb ile aynı işi yapıyor
rust + tauri
offline çalışıyor
hesap istemiyor
açık kaynak
self-host edilebiliyor
rest/graphql/ws/sse/mqtt hepsi var
eğer postman yerine alternatif arıyorsanız göz atmanızı öneririm sistem kaynaklarını çok az kullandığı için ben beğendim. web üzerinde çalışıyor, mac,windows,linux tüm platformları destekliyor
Bu gelişmeyi sizden ilk bekliyordum zaten :) tebrik ederim. TR dataset ile Gemma-4’ü fine-tune etmeniz gerçekten önemli bir adım. Açık kaynak olarak paylaşmanız da ayrı bir değer katıyor.Model yayınlandığında denemek için sabırsızlanıyorum. Emekleriniz için şimdiden teşekkür ederim.
Google’ın Gemma 4’ü telefonda çalıştırmak için resmi bir uygulaması var.
Hem iOS hem Android’de var.
Üstelik:
• %100 open source • tamamen offline çalışıyor • text, ses ve görsel desteği var • Gemma E4B ve E2B ile uyumlu
FREE NANO BANANA PRO FOR EVERYONE!
Exclusively on Higgsfield.
You asked - we delivered. Just visit https://t.co/DMk6vzth7R and enjoy Nano Banana Pro.
For 9 hours: follow, retweet, reply, and like to receive 217 credits (all credits will be delivered in bulk).