KIMI K3의 역설: KV 캐시는 줄었지만 GPU와 HBM 수요는 더 커진다?
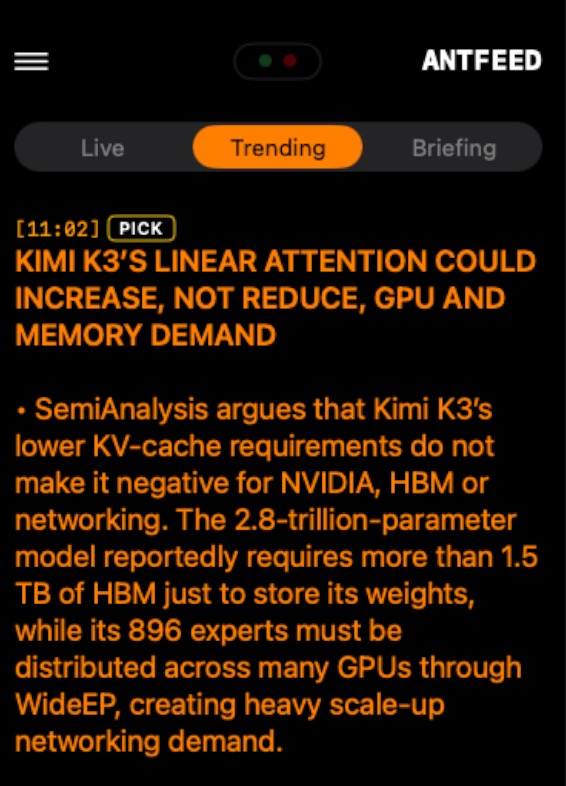
쉽게 말하면: Kimi K3는 데이터를 저장하는 부담은 줄였지만, 모델 자체가 워낙 커서 여러 GPU에 나눠 돌려야 한다. 결국 GPU와 HBM, 네트워크 수요는 줄기는커녕 더 늘어날 수 있다.
기술적으로 말하면: Kimi K3의 KDA는 KV 캐시 전송 부담을 최대 10분의 1로 줄이지만, 2.8조개가 넘는 파라미터와 896개 전문가 모델을 여러 GPU에 나눠 올려야 해 전체 시스템은 오히려 더 많은 GPU, 메모리, 네트워크를 요구한다.
K3의 가중치만 1.5TB 이상의 HBM을 차지한다. 남은 공간이 부족해 KV 캐시는 CPU DDR5와 NVMe로 밀려날 수 있고, WideEP는 수많은 GPU 사이에서 가중치를 주고받기 위해 막대한 네트워크 대역폭을 사용한다.
Kimi도 최적의 추론 환경으로 64개 이상의 가속기를 권장한다. 효율 개선이 하드웨어 수요를 줄이는 게 아니라 AI 사용량과 시스템 규모를 키우는 제본스의 역설이 다시 나타날 수 있다는 이야기다.
*KDA는 이전 내용을 모두 쌓아두는 대신 중요한 정보만 압축해 기억해 KV 캐시 부담을 줄이는 Kimi의 선형 어텐션(linear attention) 기술이지만, 거대한 모델 자체가 요구하는 GPU와 HBM 수요까지 없애지는 않는다.
#KimiK3 #KDA #선형어텐션 #LinearAttention #KV캐시 #KVCache #엔비디아 #NVIDIA #고대역폭메모리 #HBM #디램 #DRAM #AI인프라 #AIInfrastructure #네트워킹 #Networking $NVDA $SKHY $MU $DRAM $SOXX $SMH