

Top Tweets for #GLM55

🚨辟谣!智谱Zai官方研究员亲自下场:GLM-5.5所谓“内部32B、122B和256B检查点”是假消息!
智谱核心贡献者@CunxiangWang 与唐杰老师合作澄清:
这套数字完全是假新闻,起源于一位从未参与基座模型项目的研究实习生用AI生成的博客。
大家要等官方模型卡和正式发布,别被二手拼接带节奏。
#GLM55 #智谱 #ZhipuAI #AI辟谣 #大模型 #GLM #假新闻

I repeated several times in your tweets that "internal 32B, 122B, and 256B checkpoints" is fake news. It is originated from hallucination of some overthinking self-medias, and one research intern's AI-generated blog (who has never been enrolled in the base mode project).
I don’t understand why you persist in spreading misinformation that has already been debunked
🥲智谱GLM 5.5发布迫在眉睫!同行正试图将GLM 5.3丑化成一个笑话!
GLM-5.3在Hy-FrontierMath上直接被同行卷成0.1……
不是0.1分,是只剩0.1的命了!
隔壁都在90+起飞,咱们还在地上找零头。
兄弟们,GLM 5.5再不发,就要变成GLM-0.1永久纪念版了啊!
快!把GLM 5.5从烤箱里端出来!
#GLM55 #智谱加油 #AI卷王大战 #混元 #HY4 #Zai #Zcode #唐杰

🔥数据是AI命根子!DeepSeek、混元、智谱、Kimi的数据军备竞赛!梁圣居然亲自标注模型数据!
晚点LatePost最新文章把国内AI公司的数据真实打法拆开了,核心不是模型架构,是谁在认真“蒸人”。
🔹DeepSeek
绝大多数员工都在干数据相关工作,梁文峰本人偶尔也会下场参与数据标记。数据不是外包部门,是全员主业。
🔹腾讯混元
姚顺雨接手后直接管数据团队,先重新清洗存量数据、迭代基础设施,让混元3 Preview明显超越前代;正式版再优化后训练数据、扩大强化学习规模,能力继续上台阶。
🔹智谱
唐杰明确指出,下一个阶段训练数据量将达到100T。数据规模仍是他们持续加码的核心变量。
🔹Kimi(月之暗面)
训练K3时从海外买了一批芯片设计EDA数据,价格在数百万美元级别;内部编程数据早期大量是实习生“拍脑袋”做的,质量粗糙;同时拒绝了Surge AI的深度独家合作,认为大供应商难持续交付细分长尾数据,更看重自己对数据的品味和敏感度。
数据生产从“众包写对话”变成“还原真实工作轨迹+专家评分清单”,谁能把专家经验变成可规模化的高质量数据,谁就在下一轮拉开差距。
#DeepSeek #混元 #智谱 #Kimi #大模型数据 #晚点LatePost #AI数据生意 #梁文峰 #杨植麟 #唐杰 #姚顺雨


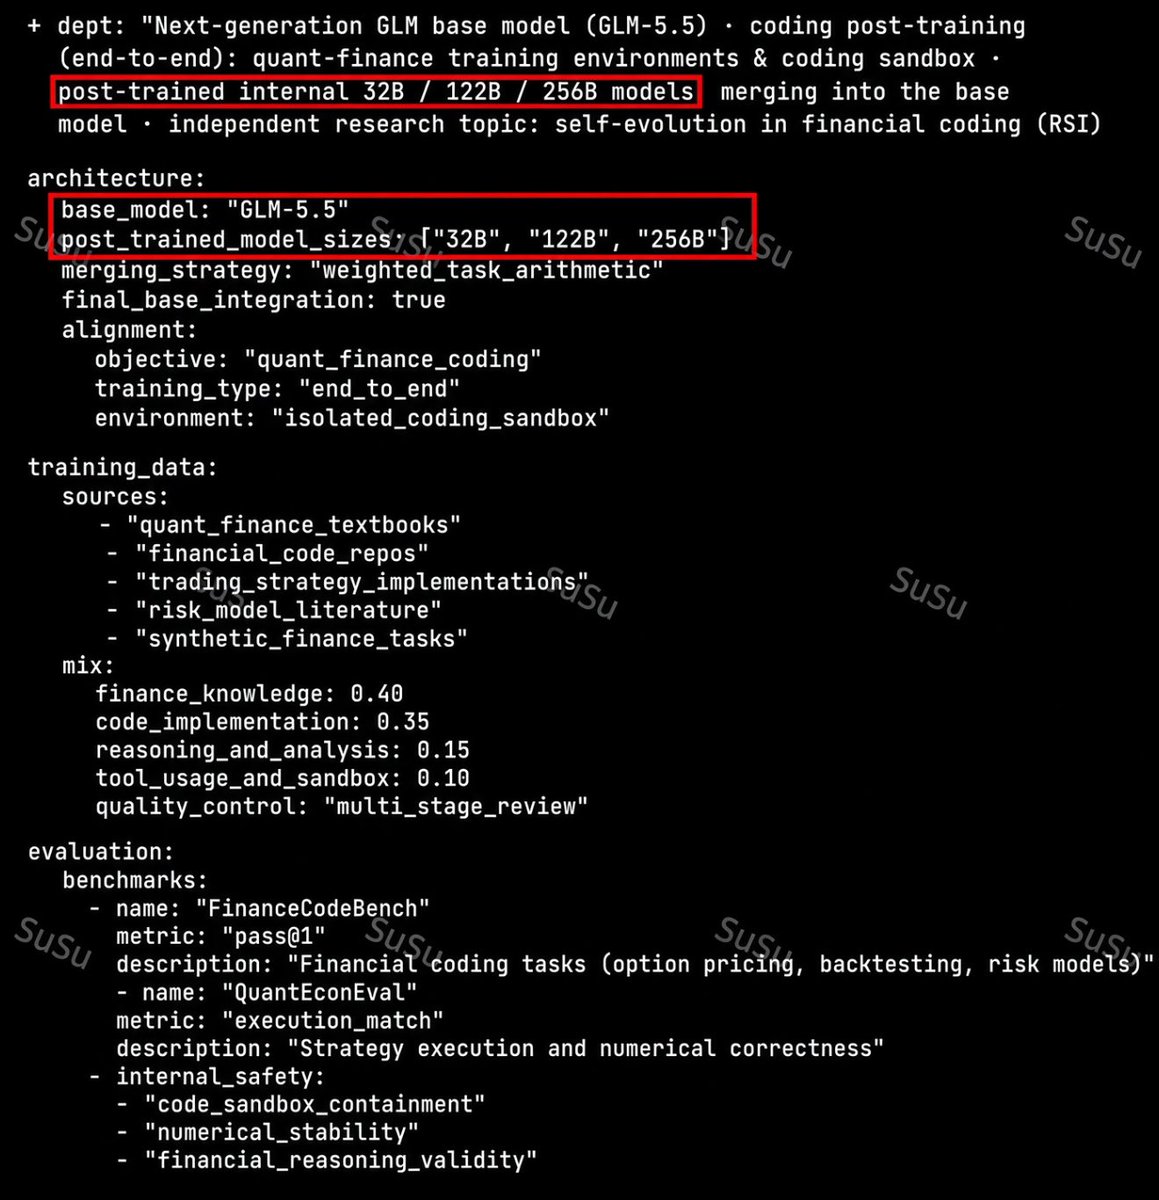

🚨重磅!GLM-5.5 已进入后训练阶段!距离正式发布有近了一步!
智谱 GLM-5.5 已进入深度后训练,内部 32B/122B/256B 模型正在合并进下一代基座。
重点方向:量化金融环境 + coding sandbox + 金融编码自我进化(RSI)
距 GLM-5.3 上线已两个月了,这次旗舰迭代会杀疯了吗?!
#GLM55 #智谱 #GLM #开源大模型 #AI #AgenticAI #大模型 #唐杰 #Zcode

😱炸了!智谱Zai创始人唐杰在清华课堂硬核算账:大模型尽头是算账!揭秘GLM系列模型跑在纯国产芯片是怎么“玩得起”的?!
智谱唐杰在清华课上把“Scaling to be used”摊开讲:算法再巧妙,也得跑起来、玩得起,整节课就是一笔经济账,结合GLM真实经历,把推理成本与国产卡实战讲透。
关键细节:
1️⃣GPU按小时收费,利用率10% = 十倍价格
卡再贵,闲着就是浪费,实际成本直接翻倍。
2️⃣GLM 5.0发布当天量超指数、直接停售
过年把训练卡全拿去推理,年后做研究发现一张卡都没有,半年持续缺卡。
3️⃣1000 TPS超快版:一台机器只能服务一个人
有人说多贵都要,唐杰直说那得百万级一年,最后降到两三百TPS换并发。
4️⃣国产卡实战:底线40 TPS/用户,硬优化到70
现在的Flash就跑在国产卡上,从能跑到能打全是工程硬刚。
5️⃣推理贵的本质:Decode卡的是带宽,不是算力
Prefill能打满GPU,Decode一个token一个token蹦,大部分时间在等数据,H100每读1 byte要做约295次计算才不亏,新卡算力涨得比带宽快。
6️⃣降本两大招
◦压KV Cache:DeepSeek V3每token七万多byte,V4.1 Flash压到890 byte。
◦投机解码:小模型先猜一串,大模型一次性验证,用闲着的算力白捡。
7️⃣Agent最烧钱
每一步重发全上下文、不做缓存命中,token一下刷完。
8️⃣金句:速度本身就是产品
同样的卡,推理好坏能差十倍,极端四五十倍。
GLM Flash正是把这套账算明白后落地的,国产卡集群扛住生产流量,单token成本对标主流GPU,大模型竞赛早就从“堆参数”转向“谁能真正跑得起、用得起”。
速度 × 成本 × 工程能力,才是下一阶段真正的壁垒。
#人工智能 #大模型 #智谱 #GLM #唐杰 #清华 #国产芯片 #推理优化 #DeepSeek #token #AI智能体 #agent #Scaling #Flash模型



Last Seen Hashtags on Sotwe
Most Popular Users

Elon Musk 
@elonmusk
241.2M followers

Barack Obama
@barackobama
118.8M followers

Cristiano Ronaldo
@cristiano
114.5M followers

Donald J. Trump
@realdonaldtrump
111.9M followers

Narendra Modi
@narendramodi
107M followers

Rihanna
@rihanna
98.7M followers

NASA
@nasa
92.3M followers

Justin Bieber
@justinbieber
91.8M followers

KATY PERRY
@katyperry
90M followers

Taylor Swift
@taylorswift13
84M followers

Lady Gaga
@ladygaga
75.5M followers

Virat Kohli
@imvkohli
73.4M followers

Kim Kardashian
@kimkardashian
70.8M followers

YouTube
@youtube
68.7M followers

Neymar Jr
@neymarjr
66.4M followers

Bill Gates
@billgates
65.2M followers

Selena Gomez
@selenagomez
63.1M followers

The Ellen Show
@theellenshow
62.2M followers

CNN
@cnn
61.7M followers

X
@x
60.6M followers