

Top Tweets for #LITERT

👉 v0.2.0 is out. Try it, read the code: https://t.co/dkP79qWa4y
Thanks @GoogleDeepMind @googlegemma @googleaidevs @AndroidDev @Qualcomm @Snapdragon @Snapdragon_IN @huggingface 🙌
#OnDeviceAI #EdgeAI #Gemma #LiteRT #Android #Snapdragon #OpenSource #AI

Fast forward, and I’m back to exploring on-device ML, this time with Kotlin and LiteRT.
I’m documenting what I learn in a new series, starting with the basics and eventually getting into on-device GenAI.
Part 1 👇
https://t.co/PeL61t99Dg
#Kotlin #LITERT #ondeviceML #Tensorflow

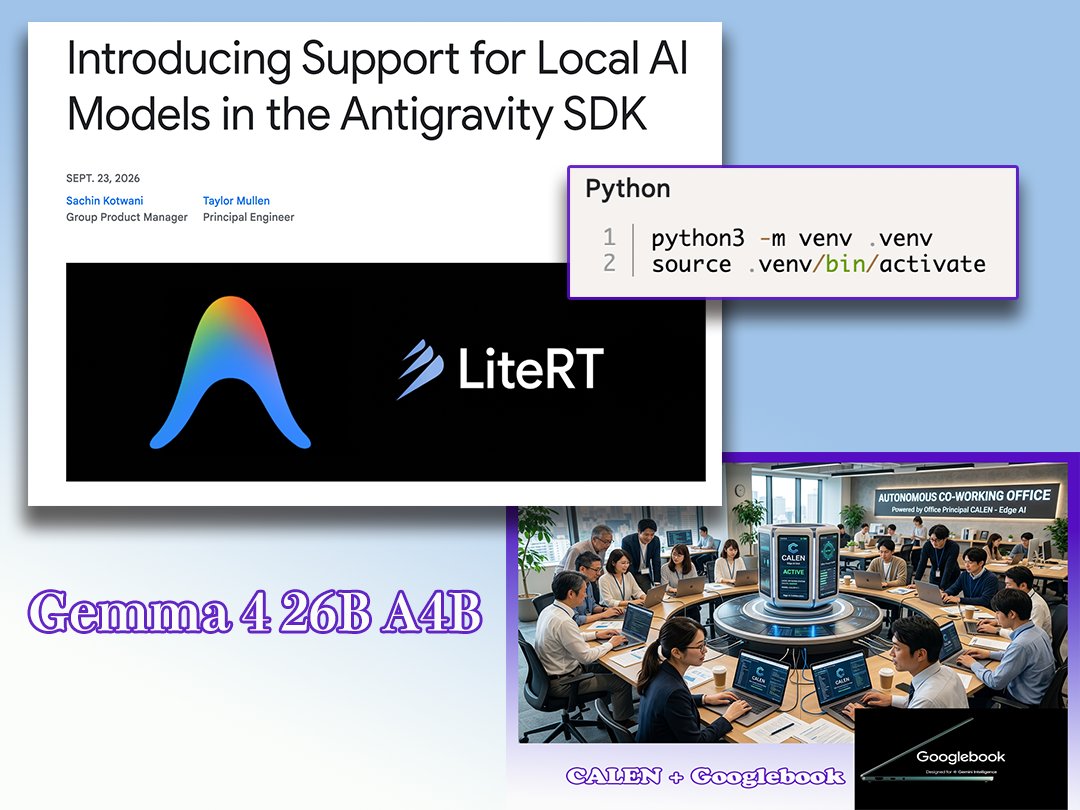
Google AI Edgeの #LiteRT エンジンを使って、Google Antigravity SDKでGemma 4を完全にオフラインで実行できるようになりました。
Gemma 4 26B A4B は目安 24GB以上のVRAM / 統合メモリ、ダウンロード約 16.8GB。
「AI Office Principal CALEN」にとってもいいニュースです。
更に、#CALEN の協働環境が調います。
この、python3 -m venv venv ↩️
何度、タイプしたことか 😊
Docker 利用の方は、多いとは思いますが、
・ゼロ・オーバーヘッド
・リアルタイム性・GPIO/アクセスの容易さ
・rsync による爆速同期
一方で、Python環境の「絶対パス依存」に注意
#AIエージェント #AIアプリ開発 #LiteRT

🚀 Le futur de l'inférence se joue à la périphérie
#KingLand #IA #AnnuaireIA #GoogleAIEdge #EdgeComputing #TensorFlow #MachineLearning #DeviceIntelligence #LiteRT
L'intelligence artificielle doit-elle nécessairement habiter les serveurs distants pour conserver sa puissance de traitement ?
✨ Explorer Google AI Edge : https://t.co/1olwlX73Ff
Parce qu’avec l’évolution constante des infrastructures, comprendre la transition vers LiteRT 2.2.0 vaut mieux que subir l'obsolescence des anciens modèles. L’écosystème Google AI Edge consolide désormais sa mutation via LiteRT-LM 0.16.1 et l’API CompiledModel dédiée à l’accélération GPU et NPU.
Ce changement pourrait radicalement réduire la dépendance au cloud pour les applications critiques exigeant une faible latence. Le marché pourrait bientôt voir émerger des déploiements locaux nettement plus fluides et performants pour les terminaux mobiles.
🔍 Insight stratégique : La souveraineté de la donnée passe par une décentralisation accrue des calculs complexes.
🤖 Insight technologique : L’API CompiledModel permet d'extraire une efficacité matérielle inédite sur les accélérateurs NPU.
📈 Insight business : Le coût opérationnel des infrastructures cloud diminue mécaniquement avec la montée en puissance de l’inférence locale.
💡 Insight créatif : Le design d'applications hybrides devient le nouveau standard pour concilier réactivité instantanée et puissance de calcul.
🛡️ Insight risque : La fragmentation des capacités matérielles sur les appareils impose une complexité technique accrue aux développeurs.
🚀 Insight opportunité : Le traitement en local ouvre la voie à des services IA plus confidentiels et accessibles sans connexion internet.
▫️ Fiche Tool : https://t.co/pmVkwUf32V
❝ Le véritable déploiement d’une intelligence robuste ne mesure pas sa force par la taille de son cloud, mais par sa capacité à agir sans délai là où se trouve l’utilisateur. ❞
— C. Pestel
Pour aller plus loin dans l’analyse :
▫️ Dernière Fiche Impact : https://t.co/4MZS5NZpT2
Je vois dans cette transition un basculement majeur vers une informatique où l'appareil devient le seul maître de sa logique. Je m'interroge toutefois sur la capacité des développeurs à maintenir cet écosystème face à la diversité infinie des puces sur le marché. En prenant du recul, il apparaît évident que nous sortons de l'ère du tout-cloud pour entrer dans une hybridation nécessaire. Je reste convaincu que l'avenir appartient aux solutions capables d'allier performance locale et intelligence distribuée.
Selon vous, quelle application concrète sera la première à bénéficier réellement de cette accélération native sur nos appareils ?



L'IA ne se joue plus dans le Cloud. 📲
Et si la véritable révolution de l'intelligence artificielle se cachait dans le creux de votre main, loin des fermes de serveurs ?
#KingLand #IA #Innovation #Tech #LiteRT #MachineLearning #EdgeComputing #TensorFlow #NPU #FutureOfTech
✨ Explorer TensorFlow : https://t.co/DwK06lDsyo
Parce qu’avec l’explosion de l'IA locale, comprendre LiteRT vaut mieux que subir la latence et les coûts du Cloud.
Le passage de @TensorFlow Lite vers LiteRT n'est pas un simple changement de nom. C'est le signal fort que l'industrie bascule de l'IA "centrale" vers l'inférence ubiquitaire. L'enjeu n'est plus seulement de créer des modèles puissants, mais de les rendre autonomes et ultra-réactifs sur chaque terminal.
Nous assistons à la fin de la guerre des frameworks au profit de l'efficacité d'exécution. En unifiant les flux issus de TensorFlow, JAX et @PyTorch sous une infrastructure unique, l'écosystème LiteRT simplifie radicalement le déploiement. L'interopérabilité devient la norme pour survivre.
L'accélération matérielle via les NPU (Neural Processing Units) devient le nouveau champ de bataille stratégique. Les entreprises qui continuent de s'appuyer sur des architectures logicielles rigides risquent de voir leurs applications devenir obsolètes face à des modèles "on-device" capables de traiter l'information en temps réel.
🔍 L'intelligence migre massivement vers la périphérie du réseau (Edge).
🤖 LiteRT unifie l'écosystème en traitant nativement JAX et PyTorch.
📈 L'efficacité énergétique devient le premier KPI du développement IA mobile.
💡 L'exploitation des NPU n'est plus une option, c'est le standard de performance.
🛡️ Le traitement local renforce la souveraineté et la protection des données.
🚀 Le flux de travail unifié réduit drastiquement le "Time-to-Market" des produits.
▫️ Tool Détail : https://t.co/ez0bwrbPxT
"Les outils changent moins vite que notre manière de les comprendre." — C. Pestel
J’ai longtemps cru que la puissance brute des serveurs géants dicterait seule le futur de l’IA. En observant la mue de TensorFlow vers LiteRT, je réalise que la fluidité de l'expérience utilisateur dépendra surtout de notre capacité à miniaturiser l'intelligence. Il y a une forme de sobriété technologique fascinante dans cette recherche de performance locale. Ma conviction est que le prochain grand bond en avant ne viendra pas d’un modèle plus massif, mais d’un modèle plus proche de l'action immédiate.
Votre architecture actuelle est-elle prête à se passer du Cloud pour ses fonctions critiques ?

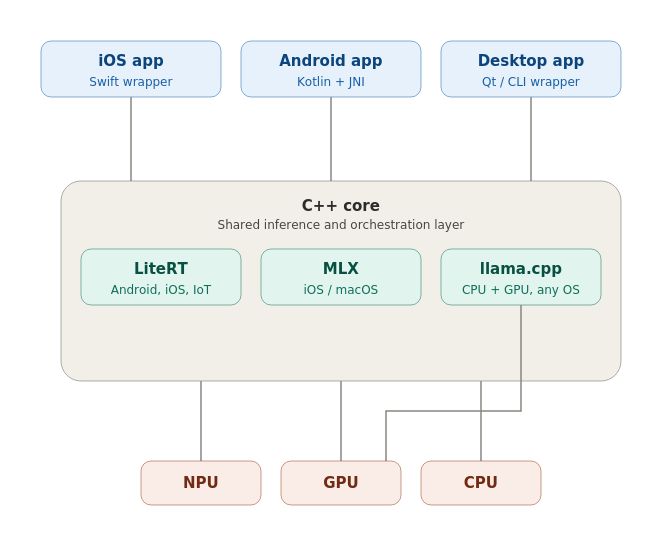
#LiteRT working with @Qualcomm AI Engine Direct is a good example of how NPU acceleration is being surfaced on @Snapdragon platforms.👇🏻

We’re unlocking the #NPU with #LiteRT to deliver high-performance AI that stays cool and fast. 🧠⚡️
Real-world impact and performance at scale:
🔷 Google Meet: Ultra-HD segmentation video effects models for pro-quality backgrounds
🔷 Epic Games: 30 FPS real-time MetaHuman facial animation on Android
🔷 Argmax: 2x speedup in speech-to-text with industry-leading latency
🔷 Google AI Edge Portal: cross-device benchmarking with NPU support
Explore how it works → https://t.co/4WgfzvuviQ

El SETUP VS El RESULTADO 😆😁
Mi primera imagen clasificada ejecutando #LiteRT en una Rpi4 2GB y el modelo preentrenado MobileNet V2 (3.5Mb‼️)
Siguiente lección, entrenar mi propio modelo 🤓
https://t.co/Bhq0XIcibH
https://t.co/331PKhI8Vw


He empezado a aprender 🤓📚 un poco sobre #IA en el Edge (algo que llevaba mucho tiempo queriendo hacer) y no puedo parar de devorar y recomendaros este recurso con ejemplos prácticos para ir aprendiendo sobre una RPi!
#EdgeAI #ML #LiteRT #EdgeImpulse
https://t.co/wRQxNPybZ4
He empezado a aprender 🤓📚 un poco sobre #IA en el Edge (algo que llevaba mucho tiempo queriendo hacer) y no puedo parar de devorar y recomendaros este recurso con ejemplos prácticos para ir aprendiendo sobre una RPi!
#EdgeAI #ML #LiteRT #EdgeImpulse
https://t.co/wRQxNPybZ4

Unlock the full power of MediaTek NPUs with #LiteRT! 🤝 We’ve collaborated with #MediaTek to launch the new LiteRT NeuroPilot Accelerator.
Designed to power the next generation of gen AI across mobile and IoT, it features:
⚡️ Flexible Ahead-of-Time (AOT) and online compilation workflows
🧠 Optimized support for #Gemma and Qwen models
🚀 Up to 12x speedup over CPU
🔄 Zero-copy data passing with Native Hardware Buffer Interoperability
Ready to productionize your AI? Start building today: https://t.co/oMhbG6wrAe


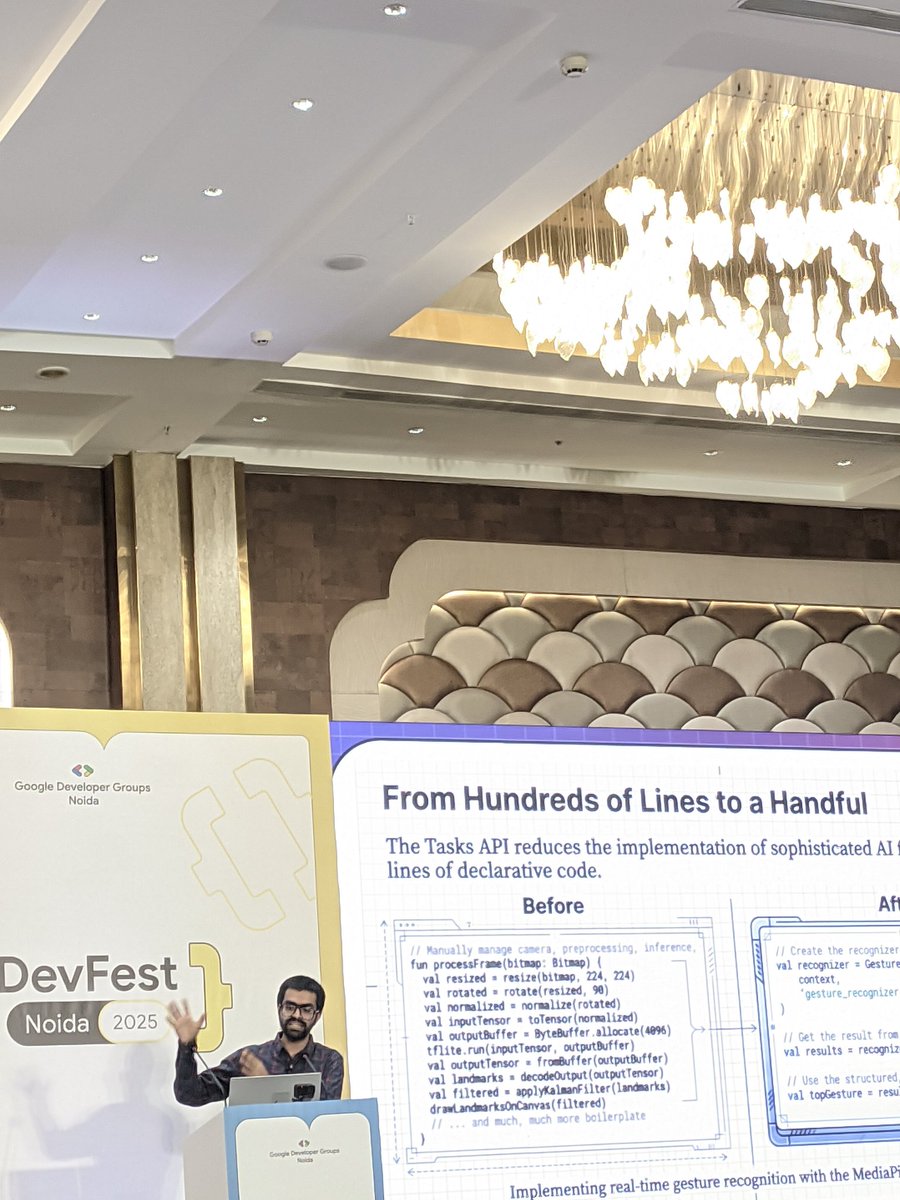
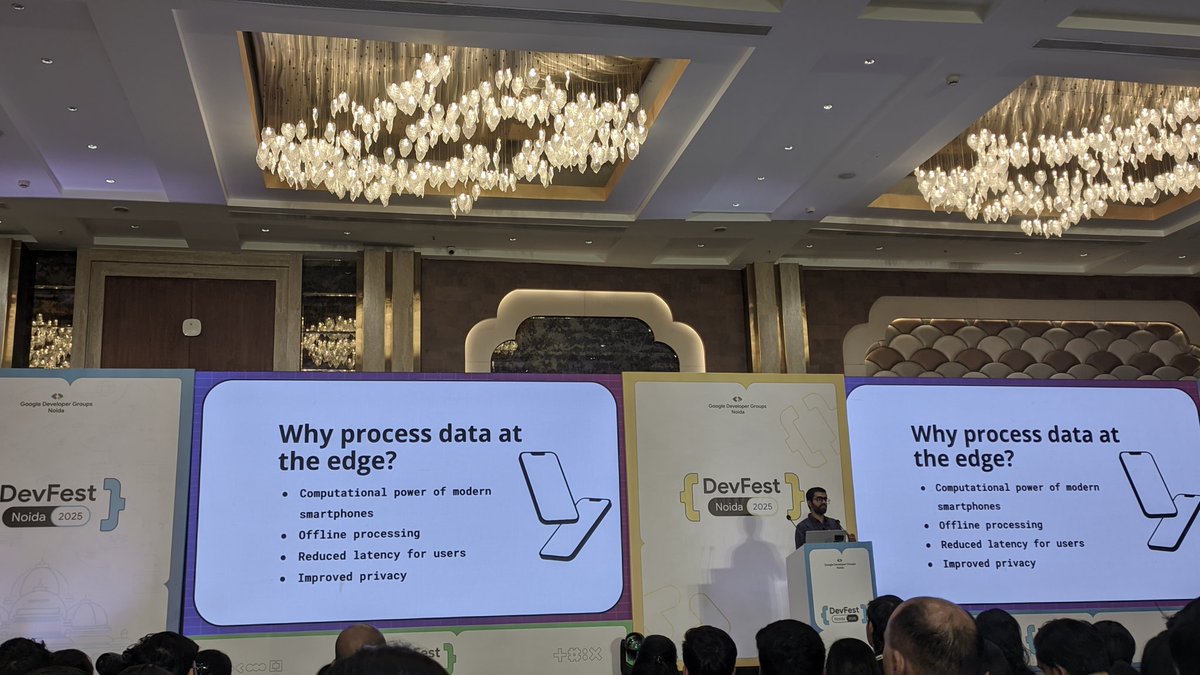
From blending Gemini’s cloud intelligence to running fast on-device AI with LiteRT, this session showed how the future of mobile apps is being built right now. 🔥📱🤖
#DevFestNoida #Gemini #LiteRT #AI #MobileAI #GoogleDevelopers #GDGNoida #BuildWithAI #AndroidDev



Build smart. Run local. Learn from the best.
👉 RSVP: https://t.co/jbHiReNlGR
#BuildWithAI #AIDURG #OnDeviceAI #LiteRT #Qualcomm

Last Seen Hashtags on Sotwe
kamavahini
Seen from India
ChorPhasGaya
Seen from United States
ShivBabaWelcome
Seen from United States
เขื่องใน
Seen from Thailand
laborwhitemale
Seen from United States
omorashi
Seen from India
เย็ดแม่ยาย
Seen from Thailand
homemade #blowjob
Seen from Spain
slutwife
Seen from Netherlands
mahirakhanlove
Seen from United States
Trends for you
Most Popular Users

Elon Musk 
@elonmusk
241.7M followers

Barack Obama
@barackobama
119M followers

Cristiano Ronaldo
@cristiano
114.5M followers

Donald J. Trump
@realdonaldtrump
111.9M followers

Narendra Modi
@narendramodi
107.2M followers

Rihanna
@rihanna
98.7M followers

NASA
@nasa
92.4M followers

Justin Bieber
@justinbieber
91.8M followers

KATY PERRY
@katyperry
90M followers

Taylor Swift
@taylorswift13
84M followers

Lady Gaga
@ladygaga
75.5M followers

Virat Kohli
@imvkohli
73.4M followers

Kim Kardashian
@kimkardashian
70.9M followers

YouTube
@youtube
68.8M followers

Neymar Jr
@neymarjr
66.4M followers

Bill Gates
@billgates
65.2M followers

Selena Gomez
@selenagomez
63.1M followers

The Ellen Show
@theellenshow
62.3M followers

CNN
@cnn
61.8M followers

X
@x
60.7M followers