Je viens de lancer crawl-ia un outil gratuit pour vérifier si votre site est réellement accessible aux robots d’IA et archivé par Common Crawl
Pourquoi cet outil ?
Une commande circule beaucoup pour vérifier la présence d’un site dans Common Crawl :
curl "https://index.commoncrawl. org/CC-MAIN-2026-34-index?url=DOMAINE/*"
Le problème : voir son domaine apparaître ne signifie pas forcément que ses pages ont été archivées.
Common Crawl peut n’avoir conservé que :
→ le fichier robots.txt
→ une redirection
→ une erreur de crawl
→ un diagnostic technique
Votre domaine est alors déclaré « présent », alors qu’aucune véritable page de contenu n’est disponible dans l’archive.
C’est précisément pour éviter cette mauvaise interprétation que j’ai créé https://t.co/SlPxLyWtWA.
L’outil réalise trois vérifications complémentaires.
1. Ce que votre robots.txt autorise
Il analyse les règles appliquées à plusieurs robots :
→ CCBot
→ GPTBot
→ ClaudeBot
→ PerplexityBot
→ Google-Extended
Cela permet de voir rapidement quels robots sont autorisés ou bloqués, en tenant compte des règles spécifiques qui peuvent remplacer le groupe général User-agent: *.
2. Ce que votre serveur répond réellement à CCBot
Un robots.txt peut autoriser CCBot alors que le serveur lui renvoie quand même une erreur 403.
Le blocage peut venir de :
→ Cloudflare
→ un WAF
→ LiteSpeed
→ Akamai
→ Sucuri
→ une extension WordPress
→ une règle de sécurité de l’hébergeur
L’outil simule donc une véritable requête avec l’agent CCBot et compare la réponse avec celle envoyée à un navigateur classique.
Il vérifie également la quantité de texte reçue.
Pourquoi ? Parce que Common Crawl n’exécute pas le JavaScript. Une page peut répondre en 200 tout en ne servant presque aucun contenu exploitable au robot.
3. Ce qui est réellement archivé
https://t.co/SlPxLyWtWA interroge les index de Common Crawl et sépare clairement :
✅ les véritables pages archivées
⚠️ le robots.txt uniquement
❌ les erreurs et diagnostics de crawl
Vous pouvez analyser la dernière version ou comparer les 3 à 6 dernières collections.
C’est important, car chaque version de Common Crawl est un échantillon du Web : un site peut être absent d’une collection et présent dans la précédente.
L’outil permet également :
→ d’afficher les URL réellement archivées
→ de vérifier leur statut HTTP
→ de connaître la date de capture
→ d’analyser jusqu’à 10 domaines simultanément
→ d’exporter les résultats au format CSV
Attention toutefois à ne pas tirer de conclusion trop rapide.
Être présent dans Common Crawl prouve que le contenu a été exploré et archivé. Cela ne garantit ni qu’il a été conservé dans un jeu de données d’entraînement, ni qu’un LLM l’a utilisé, ni que votre site sera cité dans une réponse.
Il faut distinguer trois étapes :
1️⃣ Être archivé
2️⃣ Être retenu après les filtres de qualité et de déduplication
3️⃣ Être cité par un assistant IA
Ce sont trois mécanismes différents.
Mais si aucune véritable page de votre site n’est archivée et que les robots sont bloqués par votre serveur, vous partez forcément avec un sérieux handicap.
L’outil est gratuit, rapide et ne demande aucune inscription :
👉 https://t.co/0pwG4mnbYf
Testez votre domaine et partagez-moi vos résultats. Je suis curieux de voir combien de sites pensaient être présents dans Common Crawl alors que seul leur robots.txt avait été conservé.
Bilan :
- Il est très différent des autres moteurs déjà testés
- Faut changer votre harness et l'assouplir beaucoup : avec mes instructions pour éviter à Opus & les autres GPT de faire des conneries, Astra se retrouvait super passif "il faudrait faire ça, tu pourrais faire comme ça" et il me laissait en plan avec mes projets. C'est résolu en supprimant des instructions qui sont du coup devenues inutiles / contreproductives
- Il m'a refait un tool de scrap qui était mal pensé par deepseek et qui tourne maintenant comme une horloge. C'est pas vraiment une suprise évidemment.
- sur le non code, il m'a organisé un week end avec les réservations et les diffférents billets en quasi autonomie, il a l'air pas mal pour le non code.
-il est relativement lent à répondre mais moins qu'Opus, Hermes ajoute de la lenteur, faut que je revois mon setup
Rien de vraiment activable dans mes retours, désolé. Il fait ce que tu lui demandes brillamment, et on est en AGI maintenant
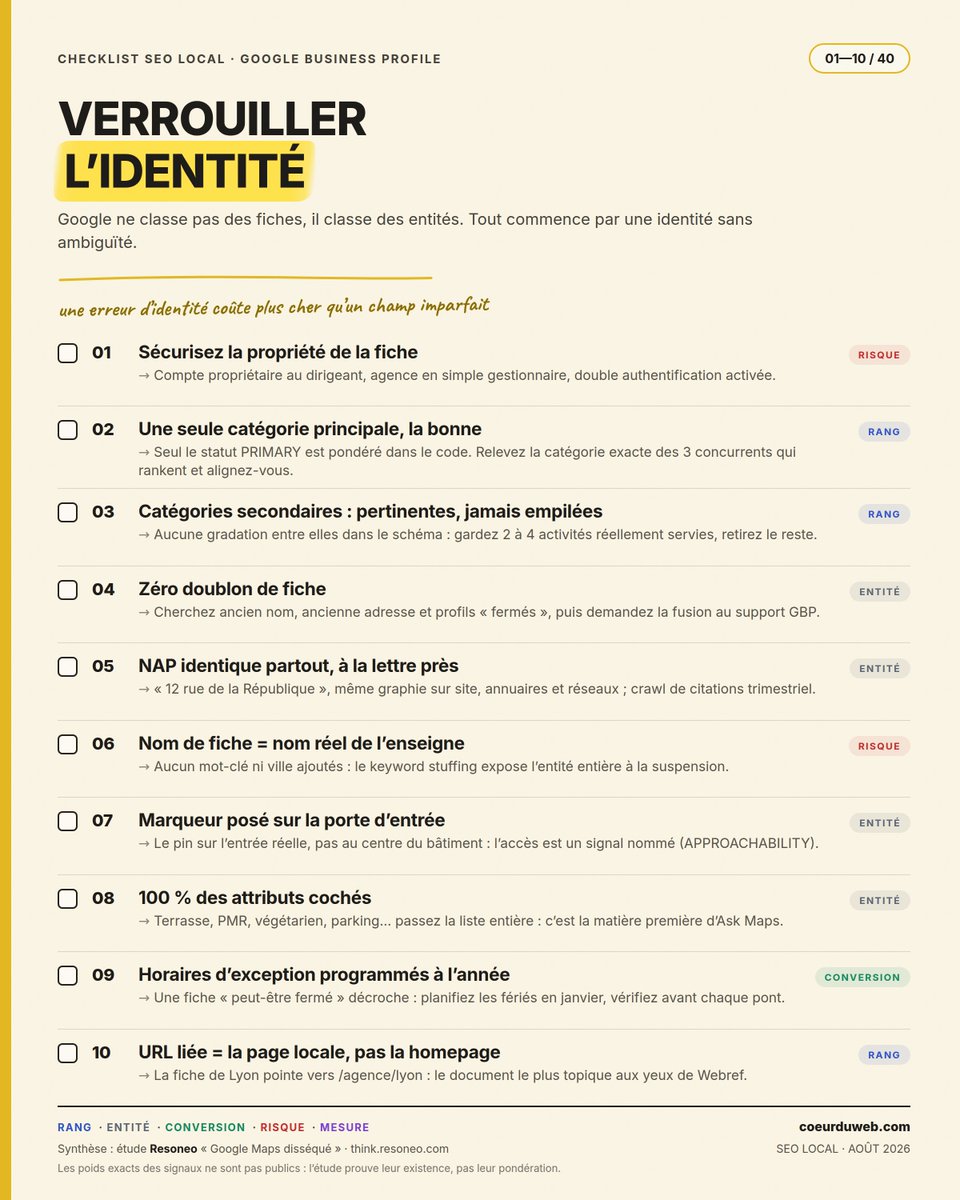
L'équipe @resoneo a disséqué Google Maps : 1 623 schémas internes analysés, les 72 signaux du ranking local mis à nu. Probablement L'étude SEO local de l'année.
Le génie, c'est eux. J'ai juste compressé leurs 35 chapitres en 4 checklists grâce à mon stagiaire IA : Top 40 actions pour votre fiche Google. 👇
Meet Duolingo for Marketing.
Just enter your website URL, and Fastlane will create thousands of accounts and videos promoting your product in seconds.
This is honestly crazy.
Je m'amuse à faire quelques sites sur Astro, Cloudflare Pages avec hermes et deepseek pro & flash juste pour la plaisir de faire des sites sans enjeux ni cette immondice de Wordpress 7
Avec le Kanban d'Hermes, tes agents font chacun leur job facilement (seo, tech, content, planif) et surtout avec la planification les sites vivent seuls, se pluggent à des API et s'administrent via telegram si t'as envie d'y mettre ton grain de sel (plus jamais de ma vie je me connecte sur Gubenberg)
Avec des skills spécifiques pour "garder la GSC clean", choisir les sujets à traiter, utiliser telle ou telle api en autonomie (payhawk = CB plafonnée), auditer les pages qui rankent entre 5 et 25 et update les contents", garder les logs CF cleans, donner aux visiteurs les contenus qu'ils aiment via CF Analytics c'est devenu si facile
Exemple: Tu lui dis "ajoutes les classements UFC" et ça va trouver un service à scrapper/un token API, construire des pages optimisées, planifier des mises à jours hebdo du contenu et optimiser selon les rankings GSC/kw ahrefs & dataforseo en même temps et l'agent seo va optimiser le maillage interne et le netlinking via l'API Linkuma si nécessaire
J'ai passé l'age de lancer ça at scale mais faudrait pas trop chauffer mes agents non plus, un coup de MCP Catchdoms et ça peut partir
@adrienrusso Ouais tout est analysé / stocké et refine dans obsidian et quand je fais des docs de recherche ou de synthèse l’IA m’envoie des liens tracker et le tracker avec des pixels pour voir ce que j’utilise vraiment ou pas et adapter :)
je déteste les skills publiques en général (elles font + de mal que de bien) mais une des rares que j'utilise régulièrement c'est "unslop" de @Cedric_r disponible sur son site: https://t.co/sV1zdZXkRX
La meilleure API pour scraper les résultats Google actuellement
Je teste pas mal de solutions SERP dans mes workflows SEO.
Et il y en a une qui mérite clairement plus de visibilité : SemScraper, l’API développée par l’équipe derrière Monitorank
Pourquoi elle est intéressante ?
1 - Une API pensée par des gens qui connaissent vraiment les SERP
Scraper Google proprement en 2026, ce n’est plus simplement :
→ envoyer une requête
→ récupérer 10 liens
→ parser le HTML
Google introduit énormément de variations dans ses résultats.
Localisation, device, datacenters, personnalisation, tests, blocs enrichis…
Sans parler des variations artificielles / “shadow SERPs” qui peuvent complètement fausser un système de tracking.
C’est justement l’un des gros points forts de SemScraper c'est globalement fiable ce qui permet de faire des corrélations/causalités ranking selon tes actions sans trop se tromper.
L’infrastructure est conçue pour absorber une partie de ce bruit et restituer des SERP exploitables.
2 - Des résultats fiables en temps réel
Pas besoin de travailler avec des SERP mises en cache pendant des heures.
Tu envoies ta requête → l’API interroge Google → tu récupères les données d'un ou des mots clés.
Pour du monitoring SEO, de l’analyse concurrentielle ou la construction d’un outil maison, c’est essentiel.
3 - Le prix est particulièrement agressif
C'est autour de 3,10 € les 1 000 requêtes selon l’offre utilisée.
Quand tu commences à scraper plusieurs centaines de milliers de SERP par mois, la différence de prix avec d'autres API fait la différence.
4 - Les AI Overviews sont maintenant scrapables
SemScraper permet désormais de récupérer les AI Overviews de Google.
Et ça ouvre énormément de possibilités côté SEO/GEO :
→ détecter les requêtes déclenchant une AIO
→ suivre leur apparition/disparition
→ analyser les domaines cités
→ identifier les sources utilisées par Google
→ comparer AIO et résultats organiques
→ mesurer la visibilité d’une marque dans les réponses génératives
→ constituer son propre historique de données
On passe progressivement du rank tracking au visibility tracking dans les moteurs génératifs.
Et avoir accès à ces données via API devient extrêmement précieux.
5 - Il y a évidemment quelques limites
SemScraper reste avant tout spécialisé dans l’écosystème Google SERP mais on ne peut pas scraper les Maps par exemple.
6 - C’est français
L’outil est développé par l’équipe derrière Monitorank, qui travaille sur les problématiques de tracking Google depuis des années.
Avec l’arrivée des AI Overviews, je pense que les API SERP vont devenir encore plus stratégiques.
Parce que suivre uniquement sa position 1, 2 ou 3 dans Google ne suffira plus.
Il faut aussi savoir :
“Est-ce que ma marque apparaît dans la réponse générée par Google… et quelles sources sont citées à ma place ?”
Grâce à cette API et un LLM de codage vous allez pouvoir créer votre propre Outil SEO efficace.
Qui se rappel de la découverte de la meta SEO où on envoyait du traffic pour boost des positions SEO sur l’URL direct qu’on voulait faire ranker ? (Pas sur les backlinks mais vers la money url)
Le boost de position il disparaissait au bout de 24h-72h (parfois 1h) après arrêt de l’envoie du traff. L’apport du traff direct sur l’url cible sur le ranking est éphémère. Et on parlait de dizaines / milliers de clics DIRECT
Ensuite, plein de gens l’ont testé : l’envoie de traff vers les backlinks bah ça marchait pas pour le ranking de la money url (Sauf quand un mec cliquait par hasard sur l’url cible du BL, et ça reste temporaire le gain)
Donc maintenant avec les courbes SEMRUSH (mdr), a quel moment ça drive du traff vers les articles avec backlinks et a quel moment une dizaine de mec vont cliquer dessus ? Et même s’ils cliquent, le boost est éphémère
Google veulent tellement pas gérer le ranking par le traff que la meta SEO découverte depuis 2023 (et largement avant par certain) c’est le trust des sites qui font des backlinks et les auteurs de ces sites (pappers, page jaune, chaine youtube, gmb, graph, mairie, CC, etc.)
Les KW d’un site (donc thématique), la qualité d’un root domaine (ses liens « rare »), le maillage interne, son trust et ses auteurs, c’est 95% de la puissance d’un backlinks aujourd’hui
=> maintenant comme il n’existe pas de metrics unique pour tout ça, la lecture « facile » pour certain c’est le nombre de DR, pour d’autres ça va etre le DA, TF, Traff etc.
Mais aucune de ces metrics n’est bonne
Et est-ce qu’un éditeur qui maquille un site au niveau de toutes ces metrics ça le rend moins bon en trust ou en thématique ? Je ne pense pas. Manipuler des metrics ça aide à la vente, mais ça ne réduit pas son potentiel à envoyer du jus
J'ai fais pas mal de tests là dessus car j'avais les mêmes problématiques que Mohamed.
Depuis plusieurs semaines j'utilise ces deux instructions (rédigées et optimisées avec Claude) qui franchement, font très bien le boulot
👇
The US government, citing national security authorities, has issued an export control directive to suspend all access to Fable 5 and Mythos 5 by any foreign national, whether inside or outside the United States, including foreign national Anthropic employees.
The net effect of this order is that we must abruptly disable Fable 5 and Mythos 5 for all our customers to ensure compliance.
Access to all other Claude models is not affected.
We apologize for this disruption to our customers. We believe this is a misunderstanding and are working to restore access as soon as possible.
Read our full statement: https://t.co/bwn0sximKZ
⁉️ Pourquoi votre article n'est pas dans Discover ?
🧐 La plupart des éditeurs n'en savent rien. Ils ajustent au hasard.
🔬 L'Eligibility Checker fait le diagnostic GRATUITEMENT et en 30 secondes :
✅ 25+ critères Discover (indexabilité, signaux, qualité, OG, i18n)
✅ Core Web Vitals (PSI mobile)
✅ Audit image hero par IA + alignement titre↔image
✅ Score 0-100 + le blocker exact nommé
✅ Recos avec code prêt à coller + title/desc réécrits par IA
🆓 Gratuit, 3 audits/jour, sans inscription
👉 https://t.co/pLWzDSU2W2
Comme quoi, c'est pas que du bullshit
J'ai pris le prompt et mis sur Chatgpt pour l'image et ensuite filer à Seedance via Higgsfield et pas dégeu le résultat