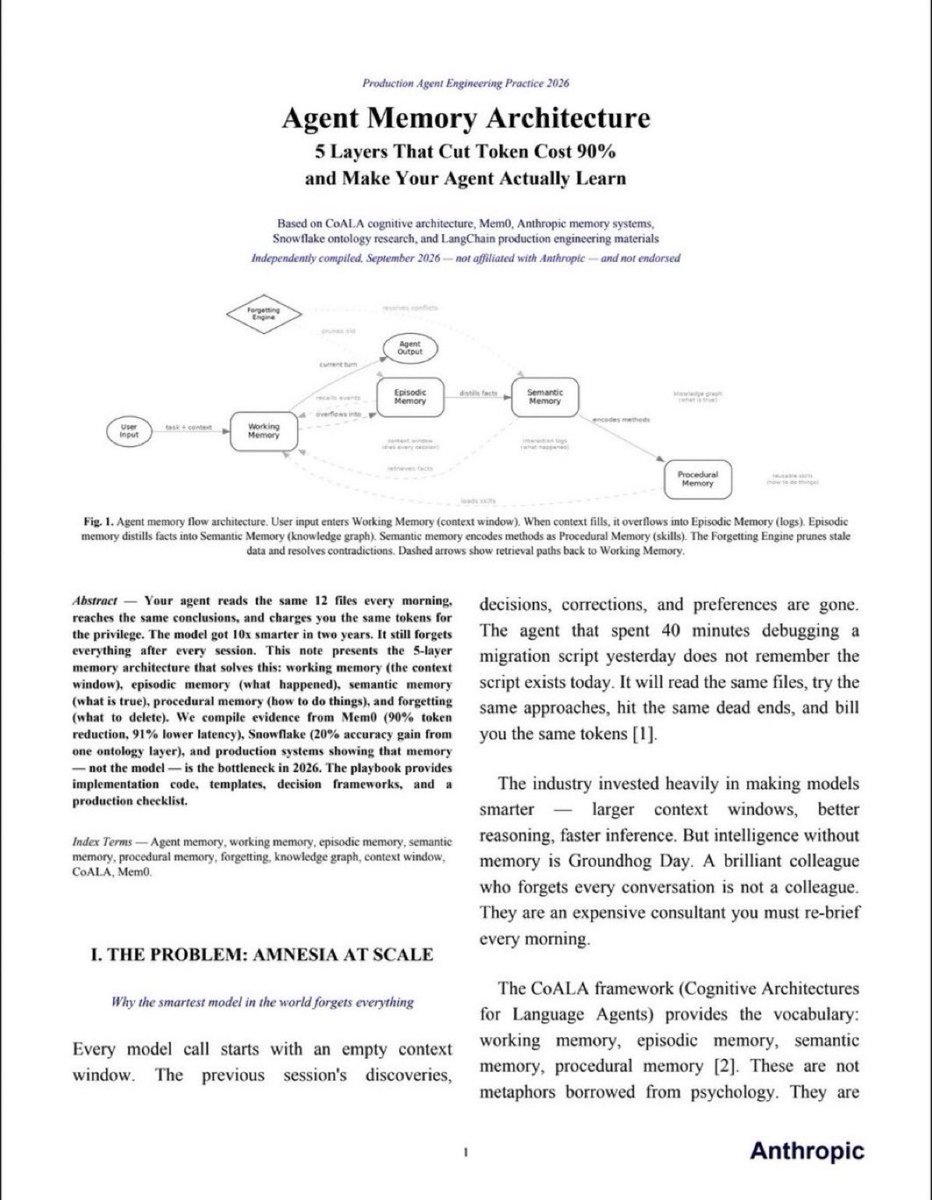
Anthropic acaba de publicar un PDF de 13 páginas sobre memoria para agentes de IA
5 capas para reducir un 90% el coste en tokens y hacer que tu agente aprenda de verdad👇
1. MEMORIA DE TRABAJO: lo que ve ahora
La ventana de contexto. Todo lo que el agente tiene delante en este momento
Cuando se llena, el contexto antiguo se pierde. La mayoría de los agentes se quedan aquí y luego nos preguntamos por qué fallan
2. MEMORIA EPISÓDICA: lo que pasó
El historial completo de interacciones, con fecha y hora
El agente recuerda que el despliegue falló el martes a las 3 de la mañana porque el script de migración tenía una errata
No tienes que explicárselo otra vez
3. MEMORIA SEMÁNTICA: lo que sabe
Hechos, entidades y relaciones guardados en un grafo de conocimiento
«El usuario prefiere TypeScript» vive aquí
Y no desaparece cuando termina la sesión
4. MEMORIA PROCEDIMENTAL: cómo hacer las cosas
El agente prueba 3 enfoques. Uno funciona
Ese método se convierte en una habilidad reutilizable
La próxima vez va directamente a lo que funcionó
5. OLVIDO: lo que debe borrar
Un agente que nunca olvida acaba acumulando contradicciones
Las preferencias antiguas se imponen a las nuevas. Te mudas de ciudad y sigue recomendándote restaurantes donde vivías antes
Recordar importa. Saber qué olvidar, también
¿El resultado?
→ Mem0 almacena 1.800 tokens por consulta en lugar de 26.000
→ Snowflake añadió una capa de ontología: un 20% más de precisión y un 39% menos de llamadas a herramientas
La memoria compensa su coste desde el primer día
Este PDF de 13 páginas marca la diferencia entre un chatbot y un agente que aprende de verdad
No lo pases de largo👇
🙏DESIGN.md 모르는 사람 없게 해 주세요
Claude Code가 뽑은 UI, 나쁘진 않은데 어딘가 별로죠🤪
매번 "메인 컬러는 #1A73E8, 폰트는 Inter 16px…" 프롬프트 대신
파일 하나로 끝낼 수 있어요.
구글이 오픈소스로 공개한 📍DESIGN.md
디자인 시스템을 AI 에이전트에게 설명하는 파일이에요.
🎨쓰는 법:
1. getdesign.md에서 Apple, Notion, Figma 등 70개 브랜드 파일 중 하나를 받는다
2. 내 프로젝트 루트에 넣는다
3. 에이전트에게 평소처럼 시킨다.
끝.
Stitch에 URL만 넣으면 내 사이트의 DESIGN.md도 추출해 줍니다. AI 밤티 디자인에 지쳤다면 꼭 써보세요!
오... 졸라 욕부터 나오는 물건 하나 찾았다
전에 한번 공유한거였다.
다시한번 말한다.
이거 물건이다.
회사에서 Fable5로 구축했는데 이거 물건이다.
다시한번 말한다.
내가 웬만해선 꿀팁얘기 잘 안하는데
이걸로 회사 지식베이스 구축하면
너 올해 고과 A+다
돈드는것도 AI 비용밖에 없다
오픈소스 postgres 사용하고
cocoindex로 코드 인덱싱해주는데 정말 군더더기 없다.
난 위키 슬랙 소스코드 다 여기에 인덱싱 하고 있다.
정말 훌륭하고 심플하고 아름다운 아키텍쳐다
그동안 우리는 잘못된 지식베이스를 구축하고 있었다.
llm wiki 그거 내다 버려라
글 잘읽엇슴다
아무튼 주저리:
요즘 AI hype 뽕 오는거 진짜 공감가고 이해는 가.
아니근데 사실 주변 AX타령하는 스타트업 다니는 지인 얘기도 들어보면 막상 까보니까 뭔가 하~ ....
아 뭔가... 문제 정의보다도 문제 해결부터 냅다 토큰 때려박기로 애매하게 처리하고, 진짜 애매~한 수준 빠르게 뽑았다는 걸 기준으로 뿌듯해하면서 냅두는 경우가 너무 많고...
아 ... 아니면 걍 아니 이거 걍 기존 오픈소스 ** / 기존에 쓰고있는 서비스 솔루션으로도 충분히 해결되는건데 막상 ���금 쓰는 서비스들조차도 공식���서 안읽고 ai 짬 때리고... 그런경우도 너무많음.
뭔가 이 글도 마찬가지로....아..스읍...
AI로 기능을 하나하나 만들어서 붙이는 접근 자체는 이해가 가고, 실제로 유용한 부분도 분명히 있긴 한데…
진짜 궁금한 건
토큰당 ROI는 제대로 계산하고 있나?
진짜?
AI로 뭔가를 만들기 전에, 기존에 이미 잘 만들어진 오픈소스나 검증된 솔루션을 충분히 찾아보고 비교한 뒤에 바이브-코딩-custom-서비스로 가는 건지
이게
진짜
제일 궁금하고
글 읽으면서도 납득을 못했음
어? 저거... 걍 음? 왜? 음...약간 이런 느낌
특히 Kubernetes 관련 인프라나, agent를 여러 개 조합해서 쓰는 시스템(하네스) 쪽은 token을 꽤 많이 먹을 수밖에 없는데, 그걸 그냥 “AI가 해주니까” 하고 넘기기보다는 좀더 아 이게 저렇게 ���무 고민없이 ?????? 엥???
하게된
뭐랄까.... 글에서는...어떤 기술 스택과 뭐를 고려했고 어떤것을 대안으로생각했는지 전혀 고민을 않했다? 라고느껴짐...
아니 또 맥락.
그놈에 맥락.
context 관리 이전에 어떤 정보 유형들을 어떻게 어디에 관리해서 그 메모리, 데이터들에 대한 SSOT 유지 시스템을 얼마나 탄탄하게 가져가는지, 정보들이 stale 하거나 drift 하지 않도록 방지하는 가드레일은 반드시 필요한건데
관련
고민을 안했나?
아니 옵시디언그래프 자랑하면 끝이야?
나라면 옵시디언스마트 커넥터 플러그인부터 깔고 RAG 부터 살펴보겟는데 (백퍼 drift 정보 있다에 손목 검)
아니 그리고 옵시디언 깃 플러그인 만든 것도 왜? 왜????? 아니 왜? 그 이유도 이해가안감 왜?
이미 ㅈㄴ네임드있고 옵시디언에서 자체적으로 시크릿 관리 정보 ��고.
아니면 걍 아니 k8s? 왜? 그런 서버 시스템이 사내에?????그렇게 부하가간다고요? pod 개념을 제가 잘못알고잇나??
또 그리고 만든 시스템이 실제로 효율적인지를 정량적으로 측정하고 자체 개선하는 루프가 있는지가 더
더 중요해보이는데..
걍 만들고 땡! 인 느낌? 버전관리는????
아니
물론 무진장 린/에자일하게 빠르게 만들고 실험해보는 건 좋지만, 뭔가뭔가 하..뭔가 아..사치하는걸 보는 느낌.
hype에 올라타서 그냥
야ㅋㅋㅋ다되네 AI로 다 해보자 식으로 가는거
아
양날의검이야
진짜 아 자칫하면 결국 무진장 비용과 복잡도만 늘어나는 건데, 아 뭔가 토큰 물쓰듯이 막쓰는거 아 책임없는 쾌락인거 아는데
아 뭐라해야하나.. 이 감정은...
📍 Obsidian + Claude Code로 나만의 루틴 트래커 만드는 조합
데이터는 Obsidian에 쌓고, 화면·기능은 Claude Code한테 맡기는 방식
⭐기본 뼈대 (Obsidian 무료 플러그인 3개)
① Git - 여러 기기에서 기록이 자동으로 이어짐 (PC·폰 동기화)
② Templater - 매일 같은 양식으로 기록해 포맷이 안 흐트러짐
③ Dataview - 쌓인 기록을 원하는 조건으로 조회
원하는 기능은 Claude Code한테 (코드 몰라도 말로 요청)
- 항목마다 중요도 가중치 (물 마시기와 운동을 다르게)
- 월간 현황 + 연간 히트맵 대시보드
- 메모 붙이고, 쌓인 데이터를 AI한테 다시 물어보기
핵심은 플러그인에 나를 맞추기가 아니라 '보고 싶은 화면을 직접 만들기'
루틴 말고 가계부·독서·운동 기록에도 그대로 응용 가능!!
저장해두고, 나에게 최적화된 앱을 만들어보고 싶을 때 아래 콘텐츠를 읽어보세요
AI 답 보자마자 안심했다면 이미 진 거다
퇴근하고 클로드코드로 뭐 하나 만들 때마다 항상 똑같은 패턴이 있다. 프롬프트 던지고, 결과 나오면 "어 되네" 하고 바로 다음으로 넘어가는 거.
어제 피그마 CPO가 서울 와서 한 말 보고 뜨끔했다. 유키 야마시타라는 사람인데, 요즘 생성AI 시대 제일 큰 위험을 '조용한 항복'이라고 불렀다더라. AI가 만들어준 첫 결과물 보고 '이 정도면 됐다' 하는 순간, 스스로 판단하려는 노력을 멈춰버린다는 거다.
이게 왜 뜨끔하냐면 — 앱스토어에 올라오는 앱은 미친듯이 늘고 있는데, 사람들이 꾸준히 쓰는 서비스는 별로 안 늘었다는 얘기도 같이 나왔거든. 누구나 AI로 비슷한 수준 결과물을 만들 수 있게 됐으니까, 딱 거기서 안주하면 다 똑같은 걸 만들게 되는 거지. 나만 해도 클로드가 첫 판에 던져준 코드 그대로 커밋한 적이 한두 번이 아니다.
네이버 쪽 리더도 비슷한 얘기 했더라. 'AI로 다른 직군 업무를 할 수 있게 된 것'과 '잘하는 것'은 완전히 다른 문제라고. 평균적인 결과물 만들기가 쉬워질수록, 오히려 좋은 결과를 구별하는 감각이랑 취향이 더 중요해진다는 거. 한국 개발자 76%가 AI가 업무방식을 크게 바꿨다고 답했다는데(피그마 조사), 결국 마지막에 '이거 괜찮은 건가' 판단하는 건 여전히 사람 몫이더라.
그래서 요즘 나는 룰을 하나 정했다. 클로드가 첫 답 던지면 무조건 한 번은 '다른 방식으로도 짜줘' 하고 다시 시킨다. 귀찮아도 이 한 스텝 넣으니까 결과물이 확실히 달라지더라. 특히 UI 짤 때 — 처음 나온 레이아웃 그대로 쓰면 딱 봐도 AI가 짠 티가 나는데, 두세 번 비교시키면 그제서야 좀 내 취향이 섞인 게 나온다.
피그마가 이번에 공개한 '위브'라는 기능도 이 맥락이랑 닿아있다. 여러 생성AI 모델을 하나로 엮어서 쓰는 건데, 소규모 인력으로도 서비스 콘셉트를 빠르게 검증할 수 있다더라. 나도 요즘 이미지는 이 모델, 카피는 저 모델, 이렇게 용도별로 나눠 쓰는데 확실히 결과물이 낫다. 첫 답에 만족 안 하고 비교하는 습관, 도구 레벨에서도 이미 그렇게 짜여지고 있는 셈이다.
야마시타가 짚은 또 하나가 '새로운 사일로'인데, 이것도 뜨끔했다. 각자 자기 AI 에이전트하고만 일하다 보니 결과물이 팀 안에서 안 퍼진다��� 얘기다. 나야 혼자 만드니까 팀이랄 게 없지만, 생각해보면 나도 비슷하다. 어제 클로드한테 물어본 거, 오늘 다른 프로젝트 할 때 또 처음부터 설명하고 있더라. 결국 내 AI가 뭘 했는지 나조차 기록을 안 남기고 있는 셈.
근데 이거 말이 쉽지 실천은 진짜 안 된다. 밤늦게 혼자 코드 돌리다 보면 '일단 되잖아' 하고 그냥 넘어가고 싶은 유혹이 매번 이긴다. 나만 그런가.
출처: 천지일보 — 'AI가 준 첫 답' 만족하면 창의성 멈춘다
이거 진짜 맞는 말입니다. 2024 년에도 google notebooklm 에서 생성되던 TTS 는 그당시 어떤 TTS API 들보다 훌륭했지만 구글은 Vertex AI 에도 그것을 등록하지 않았습니다. 지금도 최상위권 수준이에요. pdf 넣고 팟캐스트 만들어달라고 해보세요. 5분도 안되서 논문가지고 토론 하게 합니다.
바이브코딩으로 DB 설계할 때, 기본키는 UUID를 한번 고려해보세요.
보통 처음엔 1, 2, 3, 4처럼 숫자로 증가하는 ID를 씁니다.
간단하고 빠르지만, 외부에 노출되면 이런 문제가 생깁니다.
/users/1001
/users/1002
/users/1003
주소만 바꿔도 다른 데이터가 몇 개나 있는지 쉽게 추측할 수 있습니다.
UUID는 이렇게 생겼습니다. 👇
550e8400-e29b-41d4-a716-446655440000
길고 복잡해서 순서를 추측하기 어렵고, 여러 서버나 앱에서 동시에 데이터를 만들어도 ID가 겹칠 가능성이 거의 없습니다.
그래서 특히 이런 경우에 잘 맞습니다.
- 외부에 ID가 노출되는 API
- 여러 서비스가 데이터를 함께 만드는 구조
- 나중에 DB를 합치거나 분리할 가능성이 있는 서비스
- 주문, 결제, 사용자처럼 식별�� 노출이 부담되는 데이터
물론 UUID가 무조건 정답은 아닙니다. 내부용 작은 테이블은 숫자 ID가 더 단순하고 빠를 수 있습니다.
그래도 사용자, 주문, 게시글처럼 외부에 노출될 가능성이 있는 주요 데이터는 UUID를 기본값으로 잡아두면 나중에 편합니다.
AI에게는 이렇게 말하면 됩니다. 👇👇👇
"외부에 노출되는 주요 테이블의 기본키는 UUID로 설계해줘.
1. 뇌는 행복을 위해 만들어진 기관이 아님.
2. 생존을 위해 만들어졌음.
3. 그래서 즐거움은 잠깐만 켜지고, 곧 꺼지도록 되어 있음.
4. 이걸 쾌락 적응이라고 부름.
5. 좋은 일이 생겨도 뇌는 금방 그 수준을 새로운 기준선으로 삼아버림.
6. 승진도, 새 물건도, 몇 주면 평범해짐.
7. 반대로 나쁜 일은 오래 남음.
8. 부정 편향 때문임.
9. 위험을 잊는 개체는 살아남지 못했으니
10. 뇌는 싫은 것에 더 오래 붙어 있도록 진화했음.
11. 그래서 하루를 돌아보면 따분하고 귀찮은 일만 기억에 남음.
12. 좋았던 순간이 없었던 게 아니라, 저장이 안 된 것에 가까움.
13. 게다가 일상의 대부분은 자동조종 상태로 흘러감.
14. 익숙한 출��근, 익숙한 화면, 익숙한 대화.
15. 뇌는 예측 가능한 것에 주의를 쓰지 않음.
16. 그래서 시간이 통째로 사라짐.
17. 기억은 총합이 아니라 하이라이트로 저장됨.
18. 대니얼 카너먼이 말한 절정과 끝의 법칙임.
19. 몇 개의 강렬한 순간이 그 시절 전체의 인상을 결정해버림.
20. 그러니 재미있는 순간을 놓치지 말라는 말은 낭만이 아니라 실용적인 조언임.
21. 그 몇 개의 순간이 결국 인생의 요약본이 되기 때문임.
22. 방법은 거창하지 않음. 좋은 순간이 왔을 때 잠깐 멈추고 알아차리는 것.
AI 모델을 여러 개 붙이면 정말 더 똑똑해질까?
GPT, 클로드, 제미나이의 답을 한꺼번에 받아 가장 좋은 결과만 고르면 어떨까요. 한 모델이 놓친 부분을 다른 모델이 채워주니, 당연히 정확도가 올라갈 것처럼 보입니다.
최근 AI 업계에서 주목받는 ‘모델 오케스트레이션’도 이런 생각에서 출발합니다. 여러 AI를 불러 답을 비교하거나, 다수결로 결정하고, 문제에 따라 적합한 모델을 골라주는 방식입니다.
그런데 실제로는 생각만큼 효과가 크지 않을 수 있다는 연구가 나왔습니다.
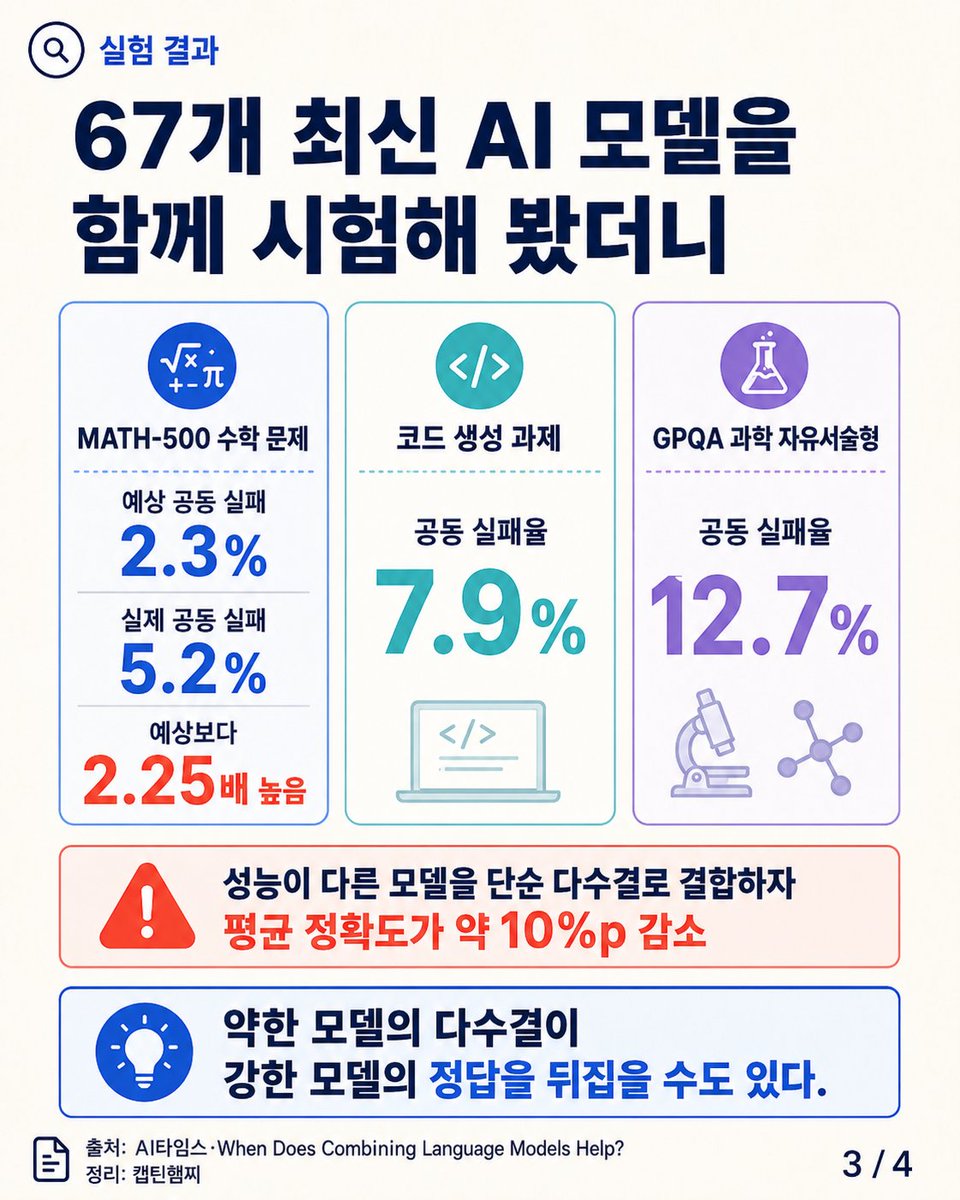
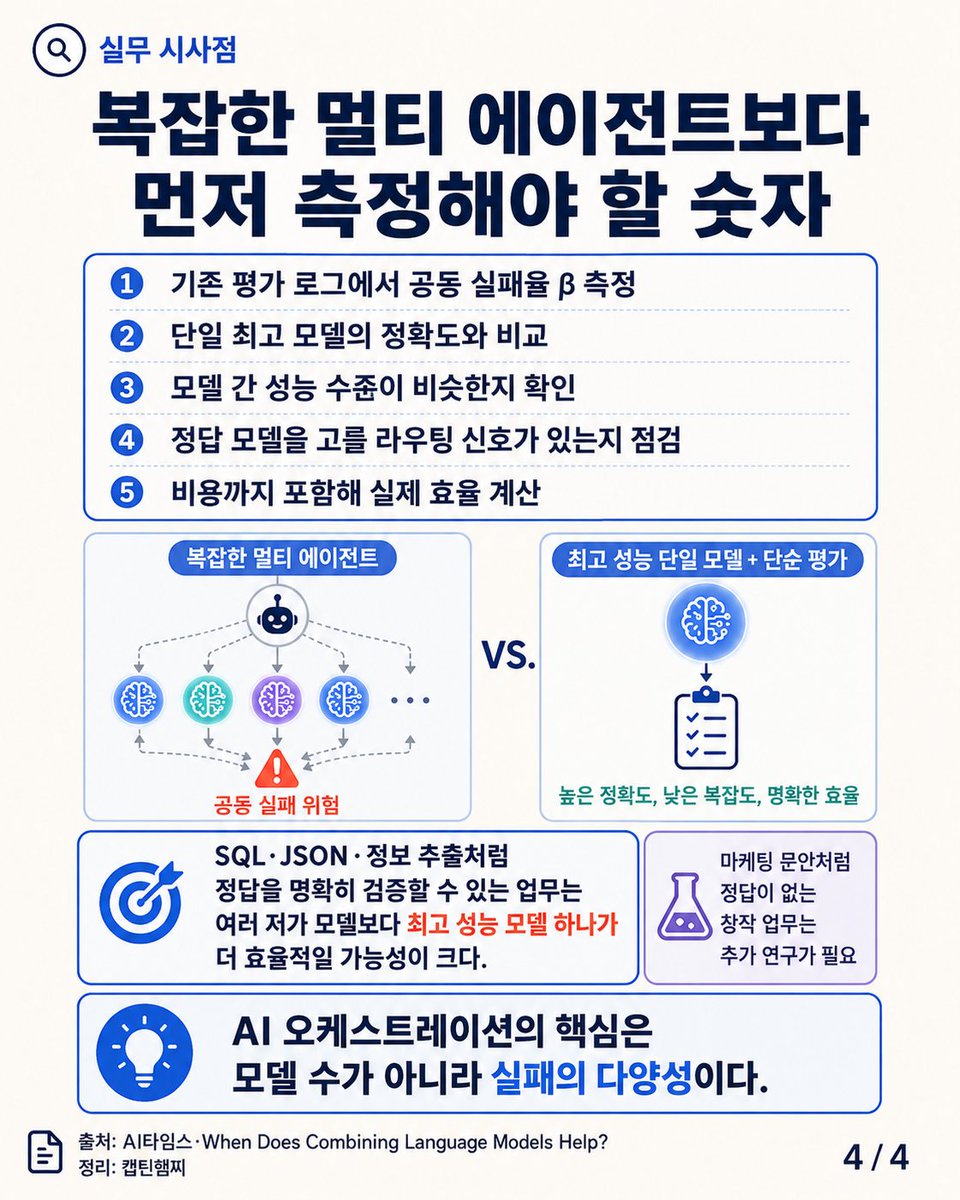
연구진은 21개 기업이 만든 67개 AI 모델을 수학, 코딩, 과학 문제로 평가했습니다. GPT-5.5, 클로드 오퍼스 4.8, 제미나이 3.1 프로처럼 성능이 뛰어난 ���델도 포함됐습니다.
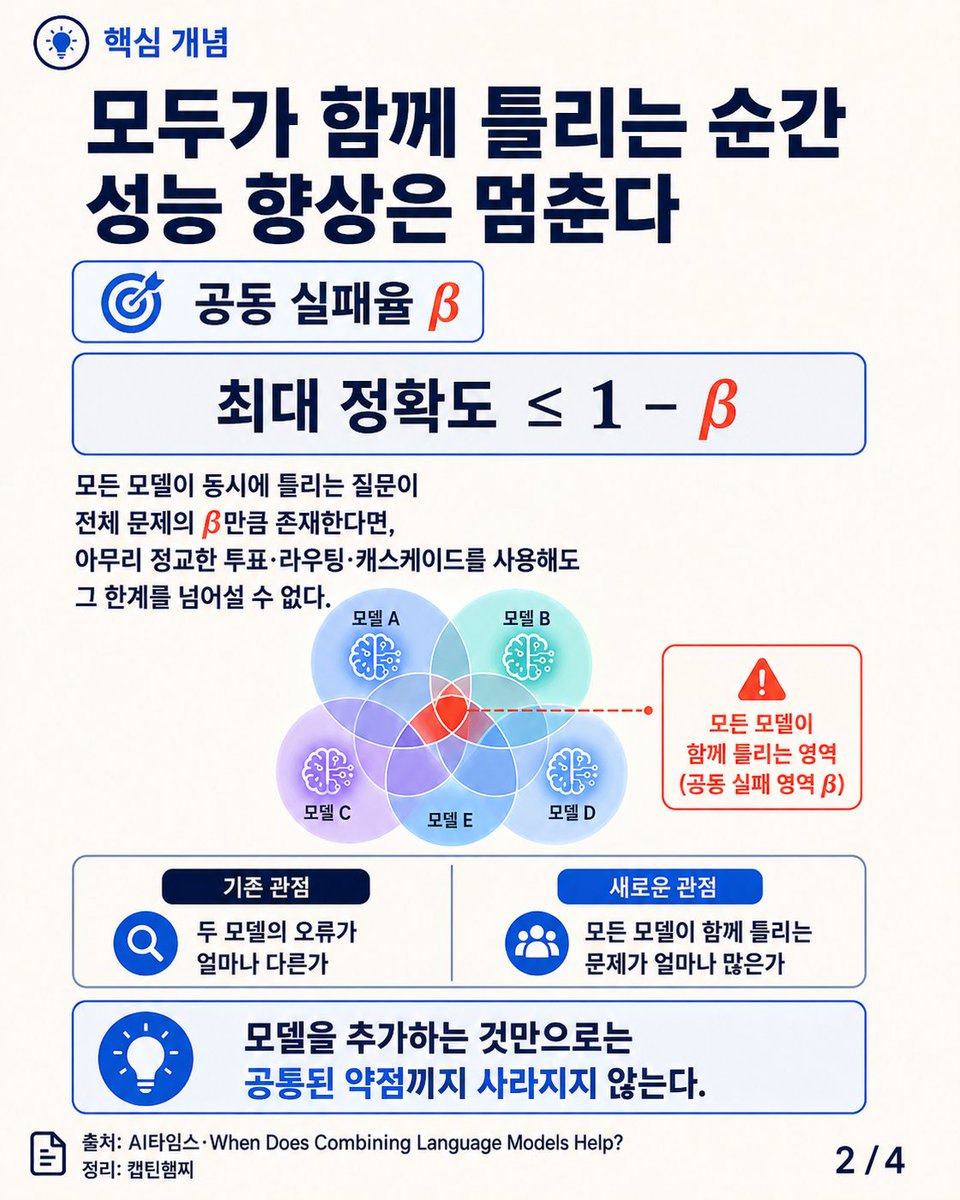
문제는 모델들이 서로 다른 실수를 하는 것이 아니라, 어려운 문제에서 다 같이 틀리는 경우가 생각보다 많았다는 점입니다. 연구진은 이를 ‘���동 실패’라고 불렀습니다.
예를 들어 MATH-500 수학 문제에서 기존 계산 방식은 모든 모델이 동시에 틀릴 확률을 2.3% 정도로 예상했습니다. 실제 결과는 5.2%였습니다. 예상보다 두 배 넘게 높았습니다.
코드 생성 문제의 공동 실패율은 7.9%, 대학원 수준의 과학 문제를 자유서술형으로 바꾸자 12.7%까지 올라갔습니다. 답을 고르는 객관식보다 직접 설명해야 하는 문제에서 모델들의 약점이 더 뚜렷하게 드러난 셈입니다.
모델을 많이 붙인다고 이 한계를 벗어날 수 있는 것도 아닙니다. 참가한 모델이 전부 틀린 문제라면 아무리 뛰어난 라우터나 투표 시스템을 만들어도 정답을 찾을 수 없기 때문입니다.
다수결 방식은 오히려 결과를 나쁘게 만들기도 했습니다. 성능이 낮은 모델 여러 개가 잘못된 답을 선택하면서, 성능이 좋은 모델 하나가 내놓은 정답을 뒤집어버리는 일이 생겼습니다. 실험에서는 모델들을 단순 다수결로 묶었을 때 평균 정확도가 약 10%포인트 떨어졌습니다.
물론 성능이 비슷한 모델끼리 ��합하면 도움이 되는 경우도 있었습니다. 하지만 어떤 문제를 어떤 모델에 맡겨야 할지 정확히 판단할 수 없다면, 최고 성능의 단일 모델을 넘기는 쉽지 않았습니다.
기업 입장에서는 비용도 따져봐야 합니다. SQL 작성, JSON 생성, 문서 정보 추출처럼 정답을 바로 확인할 수 있는 업무라면 저가 모델 여러 개를 동시에 호출하는 것보다 좋은 모델 하나를 쓰는 편이 더 정확하고 저렴할 수 있습니다.
멀티 에이전트나 오케스트레이션이 쓸모없다는 이야기는 아닙니다. 모델 수를 늘리는 데 앞서, 현재 모델들이 어떤 문제에서 함께 실패하는지를 먼저 확인해야 한다는 뜻에 가깝습니다.
AI 세 명에게 물어본다고 답이 세 배 좋아지는 것은 아닙니다. 세 모델이 같은 교과서와 비슷한 학습 방식으로 공부했다면, 모르는 문제도 비슷할 가능성이 큽니다.
결국 필요한 것은 ���델의 숫자가 아니라 서로 다른 약점을 가진 모델을 제대로 골라내는 능력입니다.
출처: AI타임스, 「여러 모델 섞어 써도 한계 명확…통념 깨진 ‘오케스트레이션’ 효과」
62.000 estrellas en GitHub para un editor de vídeo que ni siquiera ha salido en versión final.
Cero presupuesto de marketing. Cero publicidad. Solo el hartazgo colectivo contra CapCut.
El modelo de ByteDance es simple: te ponen una marca de agua en tu vídeo y luego te venden una suscripción para quitarla. Y con cada actualización, una función gratuita pasa detrás del paywall.
Un grupo de devs decidió reconstruir la herramienta desde cero. El resultado: OpenCut.
→ Editor completo con línea de tiempo multipista
→ Núcleo en Rust: una sola app para web, escritorio y móvil
→ Arquitectura de plugins para ampliar funciones sin límite
→ MCP Server y soporte nativo para agentes de IA
→ Licencia MIT: el código es tuyo, nadie podrá cobrarte por él jamás
La versión clásica ya funciona. La siguiente se construye en público en https://t.co/HjCQjrvTcm, commit a commit.
ByteDance pasó años monetizando la frustración de sus usuarios.
Esos usuarios acaban de financiar a su reemplazo con estrellas.
Repo abajo ⬇️
STOP PROMPTING. START LOOPING.
I found a site that collects the most used loops by the community
→ https://t.co/Sg3kmWeCSd
Claude Code's own creators say it: the future isn't prompting, it's designing loops.
Don't know what they are or how to create them?
This article explains it in detail
기업 임원진이 정말
너무 사랑하는 단어임
>회복탄력성<
면접 장점 때 문제해결 커뮤니케이션
어쩌고 하지 말고 회복 탄력성 꺼내면
눈 반짝하고 쳐다보는 사람 백퍼 나옴
회복탄력성에서는
일단 실패경험이 나오고
해결하고 개선한 내용이 나오기에
거짓도 어렵고 스토리텔링이 됨