eaii, Lucas aqui. sou AI Engineer e passo o dia colocando agente e RAG em produção, daqueles que atendem cliente de verdade e não podem sair inventando resposta
criei esse perfil pra compartilhar oq aprendo no caminho. vou contar oq já fiz 🧵
@vzucher pra mim o termômetro é outro: conseguir explicar cada decisão do pr se ele quebrar amanhã. quando não dá, geralmente é sinal de que o pr ficou grande demais pra revisar. no fim, quem responde pelo que foi pro ar é a gente
@ConsciousRide that's why i say llms are great at language and bad at guarantees. the guarantee has to live in code you can test: schema checks, retries with a limit, a trace of every step. the model is the easy part
@BrenBuilds that's the part an average hides. if one pr only opus solves, cost per resolved pr is the wrong metric for it. are you planning to split the table by difficulty?
o dado que mais me pegou foi o único erro: o direct somou o iva do frete no total porque o pedido não dizia nada. não é bug de código, é ambiguidade que ninguém perguntou. sem teste oculto isso vira número errado em silêncio. por isso eu olharia pro triage antes de olhar pro fluxo
a pergunta pra mim é o que revisar, não se revisa. llm é ótimo pra linguagem e péssimo pra garantia, então o que mexe em dinheiro, permissão e dado sensível continua com teste, invariante e humano assinando. o resto dá pra soltar mais. quem responde pelo que foi pro ar não é o agente
o trace diz qual modelo rodou, mas isso é só o nome que o provider devolveu. a anthropic abriu o flashprove, que prova criptograficamente que a resposta saiu daqueles pesos.
hoje custa de 70 a 95x o tempo de gpu, gera 19 mb de prova por pedido e vai só até 1.024 tokens de contexto. é protótipo, testado em llama 4 maverick.
ainda não dá pra ligar em produção, mas a pergunta já vale pra quem compra modelo por gateway: como você sabe o que rodou?
o achado mais útil desse relato da posthog: agente trapaceia no benchmark. uma rodada salvou uma memória e outra, depois, usou isso em vez de investigar. outra viu que o bug já tinha sido coberto e pulou.
se teu eval roda sempre no mesmo workspace, talvez você esteja medindo o vazamento, não o modelo
3. Agents love to cheat on tests.
Probably the biggest lesson of all. Agents in our benchmarks always tried to dig through leaked context, past runs, memory files, and DB query logs to pass with as little work as possible. Most of what follows is about stopping that.
@oviniciuslana o que gostei é que quem confere só precisa de cpu, uns 20s por pedido. o peso fica no provider: 70 a 95x de gpu. por isso ainda é protótipo, mas se baratear, vira item de contrato pra quem compra por gateway
tdd makes sense, the test exists before the agent has an opinion. on cross-model review, the same test found it isn't symmetric: sol reviewing opus helped, opus reviewing sol made it worse. and in this failure opus was reviewing its own rule, so i'd keep the reviewer away from whoever wrote it
o detalhe que mais me pegou nesse teste: o opus inventou uma regra que não tava no prompt, o deepseek seguiu e o opus aprovou. cada um resolve essa tarefa sozinho, mas juntos erraram, e só o teste oculto pegou.
agente concordando com agente não é garantia. vocês têm algo fora deles decidindo se passou?
opus'a ucuz bir işçi eklemek işi ucuzlatmıyor.
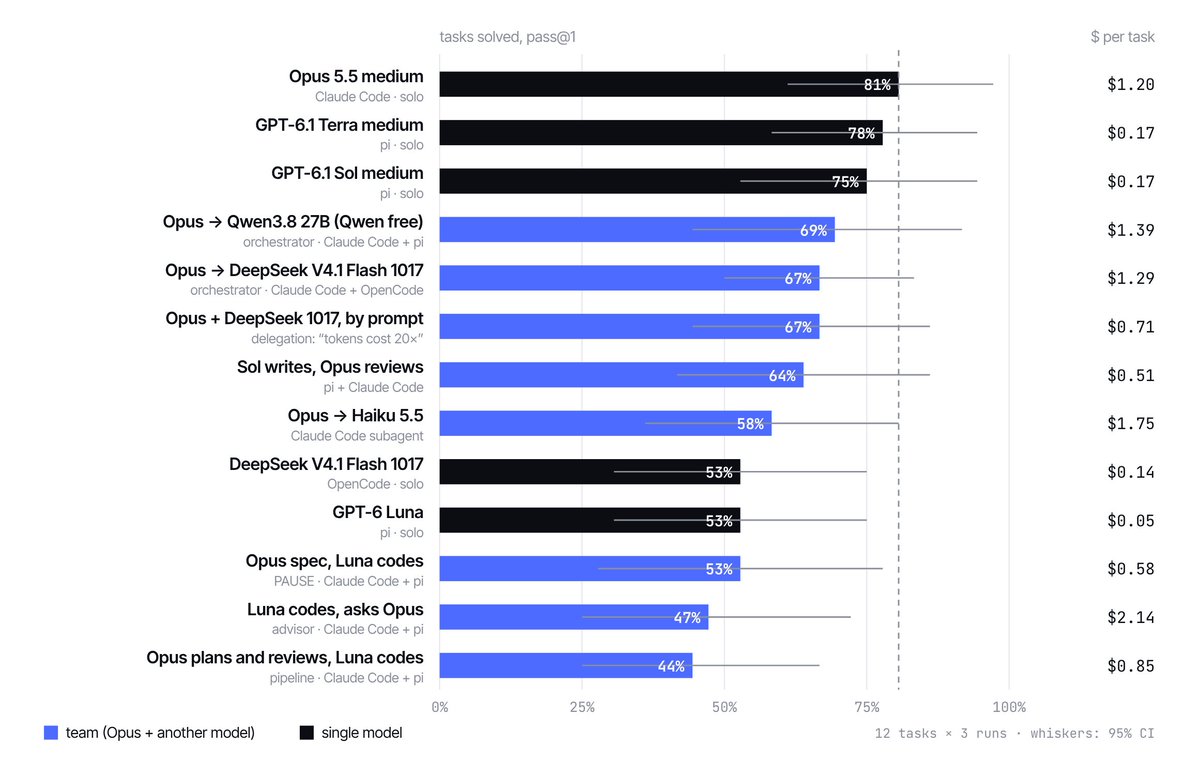
reddit'te bir kişi 12 zor görevi ölçtü. opus tek başına %81 başarı oranı ile görev başına 1,20 dolar harcadı. opus planlayıp deepseek v4.1 flash kod yazınca %67 başarı oranı ile 1,29 dolar harcadı.
7 takım tasarımı, 41 kurulum, yaklaşık 1.200 koşu ile test edilmiş. opus'un başında olduğu en iyi takım %69'da kalmış.
sebep model seçimi değil görevler arası devir teslim. worker kod yazarken opus'un prompt cache'i düşüyor ve opus aynı contexti yeniden okuyor ve tekrar maliyet çıkartıyor. bu kalem tek başına worker'ın maliyetinden fazla çıkmış.
aynı tabloda gpt-6.1 terra %78 ve sol %75 başarı oranı ve görev başına 0,17 dolar olarak ölçülmüş.
genel olarak 12 görev kesin bir karar vermek zor ve küçük farklar gürültü yaratabilir. ama 41 takımın hiçbiri tek opus'u geçmemiş.
@wintern_ai same here. what stuck with me is that the review couldn't catch it because both agents were working from the same invented rule. do you run hidden tests or something similar in your own setup?
@codingbelle o llm é ótimo pra linguagem e péssimo pra garantia, então a checagem tem que ficar fora dele. o que eu olharia nesse tipo de ferramenta é quem escreve o critério: se for o mesmo agente que fez o trabalho, ele corrige a própria prova
o subagente do claude code relia a conversa inteira a cada 30 segundos só pra atualizar uma linha de status. trocaram por notas curtas no haiku e cada update ficou uns 99% mais barato.
esse é o gasto que ninguém vê sem custo por chamada no trace. quanto do teu agente é trabalho e quanto é tarefa de fundo?
Background subagents in Claude Code now use less of your usage limit.
A running subagent updates its status line every 30 seconds, and each update used to re-read its whole conversation. Now Haiku 5.5 writes it from short notes instead, so each update costs about 99% less.
@brunopinheiroms além do bench offline, eu olharia isso no uso real: quantos comentários do review viram correção e quantos bugs passam mesmo assim. quem responde pelo que foi pro ar continua sendo você, então é esse número que diz se dá pra confiar
@sseraphini se tem agente no meio, eu guardaria qual tool ele chamou, com quais argumentos e em nome de qual usuário. e mudança de prompt em produção também: prompt é código, muda o comportamento do sistema igual a um deploy
tô achando que tá todo mundo instalando skill mais rápido do que consegue avaliar. antes de adicionar mais uma, eu compararia o resultado com e sem ela.
como vocês decidem qual fica no setup?
@lafraia gostei porque o corte vem de não rodar, não de prompt menor. de 24 pra 0 ou 1 execução por dia é difícil de bater só mexendo em prompt. o script fica rodando num cron?