Public Cloud / AI
1) AI Notebooks, AI Deploy, & AI Training – Now Available in OVHcloud US Take your AI projects to the next level with these powerful tools, now available in our US region (East-US) with L4 GPU support.
2) Structured Output for LLMs Easily format and structure outputs from your Large Language Models.
Check out our blog post for details:
https://t.co/PzLii2E2GW
3) Function Calling for LLMs – Simplifying MCP Usage! This game-changing feature makes it easier than ever to leverage Model Catalog Platform (MCP).
Learn how to use it in our latest blog post:
https://t.co/YVZ9BO1tZF
4) Quantum Emulators – Now on Dedicated Notebooks! Quantum Emulators are now available on their own notebooks, separate from AI Notebooks. Stay tuned for more exciting updates in the pipeline!
Ce qui arrive dans quelques jours :
- Qwen 3 32b
- Mistral Small 3.2
- Deepseek V3 (déjà dispo en interne pour l’equipe guides via AI)
- Whisper V3
- Whisper V3 Turbo
Comment utiliser AI ?
Chez OVHcloud, on a développé un outil interne qui permet de créer et modifier les guides d'utilisation de nos produits en 3 minutes.
On simule un visiteur sur notre site web via l'AI en promptant les actions qu'il doit faire pour accomplir une tache: par exemple changer la clef SSH (exemple attaché). On prend la video, les captures d'écran de chaque étape, les commentaires, les calls d'API, etc. puis on fait une page web avev toutes ces informations capturées. Et on recommence la même chose mais dans une autre langue (j'ai attaché un exemple en Portugais). On ne traduit plus les guides. On les génère dans la bonne langue.
Pour écrire les prompts, on chercher à utiliser les .. anciens guides existant qu'on demande à AI de transformer en prompt. C'est l'étape qu'on veut franchir dans les prochaines semaines.
L'ensemble de guides seront recréés automatiquement chaque semaine dans les 7 langues. Le but est de prendre en compte toutes les modifications du site web, le manager afin d'avoir les guides à jour.
On cherche aussi à utiliser AI pour valider l'ergonomie / UX de nos outils : si l'AI n'arrive pas à executer un guide ce qu'on doit améliorer l'UX de la section. Le souci est que l'AI passe même si rien n'est logique (trop intelligente AI), donc on a encore un peu de boulot dessus pour la rendre "moins intelligente".
L'AI en QA est utilisée depuis pas mal de temps déjà mais désormais on peut créer de tests unitaires nettement plus complexes se déroulant par exemple sur 30 minutes ou plus.
Quel est l'objective ?
Le but de la manœuvre n'est pas seulement d'avoir les guides à jour, dans 7 langues ou ajouter un nouveau guide en 3 minutes. Le but est de créer la base de connaissance à jour, la stocker et l'utiliser via AI.
Dans le 1er temps, on pourra aider nos clients plus rapidement en précisant le lien du guide par exemple comment on change la clef SSH.
Dans le 2eme temps, on pourra proposer au client d'executer l'opération à sa place (par exemple dans un chatbot). On pourra aussi conseiller et deployer une infra complexe avec K8S, DBaaS, S3, IAM, VM, LB en utilisant les connecteurs MCP (qui arrivent) ..
Mais si on revient sur le support, l'étape ultime est de poser un diagnostic sur le problème du client dont la solution consiste par exemple à changer la clef SSH. On veut aider un client qui dit juste "ca ne marche plus". Puis à nous de raisonner avec de l'AI pour faire les bons diagnostiques, trouver le souci, proposer les guides qui fixent le souci ou proposer à executer les guides et fixer le "ca ne marche plus" à la place du client.
Step by step :)
Voici le guide en FR (pas encore complet mais ca donne l'idée):
https://t.co/tQuvtjYrxu
PT:
https://t.co/nkX7qs1OuD
Public Cloud / AI / EndPoints
40 LLM open-sourced en "pay as you go" comme Llama 3.3 70B, Mixtral 8x7B ou DeepSeek-R1. Cela vous permet d'utiliser AI dans vos applications très simplement.
https://t.co/Iiv3rD7XD6
Powerful (and still free!) new models in AI Endpoints:
https://t.co/KQMUPyK9BT
• DeepDuck-70b : A language model specifically training in duck language, taking avian communication to the next level!
• Qwen2.5-VL-72B-Instruct : A multimodal large language Model for image description, OCR, object detection...
• Bge-multilingual-gemma2 : An embedding model with very high scores for French.
• Qwen2.5-Coder-32B-Instruct : Top model for code completion, config your IDE: https://t.co/3s5u2SaLBi
Exciting updates to Omisimo our experimental chat:
https://t.co/04wSum3Nvt
• Fresh UI & New Features: Enjoy a modern interface with conversation history (stored locally in your browser—your data stays private!), and easily send images and files.
• Omni-Modal Capabilities: Our model now interacts with documents, images, web pages, and performs web searches, thanks to transparent agentic planning and models usage from our AI Endpoints. We show you exactly how it works!
• Still Experimental, Free: Check it out and let us know what you think via the Feedback option!
Depuis quelques jours, on entend beaucoup parler de projets de construction "Datacenters 1GW" pour l'IA en France
Pour bien comprendre le besoin, il faut bien avoir en tête ces 3 chiffres suivant:
il faut 50Me, pour investir dans 1000 GPU qui vont fonctionner dans un Datacenter consommant 1MW de puissance électrique
Ces 3 chiffres fonctionnent ensemble sur plusieurs niveaux de scale:
50Me - 1k GPU - 1MW
500Me - 10k GPU - 10MW
5Mde - 100k GPU - 100MW
50Mde - 1M GPU - 1GW
80% de ces montants servent à acheter les GPUs, 20% pour construire un Datacenter
Pour quel besoin ? Les GPUs sont utilisés pour 2 types d'usage:
- l'entrainement et donc la création d'un modèles LLM avec les données (training)
- l'utilisation d'un modele LLM existant par les clients (inference)
Les générations de GPUs actuellement disponibles sur le marché permettent de faire l'entraînement sur environ 100K GPU en fonctionnant ensemble. Le facteur limitant est la distance entre les 2 GPUs les plus éloignés physiquement : à partir d'un certain nombre de GPU connectés ensemble, la distance fait ralentir le fonctionnement de l'ensemble de GPUs
C'est pourquoi pour le besoin de l'entrainement, une nouvelle génération de GPUs arrive sur le marché: les superchip. Au lieu d'avoir des dizaines de GPU indépendants que vous connectez en suite ensemble, chaque superchip regroupe une dizaines de GPUs sur une seule carte. Bravo ! Vous avez réduit la distance entre les GPUs et vous pouvez connecter désormais 10 fois plus de GPUs ensemble sans ralentir le tout. En revanche, vous avez de nouveaux défis à résoudre: comment distribuer l'énergie et refroidir une infrastructure 10 fois plus dense Comment vous procurer une source d'énergie de 1GW et comment assurer sa redondance
Pour héberger la puissance de calcul dans un Datacenter, on utilise les baies aka les racks, qui est une sorte d'armoire de 0,6m de large, 1m de profondeur et 2.5m de hauteur. Chaque baie est alimentée avec environ 20KW de puissance électrique. Pour la refroidir, on utilise de l'air frais qu'on pousse à travers la baie
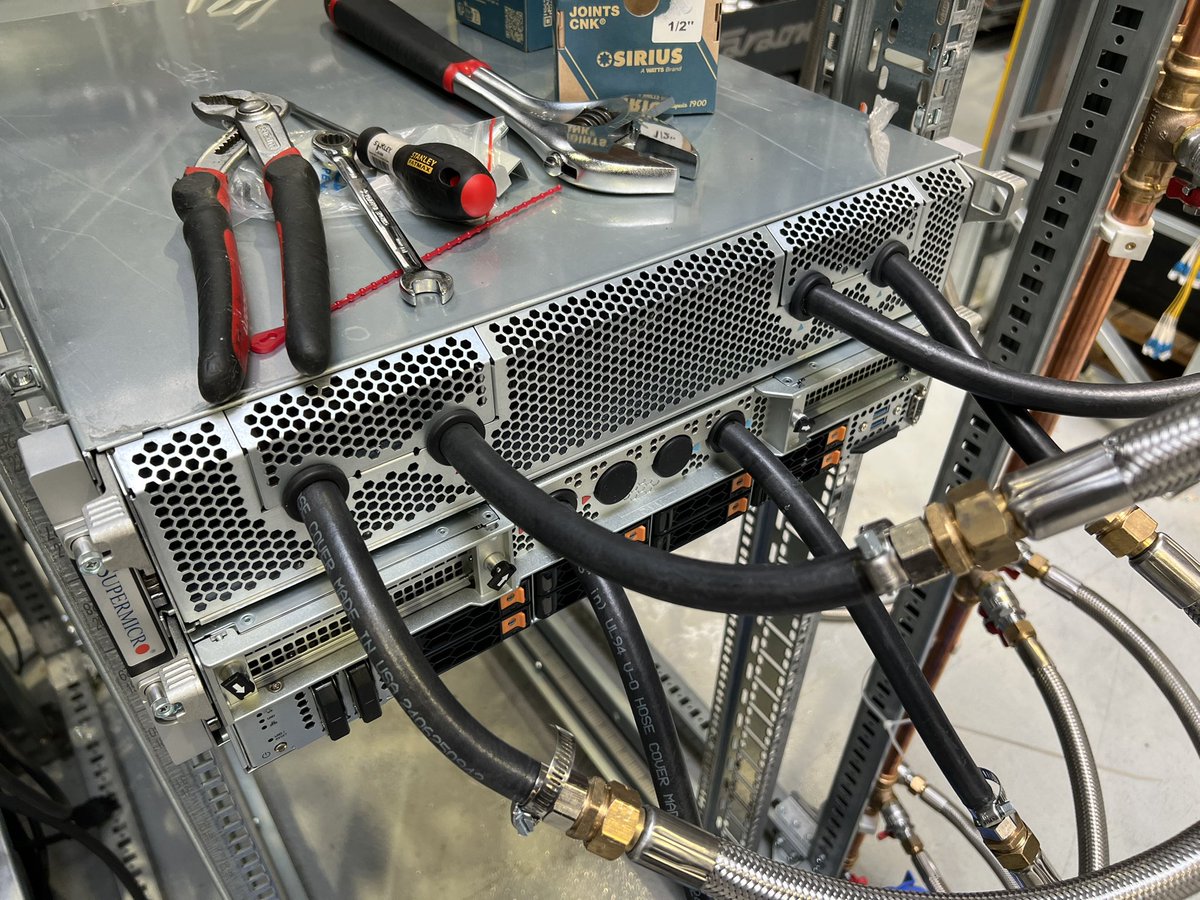
Si on veut utiliser plus que 20KW dans une baie, l'air ne suffit pas pour la refroidir. Il faut passer en watercooling. C'est là qu'on commence à parler de la nouvelle génération de Datacenter et dans certains cas on parle de 1GW. En effet, pour héberger les superchip, on parle désormais de baies à 120KW voir meme on spécule sur 240KW par baie et un système de watercooling pour capturer et extraire toute cette chaleur. C'est totalement nouveau par la puissance par baie mais aussi par ce système de refroidissement watercooling at scales. Voilà pourquoi ce genre de Datacenter n'existent pas et donc faut les construire
Pour l'usage d'inférence, il n'y a pas besoin de Datacenters aussi sophistiqués. Pas besoin de superchip non plus. Un modèle LLM a besoin d'un système de GPU qui consomme entre 100W et 10KW, rarement 20KW, equivalent de 1 à 16 GPU. Chaque système étant indépendant, vous pouvez mettre autant de systèmes en parallèle que vous voulez, ce qui vous permet d'absorber un grand traffic web ou mobile. Il est même préférable d'avoir plusieurs Datacenters d'Inference, en parallèle et pourquoi pas 1 par pays. Cela permet d'assurer la haute disponibilité, et les faibles latences en utilisant Datacenter le plus proche du visiteur
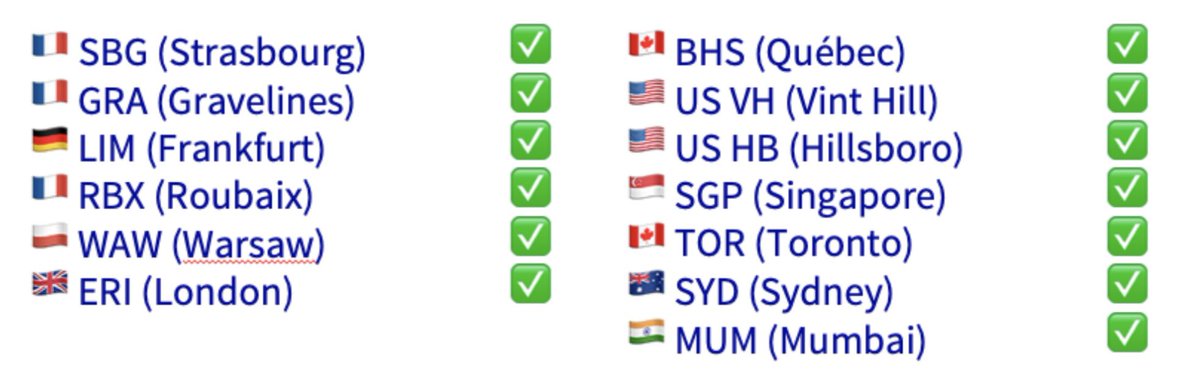
Et OVHcloud dans tout ca ? Nous possédons plus de 40 Datacenters, dans plusieurs pays en Europe, au Canada, en Amérique du Nord, et Asie. Nous sommes experts de watercooling depuis plus de 20 ans. Ceci nous permet de refroidir >500K serveurs physique dans tous nos Datacenters. Nos technos interne, opensourcées, coutent 20x à 40x moins que les solutions du marché. Nous possédons les Datacenters de 40MW à 100MW, capable d'héberger de l'entrainement, avec de baies à 40KW mais aussi nous avons les Datacentres partout dans le monde pour assurer l'inference. Nos investissements suivent les besoins de nos clients et nous sommes capable d'accélérer si necessaire