Nie rozumiem takich wpisów. Bo co ma pilnowanie i analiza kosztów, do decydowania czy chcę kupić to kraftowe piwo czy nie? Ja kupuję i skrupulatnie skanuję kwitki i zapisuję, żeby wiedzieć ile realnie wydaję i ile muszę zarobić, żeby komfortowo żyć. Stworzyłem z AI swoją apkę, która mi to maksymalnie ułatwia. I dlaczego miałbym nie wpisać 12 zł w przychody? A co 12 zł to się już nie liczy, bo jest poniżej progu czy o co chodzi? A jak mam 100 po 12 zł to już mogę zapisywać?
Mam bana u ojca z klasy średniej bo ośmieliłem się powiedzieć kilka niewygodnych słów na temat jego arkusza excela za 100 zł który każdy może zrobić samemu z AI ale…
Ostatnio ktoś skomentował post jak gość wpisał 12 PLN w przychody zarabiając 13k PLN.
Te finansowe profile na X są tak odklejone od Rzeczywistości czasami ze naprawdę brak słów .
Ciekawe jak wygląda z nim wyjście do restauracji albo na kebaba i czy też liczy każdą złotówkę? Albo wyjście na piwo z kolegami, co w sytuacji jak kolega będzie chciał kraftowe piwo za 20 zł?😀
Ja rozumiem szacunek do pieniędzy ale nie popadajmy w paranoje.
#finanse
@negacz Brakuje pewnie centralizacji danych, żeby LLM miał pełnię kontekstu od razu w dyskusjach w tych "silosach". Choć przyznawanie racji dość łatwo jednak wymusić na modelach. Trudniej ich skłonić do chłodnego, bezstronnego podejścia bez próby udobruchania użytkownika.
Dla mnie usta i lipsync nadal wygląda nienaturalnie. Nie wiem co prawda czy to dobrze czy źle. Ale pewnie zaraz pojawią się posty, że jesteśmy cooked albo X/Y is dead... eh czy nie męczy was już ten cały hype? Czasem robię sobie detoks X'owy bo mam już tego wszystkiego dość. Śledzenie wybranych kont też nie do końca pomaga, bo teraz większość kont i tak jest na pasku płac...
Introducing Griffin, the first model to pass the video Turing test.
48% of people who talked to it live thought it was a real human. Previous systems have had a pass rate <3%. It is #1 on NVIDIA's benchmark for full-duplex AI video.
It’s the first Human Interaction Model (HIM).
For years, maybe a decade, I've wanted to build a writing tool that just did a few things I couldn't find anywhere else.
A system that mimicked how I think when I write. A system that provided clear affordances, features, and places to do the things I wanted to do. A way to play with my writing as I'm writing it. A way to settle into just the right way to say something.
It never made sense to make it a 37signals product because it's not commercially viable, nor would it be worth pulling people off their other work to hack on this. Plus, it would have taken months the old way.
So this weekend I just made it myself, with Claude's help.
It's called Write_On and the short video walks you through it.
Essentially it's "alternative control" at the word, sentence, and paragraph level, plus a way to dim stuff back, and stash stuff near by. Not version control, but alternative control. You'll see what I mean when you watch the video below.
So here it is. Write_On.
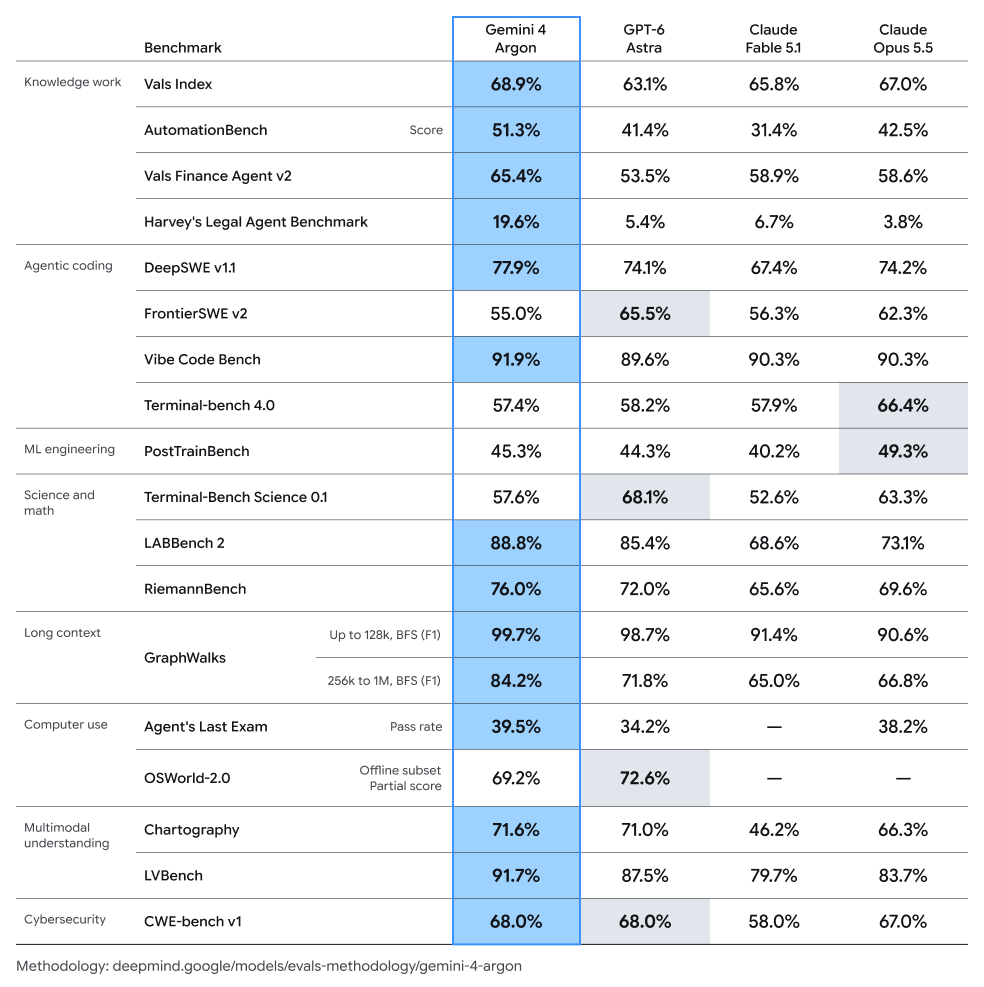
Ciekawe jak Gemini 4 będzie działać. Do tej pory największym problemem był harness i nieznajomość przez model własnych umiejętności i używania tooli. Do tego stopnia, że szybko się odbijałem od poprzednich modeli. Nie chciało mi się udowadniać modelowi, że coś może zrobić. Jak to ogarną to może być grubo.
Introducing Gemini 4 Argon – our new frontier model.
It’s built for complex workflows across coding, enterprise knowledge work, and cybersecurity defense – rolling out today to a set of trusted testers through our Fairwind Program.
Ciekawe. W swojej apce używam Kimi 2.7 jako daily driver dla użytkowników. Muszę przetestować DeepSeek Flash, bo Kimi jest w porządku, ale wolne. Trójka jest jeszcze wolniejsza i droższa, więc w ogóle nie wchodzi w grę.
After 3 years building LLM agents, I think the model people actually choose to run says a lot, it’s a bit like voting with your credit card. That’s why the benchmark I pay the most attention to is usage on OpenRouter.
For smaller/cheaper models, DeepSeek Flash is doing ~22.7T tokens a week, GLM Flash ~10.6T and GPT-6 Luna ~5.1T, which gives you a pretty good idea of where people are finding value for money.
For larger, frontier models, Opus 5.5 is at ~1.9T and GPT-6 Sol ~1.2T, while Gemini Pro is at ~0.2T, roughly 10x less volume than Opus.
Obviously cheaper models will consume more tokens, so you have to compare within each category, but I find this much more useful than another benchmark showing a model winning by 2 points. You can game a benchmark but not where companies are spending their $$$.
And that still only gives you the global trend. For your product, the eval that matters is your own, on actual customer tasks, because a model can be amazing overall and still suck at the specific thing you need it to do.
That’s why I think you want a multi-model platform, with customer evals driving which model handles which task, so you can improve quality and optimize your token stack as the models change. You shouldn’t be married to one model.
Dlatego właśnie postanowiłem zostać na Anthropic mimo tego, że jeszcze niedawno, przez te całe cyrki z Fable i Opusem 5, byłem bliski przejścia do OpenAI. Ale doszedłem do wniosku, że nawet drobne różnice w działaniu, promptowaniu, harnessie, itd. wymagają uwagi i pracy i ewentualne zyski nie są warte zachodu.
Jak na razie okazuje się to być trafną decyzją.
Pełna zgoda - wdrażanie jedno, a samo ogarnianie możliwości kolejnych modeli i narzędzi to drugie.
I jeszcze wykonywanie codziennych obowiązków w pracy, które sprowadzają się czasami do starego, dobrego rozmawiania z chatem, a nie odpalania od razu multum agentów do kodowania.
Nie da się tego wszystkiego opanować tak na serio, dogłębnie. Trzeba wybrać sobie jakiś kierunek i działać w swoim tempie.
Coś czuję, że powoli dochodzimy do momentu, w którym korzystanie z najlepszych modeli to będzie sport dla bogatych. OpenAI teraz właściwie przyznaje, że dają połowę tokenów za tę samą cenę.
Hi,
Tomorrow we are re-opening the Pro $200 subscriptions to new subscribers, but together with it we are also changing how we calculate the usage for it. In effect, if you do the math, it will net out at half the dollar in API spend compared to the old Pro $200 plan.
Now that it's said, let me explain why this is happening and why you will still get more work done than if you were on the Pro $200 subscription one month ago.
(a) We didn't want to compromise in other ways and are committing to not reintroducing the 5h limit, so that you can fully use the weekly usage when you want.
(b) On the subscription, we guarantee that over time you always get more work done and with an increasing level of quality. This means that you will continue to get more value per dollar spent as a result of models getting more efficient and us passing down the improvements in the form of API price reductions.
(c) We don't want to put an incentive on ourselves to artificially inflate the API list prices to make it look like you are getting a lot (and workaround it through discounts, etc). Instead we want to continue to both rapidly reduce prices and increase capabilities of models on the API. This week we introduced GPT-6 Sol and GPT-6 Luna at 50% of their previous price. Over time, we see prices go low enough that it makes sense for most to buy usage as needed without there being a significant gap between what you get in a subscription and what you get in the API for a dollar spent.
(d) Tomorrow, we are adding more things to the subscription that won't draw on the usage, I won't reveal what that is yet.
I wanted to be transparent before all the big announcements tomorrow. Lots of new exciting things are coming to the subscriptions that will make it super compelling, but I wanted to make sure to share this change ahead of time so you can all understand it before we shower you with good news.
Codexingly,
Tibo
Nadal uważam, że jeśli ceny frontier modeli pójdą w stronę $1000 miesięcznie, AI stanie się luksusem dla nielicznych. Liczby, które to potwierdzają:
@marclou publikuje dane z TrustMRR. Na ponad 1000 startupów 44% zarobiło łącznie co najmniej $1000. Mediana MRR jest jednak dużo niższa: ok. $750 dla B2B i ok. $264 dla B2C. Większości takich firm nie byłoby stać na taki wydatek co miesiąc.
Nie wiem też, czy programista zarabiający 20k PLN (ok. $5200) chciałby oddawać $1000 na subskrypcję.
We are opening up our platform and you can now build full native apps with plugin extensions, and ship them right in ChatGPT. We have over 1.2B weekly users and will surface relevant plugins right in the conversations.
Takie pierdolenie, że to jest near Astra intelligence, czyli nie ma podjazdu do Opusa. Ale nie ma to znaczenia. Rzeczywiście modele nowe są bardziej wydajne. Nie zmienia to faktu że limity się zmniejszają i nie wiemy jak będzie wyglądać ich stosunek wartości do ceny w przyszłości.
Czasem nie samą pracą człowiek żyje. Trzeba też dziecko trochę podszkolić czasem z matmy.
Jak to powstało:
1. Podałem działania z ostatnic lekcji np. 256 × 21, 119 × 98, 2 356 800 : 8, 1 764 : 49 i dodawanie z odejmowaniem w tysiącach.
2. Claude napisał scenariusz. Liczby zapisał słowami, żeby lektor ich nie przekręcił, a wszystkie wyniki policzył kodem.
3. Głos z ElevenLabs v4. API oddaje czas każdego słowa.
4. Animacje w Remotion. Cyfra, przeniesienie i pożyczka pojawiają się w chwili, gdy lektor o nich mówi.
5. Whisper sprawdził wymowę. Jedną scenę wygenerowałem drugi raz, bo w tekście było "zniś" zamiast "znieś".
Całość w około 30 min mielenia przez Claude'a. A my w tym czasie uczyliśmy się historii :)
Nadal uważam, że jeśli ceny frontier modeli pójdą w stronę $1000 miesięcznie, AI stanie się luksusem dla nielicznych. Liczby, które to potwierdzają:
@marclou publikuje dane z TrustMRR. Na ponad 1000 startupów 44% zarobiło łącznie co najmniej $1000. Mediana MRR jest jednak dużo niższa: ok. $750 dla B2B i ok. $264 dla B2C. Większości takich firm nie byłoby stać na taki wydatek co miesiąc.
Nie wiem też, czy programista zarabiający 20k PLN (ok. $5200) chciałby oddawać $1000 na subskrypcję.
Czemu nie zapłaci? :) Zakładam, że zarabiają na tym przynajmniej X razy więcej. Przez lata branża mówiła ile to nie jest warta godzina ich pracy i przez to nie robią sami zakupów czy zamawiają sprzątanie do domu, a nagle coś co oszczędza 99% czasu pracy za $1k jest za drogie? ;)
No i weź pod uwagę, że jest wiele modeli. Modele topowe, drogie są potrzebne może w 0,0001% przypadków. Normalny człowiek ich nie potrzebuje, programista ich potrzebuje może przez 5% swojego dnia. Modele opensource sa na poziomie modeli topowych z zeszłego roku, więc za rok opensource będą na poziomie Opusa 5.5 czy Astry.
Ja wychodze po prostu z założenia, że jak ktoś buduje coś i na tym zarabia to stówka w jedną czy drugą stronę nie robi różnicy. A jak buduje hobbystycznie dla zabawy to nie potrzebuje topowego najdroższego modelu.
Sam byłbym skłonny zapłacić te powiedzmy $1000. Ale przyznasz pewnie sam, że to mimo wszystko ogranicza pulę użytkowników. 1000 już większość indie hackerów pewnie nie zapłaci. Albo nie za długo będzie w stanie. Więc uważam, że jest to zabawa dla bogatych. W sensie nie dla wszystkich. No i pewnie będą niższe subskrypcje, ale zobacz. Fable był dostępny (czy nadal jest) tylko na Max.
No na długo ci taki abonament nie wystarczy. Sam jestem team Anthropic, ale oni też kombinowali ostatnio przecież z Fable tylko na 2 tygodnie, potem drama z odebraniem dostępu, potem właściwie wyczuwalny nerf i przedłużanie dostępu, aż jest na stałe.
Ale limity schodzą raczej szybko. Fable 5 i 5.1 w sobotę mam reset a do wtorku zwykle mam wykorzystany. A Opus 5 nie był powiedzmy najlepszy. Więc czuło się te ograniczenia dość mocno. Teraz rzeczywiście jest dużo lepiej.
Możliwe, ale zobacz, że czas też trochę już przestaje mieć na znaczeniu. Bo jak za 2 lata powie w Claude na telefonie "słuchaj nie mogę już ogarnąć które części zamówiliśmy do któgo samochodu, pomóż"... i model mu pomoże.
Jeszcze jest szansa w tym, że taki właściciel sam nie wie czego potrzebuje. Bo tu już często jest potrzebna wiedza biznesowa i zbieranie wiedzy z tego co rzeczywiście u innych działa. Czyli dane.
Ostatnio popularne były takie posty, gdzie ludzie się przedstawiali z chęcią poznania innych ludzi. W mojej bańce AI-owej bardzo dużo było founderów, którzy generalnie mają problem z tym, żeby znaleźć klientów do swoich aplikacji. Główny problem, jaki widziałem: tworzenie nowych feature'ów, nowych narzędzi, nowych aplikacji i brak użytkowników.
Zastanawiałem się, czemu właściwie większość z nich próbuje cały czas sprzedawać swoje usługi do innych indie hackerów, zamiast skupić się na branżach, które z AI nie mają jeszcze za dużo do czynienia. W Ameryce mówi się na to boring business i ostatnio jest dosyć trendy. Wszyscy o tym mówią, ale nikt tego praktycznie nie stosuje.
A ja właśnie sprzedaję do boring business i widzę, że Ci właściciele takich typowych biznesów naprawdę potrzebują wsparcia. Tylko że nie potrzebują agentów AI, nie potrzebują skilli do Claude'a, nie potrzebują, nie wiem, company brain. Znaczy inaczej: potrzebują, ale nie chcą o tym wiedzieć w sposób techniczny. Nie chcą się uczyć, jak mają kodować, jak budować sami jakieś wewnętrzne narzędzia. Nie chcą budować automatyzacji.
Bo już przez to przechodziłem. Miałem kursy, gdzie krok po kroku pokazywałem, jak tworzyć automatyzację na przykład w Make'u, i na chyba ze 70 sprzedanych kursów wdrożyły to dwie osoby. Są mega zadowolone, nie wyobrażają sobie życia bez tego, ale są to dwie osoby.
Więc to, czego te firmy potrzebują, to więcej zapytań, więcej zleceń, mniej straty pieniędzy, bo tracą pieniądze na tym, że nie znają się na biznesie. Potrzebują zabrania im pracy, a nie dołożenia kolejnej pracy, kolejnej nauki, kolejnych narzędzi.
Oczywiście wszystko to, o czym mówiłem, wykorzystujemy jako wewnętrzne działania aplikacji albo jakieś automatyzacje. Ale to, co dana aplikacja czy automatyzacja produkuje, musi być jasno opisane w języku bólu i korzyści takiego człowieka, który właściwie nie prowadzi biznesu, tylko stworzył sobie pracę, a chciałby może mieć biznes.
I na tym większa część ludzi powinna się skupiać, nie na founderach. Bo founder takie narzędzie, które ty sobie stworzyłeś i chcesz sprzedawać, bardzo często może stworzyć sam w ciągu kilku chwil, bo się na tym po prostu zna... Dobra, może nie kilka chwil, może tydzień, może dwa tygodnie. Kurde, Photoshopy są teraz tworzone na nowo na Linuxa, na Omarchy. A ty uważasz, że ktoś nie może twojego narzędzia vibe kodować? No co ty?
Ale już taki, budowlaniec, firma sprzątająca, mechanik samochodowy, on sobie czegoś takiego nie stworzy z jednego głupiego powodu: nie ma na to czasu.
Dlatego tworząc nowe narzędzia i rozwiązania mocno bym się zastanowił dla kogo chcesz je tworzyć.