@guilippert_v4 Eu uso Grok Bot e foi a melhor coisa que eu fiz depois de começar a usar o t3code. Configura o mcp do t3 no grok bot e cria os bots q vc quiser pra fazer acompanhamento de pontos de vista diferentes.
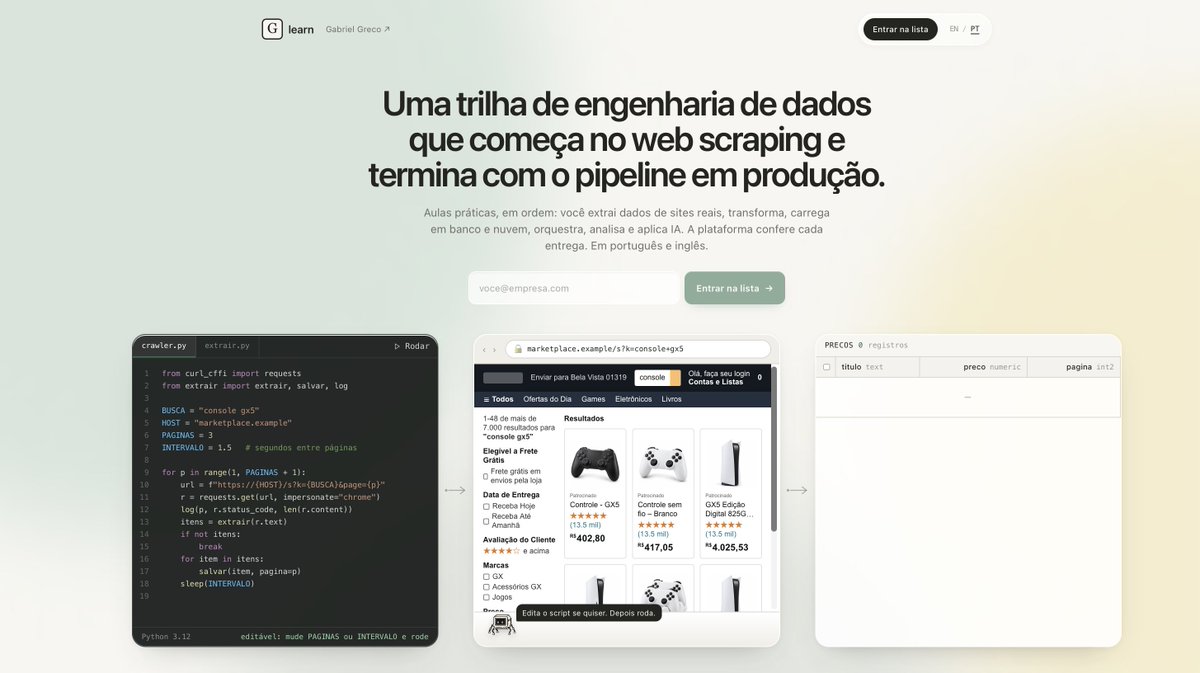
a todos que querem aprender eng de dados:
o curso atualmente tem cerca de ~350h, sim muito conteúdo
R$19.90 no primeiro mês
R$39.90 no segundo mês
isso que ainda não gravei os vídeos e ainda to adicionando conteúdo, então acredito vamos chegar a umas 450h
pensei em criar um acesso vitalício a R$219.90 (quem já pagou o mensal obviamente seria descontado)
o que vocês acham? alunos, e todos que estão na lista de espera?
o valor mensal continua fixo, mas abriria essa possibilidade de comprar e não ficar preso na plataforma :)
Your laptop isn't built for running agents.
Introducing @instabox_sh: cloud computers for AI agents.
We provide multi-OS sandboxes (Linux, Android, Mac, Windows) with GPU and CPU.
We launched in beta <1 month ago, and today, users have created 1M+ boxes.
Give agents their own cloud computers so they don't fight over the same memory, CPU, and ports on your laptop.
Close your laptop, and they keep working.
Get started today → https://t.co/4l37UGfR8s
No meu caso: Uso o @t3dotcodes pq preciso orquestrar agentes sol 6.1 ultrafast e opus 5.5 na mesma thread, e revisar usando muse wonder full / sonnet.
Eu vi melhorias reais usando esse fluxo, assim como muitos outros engenheiros sérios.
Isso é algo que não é possível de fazer sem gambiarra no harness nativo, e o t3code abstrai tudo, e ainda coloca um orquestrador mais leve e eficiente por cima.
E além disso, ainda gasta menos tokens no final, e não mais (postei sobre isso, com referência).
Não acho que essa resposta seja adequada, vejam bem:
Dentro de um provedor só, o harness orquestrar sozinho funciona bem. O Opus abre uns Sonnets e resolve.
O que uma ADE tipo o @t3dotcodes permite é outra coisa: um modelo de um provedor delegar pra modelos de outros. Isso nenhum harness faz sozinho, porque cada um só enxerga a própria família.
Na prática, isso me dá:
- O planejamento fica com o modelo que planeja melhor, e a implementação com o que codifica melhor, mesmo sendo de empresas diferentes.
- O trabalho braçal vai pro modelo mais barato ou mais rápido que eu tiver (No meu caso uso Sol no Ultrafast)
- Se um provedor estoura o limite no meio do dia, o trabalho continua no outro, ou numa segunda subscription
- A revisão é feita por um modelo de outra família, que erra diferente e por isso pega o que o primeiro deixou passar (isso também já é ponto pacífico)
E sobre gastar mais token, é o contrário: o @aarondelasy mostrou que no T3 o Claude Code roda headless. Nesse modo, algumas tools já saem por padrão, então o prompt fixo fica uns 26% menor, e isso se repete em toda chamada.
https://t.co/uvq83Ra683
TODO harness spawna sub-agentes sozinho. Claude code com Opus abre vários Sonnets quando precisa. E orquestra sozinho. Todos fazem a mesma coisa, Codex, Opencode.
NÃO PRECISA de nenhum orquestrador externo achando que vai "economizar tokens" ou "ser mais eficiente". Não vai.
Faço os testes lado a lado e vai ver que na verdade é PIOR.
Não é pra copiar quem tem usage infinito. O ganho de uma ADE tipo o @t3dotcodes não é forçar mais subagente, é um modelo de um provedor orquestrar os de outros.
O barato faz o trabalho braçal, o melhor planeja, e se um estoura o limite o outro segue. Cada filho roda isolado, e um modelo diferente revisando pega buraco que o primeiro não vê.
O @aarondelasy mostrou a economia de token: no T3 o Claude Code roda headless e algumas tools já saem por padrão, o prompt fixo fica uns 26% menor. https://t.co/svsS5wwoDL
E tem outro post dele com outras q vc pode desabilitar pra reduzir ainda mais.
Existem benefícios reais, se não existisse não tinha ninguém sério usando.
Rodo o 3.8 27b no hyperqwen a 180 token/s + ou - e o 3.8 Flash Next no strata a 90 tokens/s + ou - (um de cada vez kkk)
Meu home server é um Xeon e5 2690v4 (com mobo chinesa, aqueles kits), 128gb de ram dd4 ecc sk hynix, 2x rtx 3090, 2x ssd samsung 990 pro de 4tb (com a velocidade capada pelo pci-e gen 3 da mobo 🫠 ) e um monte de HD somando 60TB de armazenamento.