Hola, soy Rubén, de Putumayo (COL) para el mundo jaja. 🇨🇴
Estudio Ing. de Sistemas. Aprendo sobre LLMs y agentes por mi cuenta.
Me gusta programar, por eso dejé de solo vibecodear, disfruto escribir mi código y resolver los problemas que surgen (aunque a veces me frustre jaja).
Vamos a hablar un poco de este nuevo "tipo" de modelo. Es un modelo denso de 12B (por la metadata de los LoRAs que publicaron en HF, parece ser Gemma 4).
No sería en realidad un nuevo tipo o arquitectura, como dije es un modelo denso de 12B al que se le añaden "especializaciones" y las publicadas son LoRAs (correcciones de valores de algunos pesos del modelo para justamente especializarlo en una determinada tarea).
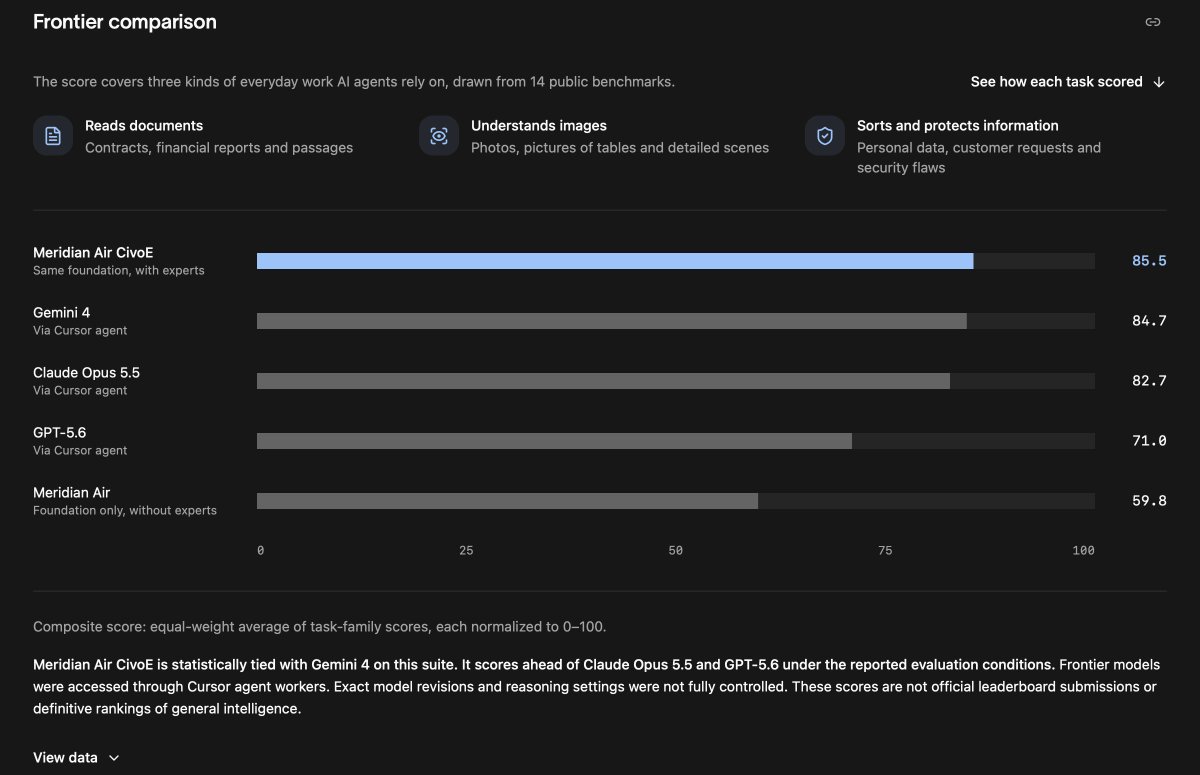
Lo interesante es que, según sus pruebas, con sus especializaciones el modelo pasa a niveles de frontera, por encima de Claude Opus 5.5 y GPT-5.6.
Ojo, son pruebas internas sobre tareas que ellos eligieron (leer documentos y contratos, entender imágenes, detectar datos personales), no un benchmark general. Aun así, un 12B a nivel de modelos frontera en esas tareas solo por especializarlo es bastante.
Algo muy interesante, seguramente valdrá la pena probar y experimentar con esto.
Esto era algo que pensaba hace tiempo, pero no había tenido el tiempo para investigar, muy bueno ahora tenerlo, porque creo que justamente la fortaleza de los modelos locales pequeños es esa, no ser generalistas sino especializarlos en su tarea específica.
Habrá que probarlo cuando sea posible, por ahora en HF solo publicaron 5 LoRAs de roles (researcher, analyst, writer, builder y critic), con licencia propietaria y sin el modelo base. Las especializaciones de las pruebas no están publicadas. Ojalá publiquen todo.
Vamos a hablar un poco de este nuevo "tipo" de modelo. Es un modelo denso de 12B (por la metadata de los LoRAs que publicaron en HF, parece ser Gemma 4).
No sería en realidad un nuevo tipo o arquitectura, como dije es un modelo denso de 12B al que se le añaden "especializaciones" y las publicadas son LoRAs (correcciones de valores de algunos pesos del modelo para justamente especializarlo en una determinada tarea).
Lo interesante es que, según sus pruebas, con sus especializaciones el modelo pasa a niveles de frontera, por encima de Claude Opus 5.5 y GPT-5.6.
Ojo, son pruebas internas sobre tareas que ellos eligieron (leer documentos y contratos, entender imágenes, detectar datos personales), no un benchmark general. Aun así, un 12B a nivel de modelos frontera en esas tareas solo por especializarlo es bastante.
Algo muy interesante, seguramente valdrá la pena probar y experimentar con esto.
Esto era algo que pensaba hace tiempo, pero no había tenido el tiempo para investigar, muy bueno ahora tenerlo, porque creo que justamente la fortaleza de los modelos locales pequeños es esa, no ser generalistas sino especializarlos en su tarea específica.
Habrá que probarlo cuando sea posible, por ahora en HF solo publicaron 5 LoRAs de roles (researcher, analyst, writer, builder y critic), con licencia propietaria y sin el modelo base. Las especializaciones de las pruebas no están publicadas. Ojalá publiquen todo.
Today, we're announcing webAI Meridian-1 CivOE.
A 12B AI model that statistically matched Gemini 4 Argon and outperformed Claude Opus 5.5 in evaluation.
But the most important breakthrough isn't the benchmark.
It's how we achieved it.
Instead of endlessly scaling model size, we've built intelligence that adapts to the work through specialized experts.
Our results:
Meridian-1 CivOE: 85.5
Gemini 4: 84.7
Claude Opus 5.5: 82.7
GPT-5.6: 71.0
The same 12B foundation went from 59.8 to 85.5 through specialization. A 25.7-point improvement without making the foundation model larger.
We believe this represents a fundamental shift in how intelligence will evolve.
Just as software became personal, customizable, and accessible on everyday computers, intelligence is heading in the same direction.
Intelligence that adapts to your knowledge, your work, and your devices.
We're beginning the rollout of Meridian-1 CivOE with strategic partners over the next few weeks, before expanding access to all webAI users.
The future of intelligence isn't just bigger.
It's yours.
Read More: https://t.co/jPDLnkXKgA
Emocionado con el lanzamiento de ColIA y hoy... Nuestro primer modelo, ¡Sibundoy-Translate-1.7B!
Modelo de traducción de inglés a español, es un postentrenamiento de LFM3-1.7B-Base (@liquidai). Su punto fuerte es conservar el formato de texto. Tiene muchos puntos de mejora pero es la primera versión, esperamos lo prueben y recibir comentarios para ir mejorando, abiertos a mucho feedback.
Lleva el nombre de un lugar muy especial para mi y busca mostrar que en estas regiones, en Colombia y todo LATAM hay mucho talento, cultura e increíble gente por descubrir. Vamos a impulsar la IA en todas nuestras regiones, a hacer de ellas un lugar mejor para todos nosotros!
Blog 📰: https://t.co/A0zwvFZKNz
HF 🤗: https://t.co/MDPCwtNlP5
Presentando nuestro primer modelo:
Sibundoy-Translate-1.7B
Modelo de traducción Ingles a Español, su punto fuerte esta en conservar el formato del texto. Postentrenamiento de LFM3-1.7B-Base
Blog 📰: https://t.co/KXi7EJCdpN
HF 🤗: https://t.co/JH4jSFZOOL
Emocionado con el lanzamiento de ColIA y hoy... Nuestro primer modelo, ¡Sibundoy-Translate-1.7B!
Modelo de traducción de inglés a español, es un postentrenamiento de LFM3-1.7B-Base (@liquidai). Su punto fuerte es conservar el formato de texto. Tiene muchos puntos de mejora pero es la primera versión, esperamos lo prueben y recibir comentarios para ir mejorando, abiertos a mucho feedback.
Lleva el nombre de un lugar muy especial para mi y busca mostrar que en estas regiones, en Colombia y todo LATAM hay mucho talento, cultura e increíble gente por descubrir. Vamos a impulsar la IA en todas nuestras regiones, a hacer de ellas un lugar mejor para todos nosotros!
Blog 📰: https://t.co/A0zwvFZKNz
HF 🤗: https://t.co/MDPCwtNlP5
Presentando nuestro primer modelo:
Sibundoy-Translate-1.7B
Modelo de traducción Ingles a Español, su punto fuerte esta en conservar el formato del texto. Postentrenamiento de LFM3-1.7B-Base
Blog 📰: https://t.co/KXi7EJCdpN
HF 🤗: https://t.co/JH4jSFZOOL
Totalmente de acuerdo con lo planteado aquí.
Casi nadie tiene una RTX Pro 6000 con 96 GB de VRAM en casa. La mayoría tenemos una GPU modesta o directamente una PC sin GPU y aun así somos el mercado más grande.
Con los avances actuales, los modelos locales seguirán mejorando y aunque no sabemos si igualarán la frontera actual, seguro se acercarán mucho, y para muchas tareas del día a día nadie necesita un Opus 5.5
Ojalá que con Qwen 4 vuelva el MoE de 35B, seguro será un salto increíble. Impulsar la IA local implica hacerla accesible para la mayoría. Trabajemos en comunidad para lograrlo!
The biggest pool of future local AI engineers isn't on 24GB cards and 128GB Sparks. It's on the PCs and Macs people already own.
From Steam's October survey:
• 78.5% of PCs have 8GB+ VRAM
• 43.8% have 32GB+ RAM
• Only ~5% have 64GB+ RAM, and under 10% have more than 16GB VRAM
Beyond Steam:
• 44M desktop GPUs shipped in 2025 alone
• My rough estimate: 100-150M PCs in use with 8GB+ VRAM
• Plus 140M+ Apple Silicon Macs, and M5 Pro/Max are seriously quick with unified memory
That hardware runs a 20-35B MoE with ~3B active really well. On my 10GB 3080 with 32GB RAM, that class is where the best results have come from.
This is where people start tinkering, building agents and learning the craft. It's a much bigger group than the high-end crowd.
@liquidai, @ornith_, @PrismML, @OpenBMB and others are already building for it. @NVIDIAAI and @Alibaba_Qwen please take note. With Qwen 4 coming, a strong MoE that fits 8-12GB VRAM + 32GB RAM would land with a huge audience.
Hoy estrenando "Lo técnico para no técnicos", una serie de artículos para explicar la IA de la forma más sencilla posible para gente que no esta metida en el mundo IA. Un artículo nuevo cada miércoles.
El primero: qué es un token, esa palabra que se ve en todas partes cuando usas ChatGPT, Claude u otras IAs.
Todas las opiniones son bienvenidas. Gracias por leer!
https://t.co/JoXaPLQ2ec
Presentando ¡ColIA, laboratorio y comunidad Colombiana🇨🇴 de IA abierta! Un proyecto que he venido planeando hace un tiempo y hoy se hace realidad.
Una comunidad donde todos podamos trabajar en aportar explorando, construyendo, compartiendo o simplemente abriendo espacios donde podamos reunirnos y charlar y debatir nuestras ideas, un lugar para aprender.
No importa si eres experto o no, si empezaste hace años o empezaste hoy, si quieres contribuir eres bienvenido, más que cualquier cosa ColIA es un lugar de comunidad, de todos y para todos.
Blog de presentación para conocer más: https://t.co/DDK0ULnMeT
Hoy estrenando "Lo técnico para no técnicos", una serie de artículos para explicar la IA de la forma más sencilla posible para gente que no esta metida en el mundo IA. Un artículo nuevo cada miércoles.
El primero: qué es un token, esa palabra que se ve en todas partes cuando usas ChatGPT, Claude u otras IAs.
Todas las opiniones son bienvenidas. Gracias por leer!
https://t.co/JoXaPLQ2ec
Presentando ¡ColIA, laboratorio y comunidad Colombiana🇨🇴 de IA abierta! Un proyecto que he venido planeando hace un tiempo y hoy se hace realidad.
Una comunidad donde todos podamos trabajar en aportar explorando, construyendo, compartiendo o simplemente abriendo espacios donde podamos reunirnos y charlar y debatir nuestras ideas, un lugar para aprender.
No importa si eres experto o no, si empezaste hace años o empezaste hoy, si quieres contribuir eres bienvenido, más que cualquier cosa ColIA es un lugar de comunidad, de todos y para todos.
Blog de presentación para conocer más: https://t.co/DDK0ULnMeT
Hola, venimos llegando!👀
Somos ColIA, un laboratorio y comunidad de IA abierta en Colombia🇨🇴! Esperamos conectar con muchos de ustedes, aprender, construir, abrir espacios y aportar en comunidad.
Lee nuestro blog de presentación para conocernos mejor: https://t.co/HbDWG6LzQV
Hola, venimos llegando!👀
Somos ColIA, un laboratorio y comunidad de IA abierta en Colombia🇨🇴! Esperamos conectar con muchos de ustedes, aprender, construir, abrir espacios y aportar en comunidad.
Lee nuestro blog de presentación para conocernos mejor: https://t.co/HbDWG6LzQV
@entretokens Me gustaría, lastimosamente no cuento con placas para hacer pruebas.
Mas adelante cuando tenga alguna estaré encantado de hacer pruebas a ver hasta donde podemos llegar con estos modelos y compartir los resultados!
LFM3-1.7B receta de un nuevo y excelente modelo para usar sin GPU!
37 tok/s de generación y hasta 150 tok/s de prefill en un portátil sin tarjeta gráfica.
120 tok/s de generación (ojalá saquen el modelo especulativo, creo que puede subir más su generación) y unos 4450 tok/s de lectura en una RTX 3050 6GB VRAM.
Un modelo perfecto para determinadas tareas específicas, útil para extracción, resúmenes, traducciones, uso de herramientas y demás (preparando un par de benchs al respecto).
Un excelente trabajo por parte de @liquidai con este modelo, como lo dije en la anterior publicación, ya estoy deseando los modelos grandes de esta familia LFM3.
OJO:
1. La licencia permite su uso comercial para empresas que facturan menos de 10M USD al año.
2. Ya advierte Liquid que no es un modelo recomendado para programación con agentes. Si buscas un modelo especializado para eso este no es el indicado (aunque ciertamente no es un mal modelo, para dudas sencillas al respecto puede ser útil).
Introducing 𝙻𝙵𝙼𝟹: our new generation of Liquid Foundation Models. With a new tri-hybrid architecture and new multimodal encoders, the LFM3 family is the ideal model suite for specialized intelligence.
> 6 model instances, across text, audio, vision, and omni modalities, generative and decision models.
> 𝙻𝙵𝙼𝟹-𝟷.𝟽𝙱: text, 256k context window.
> 𝙻𝙵𝙼𝟹-𝚅𝙻-𝟸𝙱: vision-language model with video-input support for spatial understanding
> 𝙻𝙵𝙼𝟹-𝙰𝚞𝚍𝚒𝚘-𝟸𝙱: tool calls, voice chat, reasoning in 18 languages.
> 𝙻𝙵𝙼𝟹-𝙾𝚖𝚗𝚒-𝟸𝙱: an omni model combines vision, audio, and language.
> 𝚍𝟷-𝟸𝙱 and 𝚍𝟷-𝙾𝚖𝚗𝚒-𝟸𝙱: decision models with typed outputs and calibrated probabilities in a single pass. Omni adds audio input.
> fine-tune on 1 GPU.
> a new tri-hybrid architecture
> architecture optimized for 14 processor classes across GPUs, CPUs, and NPUs.
> 𝙻𝙵𝙼𝟹-𝚅𝙻-𝟸𝙱 is a beast. It performs competitively with Gemma 4 12B (6x larger), and Gemini 3.5 Flash Lite, and GPT-5.6 Luna, with 1.9B parameters.
> 𝙻𝙵𝙼𝟹-𝟷.𝟽𝙱 is #1 on the Pareto frontier of device intelligence 𝚙𝚒𝚙𝚎𝚝𝚝𝚎.𝚕𝚒𝚚𝚞𝚒𝚍.𝚊𝚒
Every modality for specialized intelligence. Pick the one that fits your use case, customize it, and run it on-device.
1/ 🧵
@ditorodev En mis pruebas puntua peor que Gemma4 en traducciones (no por mucho), sin embargo en resumenes le va mejor que a Gemma recuperando hechos, aunque también es el que mas inventa.
Aun midiendo, pero pronto con resultados mas organizados para publicar y visualizar!