@erhanmeydan Hocam bu günlerde en önemli mesele; kimi takip edeceğini ve neyi tüketeceğini bilmek. Kim kaliteli içerik üretiyor hangi eğitimler/içerikler kaliteli sorularının cevapları çok değerli.
@efebulduk@efebulduk Bey; WinningCyle'dan önceki TG gurubunuzda Euler Tools'dan erken alım avantajından yararlanmak için gurubunuza 100$ göndermiştim. En son yanlış hatırlamıyorsam ekip token dağıtımını ertelemişti. Mümkünse bu 100$'ın akıbetini öğrenebilir miyim?
Code with Claude is happening now!
▪︎ 9:00AM - Keynote
▪︎ 10:30AM - What's new in Claude Code
▪︎ 11:15AM - Building on Claude at GitHub scale
▪︎ 12:00PM - Get to production faster with Managed Agents
All times PT. https://t.co/O4oygkSr2G
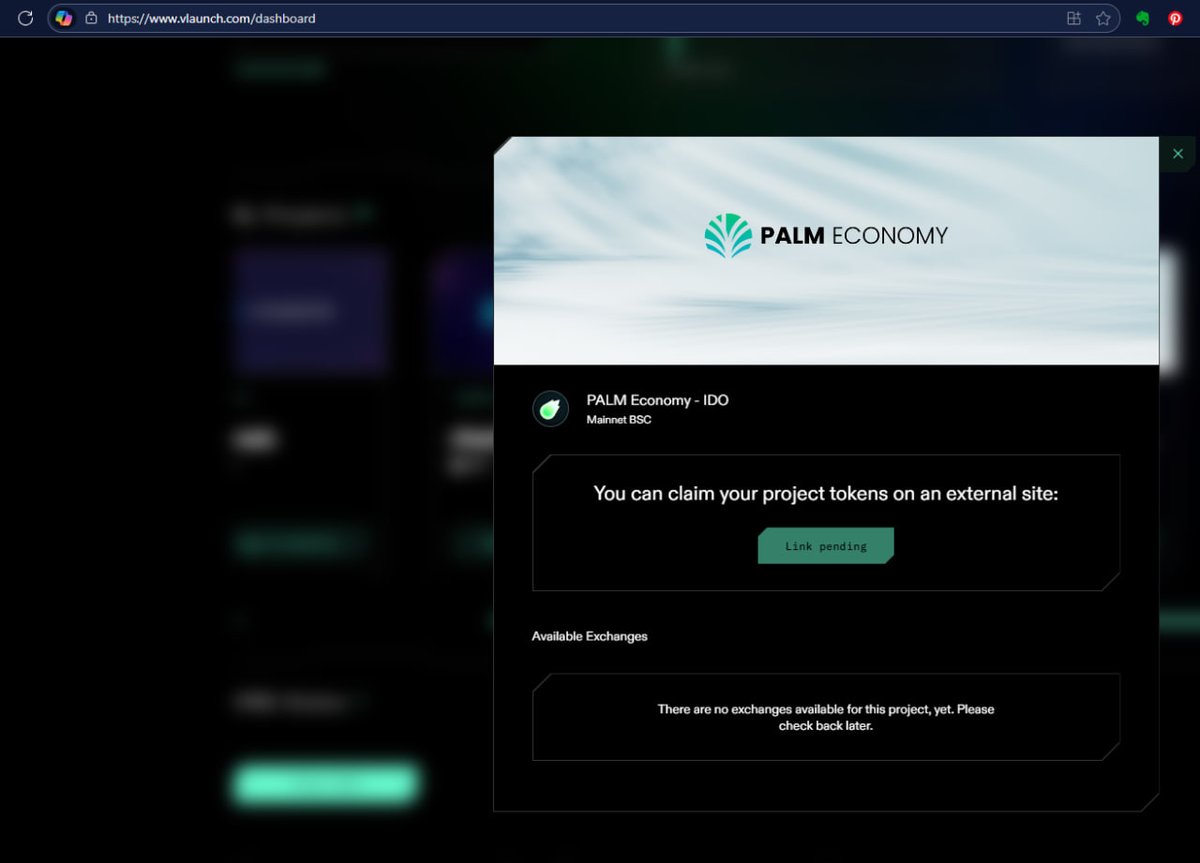
@palmeconomy I participated in the $palm token IDO on Vlaunch. It's been over two years. When I try to claim my tokens, I see the attached screen. Can you help me?
@ninjatradersx@CryptoKemal başkan Ninja Terminal'i kimse bilmiyor. Terminal'i yaygınlaştırmak için Tier 2'te ayda 5 gün ve Tier 3'te ayda 10 ücretsiz yapmak çok işe yarar.
DeepSeek, OpenAI, TSMC, ASML, Nvidia, ABD, Çin, Stargate, Yapay Zekâ Asistanları Üzerine
Lex Fridman en iyi podcast yayıncılarından biri. Dylan Patel ve Nathan Lambert'in katıldığı 5 saatlik yayından önemli bilgileri derledim.
Uzun zamandır podcast dinliyorum & izliyorum. Bu en iyilerden biri oldu. 5-10 dk ayırırsanız çok faydalanacağınızı düşünüyorum.
Bu yazı sonrasında yapay zekâ (AI) bilginizi 1-2 kademe artıracaktır. Öncelikle model kalitesi, açık kaynak gibi kavramlardan bahsedeyim.
🖊️ Model kalitesi: kullanılan verilerin kalitesine, o verilerin filtrelenme ve işlenme sürecine bağlı. Bu veriler uzun süre boyunca, güçlü kaynaklarla eğitilirse o model o kadar kaliteli olur. Modelin eğitilmesi için yazılan kodun kalitesi de önemli.
✏️ Açık kaynak: açık veya kapalı kaynak kodu 0 veya 1 olan bir kavram değil, kademeleri var. DeepSeek modeli “open weight” olarak geçiyor.
🖌️ Veriler açık değil ama mevcut modelle örnek veri üretip farklı ürünler geliştirebilirsiniz. Ayrıca neyi, nasıl yapacağınızı açıklayan çok fazla teknik rapor ve kod var. Bu nedenle açık kaynağa en yakın model denebilir.
---
DeepSeek/Çin bizim verilerimizi çalabilir mi?
▪️ Kullandığınız model herhangi bir veri çalmaz. Ancak host/sunucu tarafına veri gönderirseniz burada ilgili şirketin (OpenAI veya DeepSeek) insafına kalırsınız. Eğer DeepSeek modelini bilgisayarınıza indirip offline olarak kullanırsanız herhangi bir veri çalınma riskiniz olmaz.
DeepSeek v3 ile DeepSeek R1 farkları
🔸 DeepSeek v3 modeli OpenAI tarafından geliştirilen GPT-4 modeline benziyor. Bu modeller (LLM) internetten arama yaparak en iyi cevabı vermek üzere veri ve işlemcilerle geliştirilmiş durumda.
🔹 DeepSeek R1 modeli ise OpenAI tarafından geliştirilen o1 modeline benziyor. Bu modeller 2 aşamada cevap veriyor (önce DeepSeek v3 veya GPT-4 gibi çalışıyorlar, ardından daha iyi cevap verebilmek için reasoning/nedensellik çalıştırıyor yani kendine sürekli “daha iyi bir cevap ara” şeklinde sorular soruyor).
Bu sayede çok daha etkili, kişiye veya konuya özel yanıtlar üretebiliyor.
DeepSeek neyi farklı yapıyor?
🖊️ Llama’da modeli eğitirken bütün model tek bir parça gibi çalışıyor. Her etkileşimde büyük bir kaynak kullanıyor. DeepSeek’te ise modeli eğitirken sadece gerekli/ilgili kısımlar eğitiliyor.
Bunu yapmak zor olsa da başardığınız zaman maliyetleri büyük oranda düşürebiliyorsunuz.
✏️ Futboldan bir örnek verirsek Meta tüm futbolcularına şut, pas, kalecilik çalıştırırken DeepSeek forvete şut, kaleciye kalecilik çalıştırıyor diyebiliriz. Bu sayede Meta’nın kullandığı kaynakların %5-10 kadarını kullanarak aynı kalitede model geliştiriyorlar.
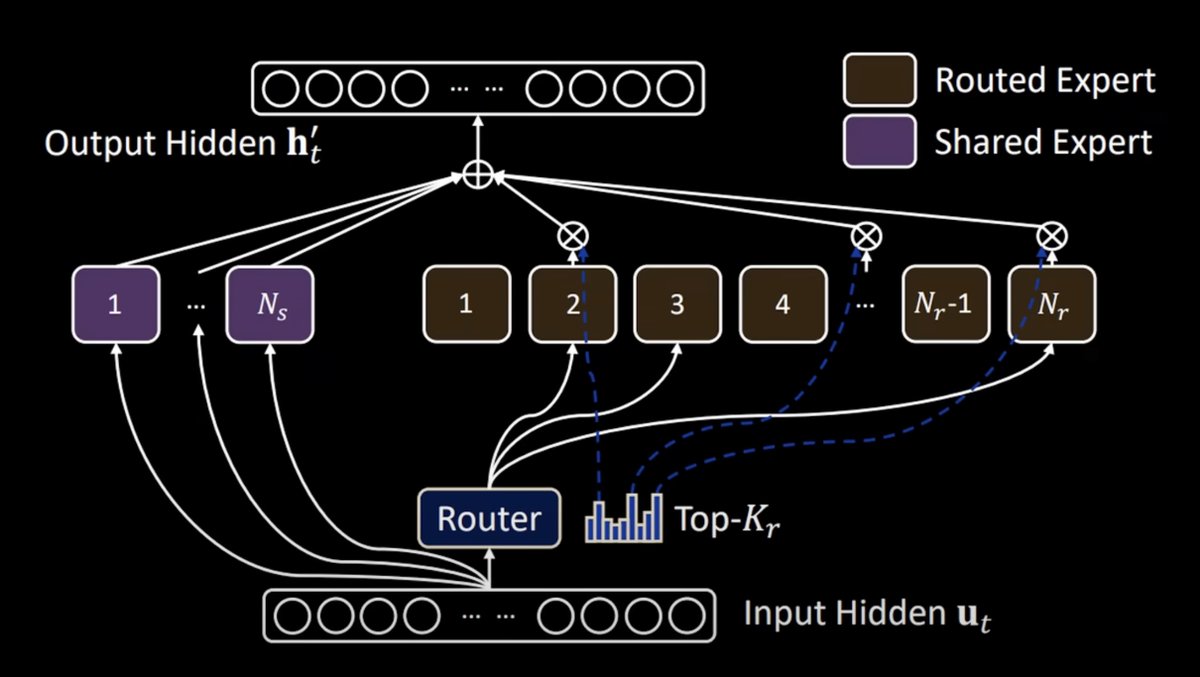
🖌️ Meta’nın geliştirdiği Llama için "dense model" ifadesi kullanılıyor. OpenAI ve DeepSeek modelleri ise mixture of experts (MoE) olarak tanımlanıyor. Yeni modellerin bu yapıyla geliştirilmesi bekleniyor.
▪️ Görselin tümünü bir model olarak ele alırsak DeepSeek ve OpenAI için tüm model yerine ilgili kutucuğun çalıştığını düşünebiliriz.
---
Neden GPU olarak Nvidia kullanılıyor?
🔸 Nvidia modellerin nasıl geliştirileceğine dair bir kütüphane sunuyor (NCCL). Tüm yazılımcılar bu kaynaktan faydalandığı için Nvidia tekel hâline gelmiş durumda.
🔹 GPU kaynağı olarak da güçlü ürünler sunduğu için yerinin sarsılması epey zor görünüyor. DeepSeek kütüphane konusunda da bir çalışma yapıyor ama gitmesi gereken daha çok yol var.
Meta, Google, OpenAI neden bu kadar GPU kullanıyor?
🖊️ Model geliştirmesi için irili ufaklı çok fazla araştırma/deneme yapılıyor. Bu denemelerin çoğu sonuç vermiyor ancak denenmesi gerekiyor.
✏️ Meta’nın elinde 60-100 bin adet H100 GPU bulunuyor. Diğer GPU’lar da dikkate alınırsa 500 bin civarında GPU’ya sahipler. Llama 3’ün geliştirilmesi için 16 bin adet H100 GPU kullandıkları biliniyor.
🖌️ DeepSeek v3 modeli için 2 bin adet H100 GPU ile modeli eğittiğini belirtiyor (Nathan ve Dylan bunun 10 bin adet civarında olduğunu tahmin ediyor).
Ancak R1 modeli için herhangi bir bilgi vermiyor. DeepSeek’i uzun süredir takip eden Dylan ve Nathan, DeepSeek’in elinde 50 bin adet GPU olduğunu belirtiyor.
Neden tüm kaynaklar model eğitiminde kullanılmıyor?
▪️ Model eğitimi sürecin sadece bir parçası. Örneğin siz GPT-4 ile her etkileşime girdiğinizde OpenAI bir miktar GPU kaynağı kullanıyor.
🔸 Bu nedenle sadece model eğitim sürecinde değil, tüm ürünlerin aktif kullanımında GPU gerekiyor. Örneğin Meta, özellikle Instagram için oldukça fazla GPU kaynağı kullanıyor (reklamlar, algoritma yönetimi için).
---
DeepSeek'in hikâyesi
🔹 Liang Wenfeng, AI odaklı yatırımlar için 2016 yılında High-Flyer isimle bir fon şirketi kuruyor. Yüksek frekansta al/sat yapabilmek için binlerce GPU satın alıyor.
🖊️ Kurduğu şirketin odağını 2023 yılında insansı yapay zekâya (AGI) çeviriyor ve DeepSeek adıyla çalışmalarına devam ediyor. Liang AGI gelişmelerine Çin’in liderlik etmesi gerektiğini savunuyor.
GPU ambargosu ve alternatif rotalar
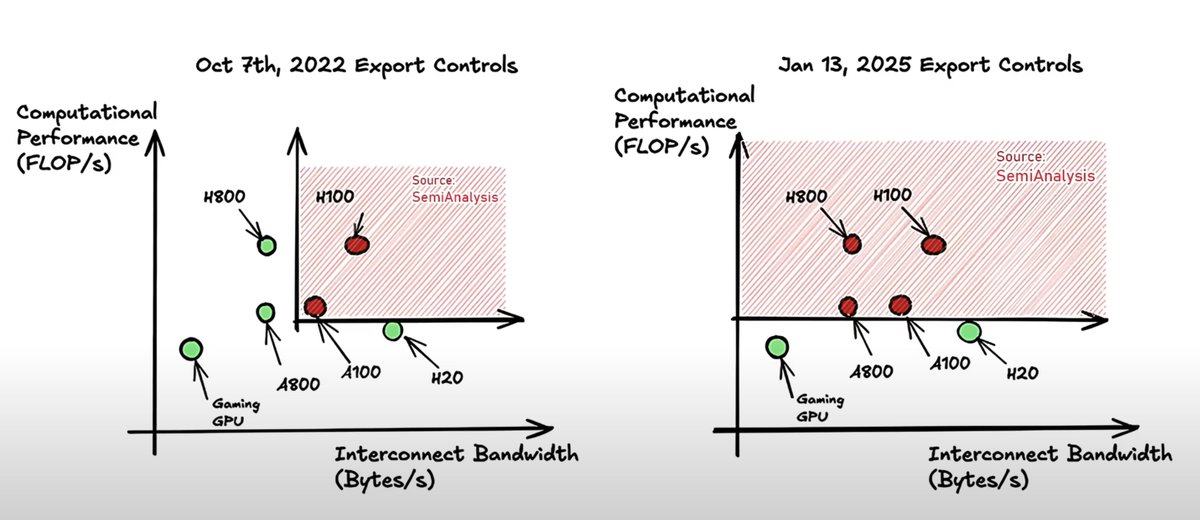
✏️ ABD’nin uyguladığı GPU ambargosu başlamadan önce DeepSeek’te A100 GPU’ları olduğu biliniyor.
🖌️ Dylan ve ekibinin yaptığı araştırmaya göre DeepSeek’in elinde şu anda 20 bin adet H100 ve 30 bin adet H20 var. H20 daha az performans veriyor ancak daha fazla hafıza kapasitesi var.
▪️ Görselde kırmızı olanlar Çin’in ambargo nedeniyle alamadığı GPU’lar. ABD 2022’de devreye aldığı ambargoda H800’leri göz ardı ediyor.
🔸 Aslında H800’ler de H100’lere yakın performans veriyor, sadece bandwidth/genişliği düşük. Trump seçildikten sonra ambargoyu H800 ve A800’leri içerecek şekilde genişletiyor.
🔹 H20’ler hafıza konusunda daha iyi ve reasoning/nedensellik modelleri için gerekli. Buradan yola çıkarak ABD’nin H20’lere de ambargo getireceğini öngörebiliriz.
🖊️ Üstteki görselde dikey ekseni (FLOPS) DeepSeek v3 & OpenAI GPT-4 için gerekli, yatay ekseni (Bandwidth) DeepSeek R1 & OpenAI o1 için gerekli gibi düşünebilirsiniz.
✏️ ABD şu anda dikey ekseni dikkate alıyor ancak yatay ekseni de dikkate almaya başlayacak gibi duruyor.
Neden ambargo var?
🖌️ Dünyadaki AI liderleri bu alandaki gelişmelerin insan hayatını ve toplumu ciddi anlamda değiştireceğini öngörüyor. Bu nedenle büyük çoğunluk ilk ulaşan tarafın ABD olmasını istiyor.
▪️ Çin ABD’den 1 yıl sonra ulaşırsa sorun olmaz deniyor ancak Çin’in önce ulaştığı senaryolarda Çin mentalitesinin veya propagandasının dünyaya yerleşmesinden korkuyorlar.
🔸 GPU en ölçülebilir metriklerden biri. Dolayısıyla ABD bu alanda önde olmayı takıntı haline getirmiş durumda. Buradan da OpenAI çalışmalarına kapalı kaynak kodlu olarak devam edecek sonucunu çıkarabiliriz.
Ambargo varsa bunları nasıl temin ediyorlar?
🔹 Portekiz, Singapur ABD ile iyi geçinen ülkeler olsalar da ABD bu ülkelere de kısıtlı GPU satışı getirdi. Bunun nedeni bu ülkelerden şirketilerin GPU alıp Çinli şirketlere satış yapması. Ayrıca düşük miktarlarda farklı ülkelerden de geçişler oluyor.
---
ASML & TSMC
🖊️ ASML Hollanda merkezli bir şirket. Değeri $300 milyar civarında ve çip üretilmesi için gerekli olan makineleri üretip satıyor.
✏️ TSMC Tayvan merkezli bir şirket. Değeri $1 trilyon civarında ve dünyada üretilen çiplerin %65 kadarını üretiyor. Yeni nesil 3 ve 5 nanometre çiplerde bu oran daha da yüksek.
🖌️ Neredeyse teknolojik her alette çip mevcut. Bir Tesla aracının kapı kolunda 2 adet, elektrikli bir araçta toplamda 5 bin adet çip olduğunu düşünürsek TSMC’nin önemini daha iyi kavrayabiliriz.
Çin bu çipleri kendi üretebilir mi?
▪️ 7 nanometreye kadar olan çipleri üretebiliyor ancak 3 ve 5 nm için yeterli litografi araçları (EUV) yok. Çin bu konuda da ambargoya maruz kalıyor. Öte yandan standart elektrikli aletlerde kullanılan çiplerde Çin’in pazar payı giderek artıyor.
🔸 Çin elektrikli araçlarda (BYD için gerekli çiplerin çoğu Çin’de üretiliyor) ve yenilenebilir enerji alanında dünyanın ilk sırasına yerleşmesinin ardından rotasını çip teknolojisine ve yapay zekâya çevirmiş durumda.
ABD TSMC’nin aynısını kendi topraklarında kurabilir mi?
🔹 TSMC’nin Arizona’da bir fabrikası var ve toplamda üretilen çiplerin %20’si zaten ABD’de üretiliyor. Burada üretilen çiplerin en büyük müşterisi Apple.
🖊️ ABD kendi topraklarında üretilen çiplerin oranını artırmak istese de Tayvanlı bilim insanlarının ve mühendislerin tecrübesi, adanmışlığı, iş etiği çok farklı bir seviyede. Dylan ve Nathan yaklaşık 15 dakika bu konunun altını çizdiler.
✏️ Kısacası ABD ve Çin yeni nesil çipleri kendi başlarına üretmeye çalışsalar da Tayvan önemini korumaya devam edecek. Çin’in bir askeri müdahalesi durumunda ise ABD’nin de müdahale etmekten başka bir seçeneği yok.
🖌️ TSMC’yi özel kılan son özellik ise Ar-Ge ve üretim kabiliyeti. Her yeni nesil çip ihtiyacı doğduğunda (7-5-3 nm) adapte olamayan şirketler batma riskiyle karşı karşıya kalıyor (AMD).
▪️ TSMC 3 veya 2 nm gerektiğinde dünyadaki tüm ihtiyacı karşılayacak üretim stiline ve tecrübesine sahip. Bu nedenle dünyadaki tüm şirketlere çip satmaya devam edecek.
---
Şimdi kısa süreliğine biraz tekniğe giriyoruz. Kısa ve net anlatmaya çalışacağım.
Keys & Values (KV Cache)
🔸 Yapay zekâ modellerinin internette taradığı kelimeleri ne kadar hızlı taradığı önemli bir metrik. Buna ek olarak taradığı bu kelimeleri birbirine bağlayıp onlardan bir anlam çıkarması da çok önemli.
🔹 Siz bir şeyler yazdığınızda model bunu hafızasına atarak bir çıktı üretmeye çalışıyor. Her kelime ürettiğinde tekrar hafızasına ve son ürettiği kelimeye bakarak (bunlara KV cache / modelin ürettiği değer deniyor) yeni bir kelime üretiyor. Modelin ürettiği çıktı ne kadar uzarsa üretilen şeyin maliyeti geometrik şekilde çok artıyor.
🖊️ Başka bir açıdan bakarsak; reasoning (güçlendirilmiş & nedensellik arayan) modellerini ne kadar çok insan kullanırsa maliyetler de o kadar artıyor çünkü çok fazla hafıza kullanımı var.
✏️ Bu nedenle OpenAI o1 kullanımı geniş kitlelerin kullanabileceği durumda değil ve çok pahalı. Hatta Sam Altman, bu modelin kullanımından zarar ettiklerini belirtiyor.
🖌️ Üstte hız konusunda H100 ve hafıza konusunda H20 gerektiğinden bahsetmiştim. İşte modelin kaliteli bir çıktı üretebilmesi için yeterli hıza ve hafızaya ihtiyacı var. Bu da GPU gücüyle sağlanıyor. Bu GPU’ları bir arada çalıştırmak için de devasa veri merkezlerine ihtiyaç duyuluyor.
---
DeepSeek v3 ve R1 neden ücretsiz?
▪️ Çalışma koşulları muhtemelen ABD şirketlerinden çok farklı (çalışan ücretleri, çalışma saatleri gibi).
🔸 10 kere gözden geçirme yapmadıkları için ürün piyasaya hatalı çıksa da (modelin cevapları hatalı olsa da) düzeltiriz mantığıyla hareket ediyorlar. Ne kadar çok insan kullanırsa insanlar modele o kadar aşina olur düşünceleri de var.
🔹 Dylan ve Nathan, hatalı modellerin piyasaya salınması durumunun ABD’li AI şirketlerine de kısmen yansıyacağını düşünüyorlar (ABD ile Sovyetler arasındaki uzay yarışında alınan risklere atıfta bulunuyorlar).
🖊️ Kısmen hatalı da olsa piyasada önce yer almak, hazır bir ürünle geç kalmaktan daha önemli diye düşünüyorlar.
✏️ DeepSeek'te asıl maliyet düşüşü tekniğe dayalı. Ürettikleri modelin mimarisi farklı ve bu hafıza kullanımını epey düşürüyor.
🖌️ Ancak kullanıcı sayısı artarsa bunu sağlayacak GPU gücü ellerinde yok. DeepSeek 50 bin GPU’ya sahip olsa dahi bunun bir kısmını model eğitiminde kullanıyor. Müşterilere/kullanıcılara destek sağlamak için farklı GPU kaynaklarına ihtiyaçları var.
▪️ Mevcut kullanımında ortaya çıkan model kullanım masraflarını karşılamak için Çin hükümetinden veya DeepSeek’in bağlı olduğu High-Flyer fon şirketinden destek alıyor olabilirler.
🖊️ Ayrıca duyuruyu yaptıkları dönemde Nvidia için short işlem / açığa satış yapmış olabilirler.
---
Algoritma tavsiyeleri & sansür
✏️ Bugün kullandığımız neredeyse tüm sosyal medya platformları bize neyi izlemeyi, okumayı sevebileceğimizi & hangi ürünleri satın alabileceğimizi sunuyor. Bu şirketler en çok parayı da bu şekilde kazanıyor.
🖌️ Ayrıca çeşitli toplulukların önüne benzer haberler çıkarılarak ilgili toplulukların düşünceleri, inançları da manipüle edilebiliyor.
▪️ Konu AI olunca, buradaki ikna becerisi epey artıyor. Kullandığımız modeller eğer bir devlet veya şirket tarafından bizi belli konularda yönlendirmek için tasarlanırsa bu konuda başarılı olması oldukça yüksek bir ihtimal.
🔸 Bu nedenle ülkelerin birbiriyle yarışmasının alt metnini de anlayabiliyoruz. Modeller bu yönlendirmeleri yapmak zorunda değil, ancak isterlerse bunu yapabilecek güçte olmaları endişe verici.
🔹 Bu konu başlığına sansürü de ekleyebiliriz. Farklı modeller, aynı konular hakkında farklı bilgiler verebilirler veya o konuda hiç bilgi vermeyebilirler.
🖊️ Modellerin interneti tarayarak cevap verdiğini düşündüğümüzde internette hangi kaynakları kullanacağını yönlendiren ekipler oldukça sansür de uygulanacaktır.
✏️ Bu konuda çok fazla kişinin kullanmadığı, tamamen objektif modeller de piyasaya çıkacaktır. Ancak fazla insan kullandığında maliyetlerin de artacağı düşünülürse büyük kitlelerin şirketlerin geliştirdiği modelleri kullanacağını öngörebiliriz.
🖌️ Belki de merkeziyetsiz projeler gerçek hayata dair kullanışlı ürünler sunabilirler.
---
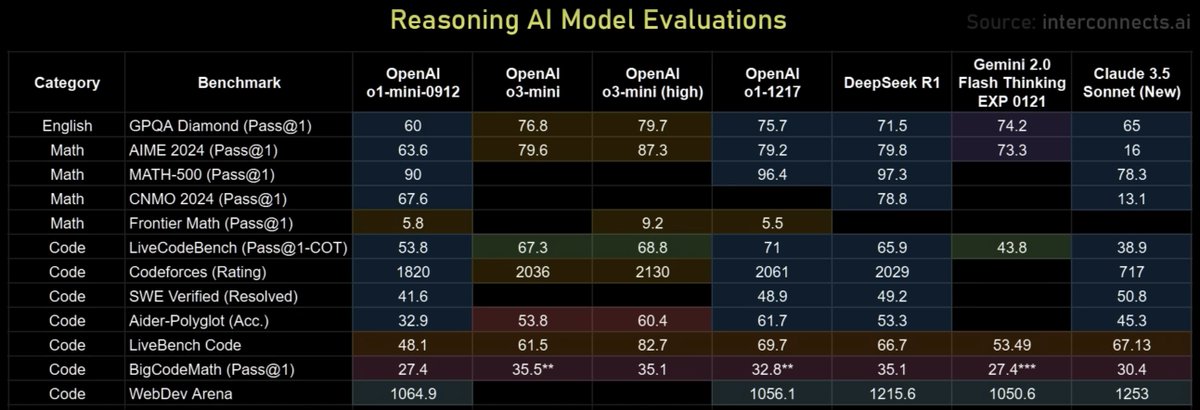
OpenAI o1 & o3-mini & Gemini 2.0 & DeepSeek R1
▪️ Reasoning/nedensellik modellerini kısa bir örnekle açalım: AlphaZero ve AlphaGo algoritmaları, Go ve satranç gibi oyunlarda bu oyunların büyük ustalarını neredeyse tüm maçlarda yendiler.
🔸 Bunu sadece daha önce oynanan maçlardaki hamleleri ezberleyerek yapmaları mümkün değil. Ancak algoritmalar kendi kendine de senaryolar üreterek geliştikleri için çok daha başarılı hale geliyorlar.
🔹 Özellikle yapılacak hamle sayısı sınırlı ise veya matematiksel net bir cevap varsa algoritmalar bunu bulabiliyor.
🖊️ Bu başlıktaki modeller için kendi kendine sorarak gelişen modeller diyebiliriz. Bu nedenle önceki versiyonlarından daha iyiler. Özellikle matematik ve kod alanında çok iyi sonuç veriyorlar.
✏️ Pek fazla kimse konuşmasa da Google’ın geliştirdiği Gemini 2.0 Flash Thinking, DeepSeek R1’e göre daha verimli çalışıyor (ucuz, hızlı). Her aşamada cevaplarını gösteriyor (chain of thought) ve son cevabının nasıl şekillendiğini takip edebiliyorsunuz.
🖌️ Görselde modellerin başlıklara göre hangi puanı aldıklarını görebilirsiniz. Puanlar kaç üzerinden konusuna girmeden kıyaslamaları olarak inceleyebilirsiniz.
✨ Tüm modellerin maliyetleri düşüyor. 2022’de 1 milyon token/kelime başına $100 olan maliyetlerin 2025/2026’da $0.001 olması bekleniyor.
✨ Bu bize teknolojinin ne kadar hızlı ilerlediğini ve son kullanıcıların tüm kaynaklara kolayca erişebileceğini gösteriyor.
---
Nvidia (NVDA)
🖊️ DeepSeek, maliyetlerinden bahsederken sadece v3 model eğitim maliyetlerini açıkladı. Ar-Ge, maaşlar, R1 hesaba katılınca maliyetleri artıyor.
✏️ Google, Meta, OpenAI milyarlarca dolar harcıyor ve harcamaya devam edecek. Jevons paradoksu geçerli olacak ve artan verimlilik daha da fazla kaynak kullanılmasına yol açacak gibi görünüyor. Bu durumda Nvidia’nın siparişleri ve kârlılığı da devam edecektir.
🖌️ Çinli şirketler H20 GPU satın alabiliyor ve milyonlarca satın alıyorlar. ABD’nin bu konuda nasıl bir tutum sergileyeceği de Nvidia’nın satışlarını etkileyecektir.
▪️ Ancak hisse fiyatı çok spekülatif bir şey. Teknolojinin yönü ve Nvidia’nın yol haritası net olsa da çıkan haberlere göre yatırımcı davranışları değişkenlik gösterecektir.
---
AI megaclusterlar
🔸 Modelle etkileşime girildiğinde gelen taleplere (inference) karşılık vermek için veri merkezlerine ihtiyaç duyuluyor. Bu merkezlerde GPU’lar, soğutucular, sunucular yer alıyor.
🔹 Bazen bir talep geldiğinde bu sadece kısa bir yazı oluyor. Bazen bir oyun veya video için rendering talebi, bazen de AI şirketlerinin model geliştirme talepleri geliyor.
🖊️ Bu durumda kaynakların verimli kullanılması için koordinasyon gerekiyor. Bu taleplere en yakındaki sunucu üzerinden hizmet verilmesi sağlanıyor.
✏️ Tüm bu talepler enerji tüketimini artırıyor. OpenAI 100bin GPU ile, Meta 128 bin GPU ile, xAI 200 bin GPU ile model geliştirme yapıyor.
🖌️ Bu şirketler gigawatt mertebesinde tüketim yaptıkları için enerji alanında da büyük hamleler gelecektir.
▪️ Soğutma için hava soğutması şu anda sektör standardı ama sıvı ile soğutma yeni sektör standardı olacaktır.
🔸 Elon Musk, xAI fabrikasında sıvı soğutması kullanıyor. Bu sayede GPU’lar birbirine daha yakın kurulabiliyor (daha hızlı iletişim). Ek bilgi: soğutma, enerji alanında veri merkezlerine hizmet veren şirketleri bulabilirseniz güzel yatırım fırsatları yakalayabilirsiniz.
---
AGI (insansı yapay zekâ) tahminleri
🔹 Beklentileri 2030 yılında süper AI veya AGI seviyesine ulaşılacağı yönünde.
🖊️ Ancak bu tarihin öncesinde birbiriyle iletişime geçen ai agents (yapay zekâ asistanlarının) veya botların toplum mühendisliği yapmaya başladıklarını, seçim dönemlerinde çok fazla manipülasyon yapıldığını ve yapılacağını belirtiyorlar.
AGI yarışında kim önde?
✏️ Google altyapı nedeniyle büyük bir avantaja sahip. OpenAI en iyi ve en kârlı modele sahip. Google, xAI, Meta vb. AI ile elde ettikleri bilgiyi algoritmalarda & reklamlarda kullanıp farklı ürünlerle daha fazla para kazanmanın da yolunu açıyorlar. Bu da daha fazla geliştirme için kaynak sağlıyor.
🖌️ Tek bir şirketin insansı yapay zekâya ulaşması yerine sürekli gelişen bir sektör ve şirketler topluluğu görünüyor. OpenAI diğer şirketler gibi farklı ürünlere sahip değil (örneğin Meta için Instagram, Google için Cloud) bu nedenle başarmak zorunda görünüyor.
AGI risklerine bir örnek
▪️ Diyelim ki birlikte çalışan bir grup robot, AI kullanarak ABD’de 2 gün boyunca elektrikleri kesecek bir açık buldu. Bu durumda yaşanacak kaos toplumu bambaşka bir noktaya götürebilir.
Bu nedenle AGI konusu teknoloji ile birlikte ülke güvenliği açısından da kritik bir konumda duruyor.
---
Yapay zekâ asistanları (AI agents)
🔸 Reasoning/nedensellik modellerini kullanan bir yapay zekâ asistanı kendini geliştirmeye devam etmeli, konuları birbirine bağlayarak çıkarımlar yapmalı.
🔹 Konuşmak/chat aşama 1 ise, reasoning aşama 2 oluyor. Yapay zekâ asistanları için aşama 3 diyebiliriz.
🖊️ Yapay zekâ asistanlarının yaygınlaşması için reasoning modellerinin iyice gelişmesi gerekiyor. Bu konuda OpenAI öncü çalışmalar yapıyor ancak halen gidilmesi gereken çok yol var.
✏️ Diyelim ki yapay zekâ asistanı 3 işi birbirine bağlayarak sıralı şekilde yapacak. Her aşamada %95 doğru ilerleme şansı varsa asistanın doğru sonuca ulaşma ihtimâli 0,95 x 0,95 x 0,95 = 0.857 yani %85.7 oluyor.
🖌️ Bu ürünün satılabilmesi mevcut haliyle zor olur, bu nedenle 1-2 yıl içinde yaygınlaşması muhtemel.
▪️ Genel işler için tasarlanan asistanlar hata yapabilir bu nedenle belli görevler için (yemek siparişi, uçak bileti, takvim yönetimi gibi) özelleştirilmiş asistanlar daha iyi sonuç getirebilir.
🔸 Kodlama alanında asistanların çok tecrübeli olmayan yazılımcıların yerini alacağına dair beklentiler mevcut.
🔹 Kripto alanındaki yapay zekâ asistanları yazılarımı ayrı başlıklarda yazdığım için burada bahsetmiyorum.
---
Stargate
🖊️ Veri merkezlerinin kurulması için federal arazilerin kullanılması, geliştirmeler için 500 milyar dolarlık paket gibi hamlelerle ABD bu alandaki tavrını ortaya koydu.
✏️ İlk aşamada yatırımlar için 50 milyar dolar harcayacaklar. OpenAI geliştirme yaparken Oracle, SoftBank yatırımı sağlayan ana aktörler olacak gibi duruyor. Hükümetten para alacaklar mı net değil ama en azından gerekli regülasyonlar konusunda yolları açık.
---
Yapay zekânın geleceği
🖌️ Yapay zekâda öne geçen şirketler ve ülkeler kendi propagandalarını yapma konusunda iştahlı olacaktır. Bu nedenle merkeziyetsizlik önemli bir noktada duruyor.
🔸 Bunun yanında yapay zekâ modellerine, asistanlarına erişim giderek daha da kolaylaşacaktır. ABD ve Çin arasındaki gerilim devam ederken farklı ülkelerden farklı modeller çıkacak mı zaman gösterecek.
✨ Gelişmeleri takip etmeye, modelleri kıyaslamaya, kullanım alanlarına göre yapay zekâ asistanları hakkında bilgiler paylaşmaya devam edeceğim.
✨ Faydalı bulduysanız beğenmenizi ve paylaşmanızı rica ederim. Elinizde araştırma için güzel kaynaklar varsa yorumlarda bahsedebilirsiniz.
@CryptoKemal Başkan bu hareketlerle o salladığın eline ne geçiyor bize grafiğe bakarak tekrar anlatır mısın? O kadar uğraşıyoruz falan diyorsun yakışıyor mu ?
@fkadev@cursor_ai Ekteki gibi bir search güzel olabilir. Ayrıca sık kullanılanlar ve favoriler özelliği de güzel olabilir. Ana sayfada en üstte ilk beş favoriler ve ilk beş sık kullanılanlar listelenebilir.