Do tej pory publikowałem tu sporadycznie, po angielsku i pod pseudonimem. Od dziś piszę głównie po polsku, pod własnym nazwiskiem i bardziej regularnie.
Na co dzień jestem lead developerem w firmie, która buduje narzędzia AI dla legal tech. Z dużymi modelami językowymi pracuję codziennie, przy produktach, za które klienci realnie płacą. Po godzinach eksperymentuję w domu: buduję systemy oparte zarówno na modelach „chmurowych”, jak i na uruchamianych lokalnie. Sprawdzam, co da się zautomatyzować i ile to naprawdę kosztuje.
Chętnie dzielę się spostrzeżeniami o tym, co działa, a co nie, i przemyśleniami o tym, gdzie to wszystko zmierza. I równie chętnie podyskutuję, bo w tej dziedzinie wszyscy jeszcze się uczymy, najczęściej od siebie nawzajem.
Dokumentację moich projektów piszą głównie agenci AI i na początku powstawała w plikach Markdown (prosty format tekstowy, który model czyta bez problemu, ale ja otwierałem go rzadko). Teraz to strony HTML, które otwieram w przeglądarce, i dopiero od tej zmiany naprawdę ją czytam.
Większość projektów ma u mnie własny mały serwis z dokumentacją: menu boczne, spis treści na stronach, tabele, wyróżnione ostrzeżenia i tryb ciemny. To zwykłe pliki, które otwierają się prosto z dysku (bez serwera, bez internetu i bez dodatkowych narzędzi), a wygląd wszystkich stron serwisu jest opisany w jednym wspólnym pliku stylów (CSS), dzięki czemu agent dopisuje tylko treść, a nowa strona od razu wygląda tak samo jak pozostałe. Dziś mam 79 takich serwisów (razem 660 stron).
Z tego, co widzę, agentowi zmiana formatu nie przeszkadza, bo kod strony (tekst razem ze znacznikami, które opisują jej układ) czyta równie dobrze jak Markdown. Ma to swoją cenę (znaczniki też zajmują miejsce, więc pliki HTML są u mnie w sumie około półtora raza dłuższe niż sam tekst, który zawierają), ale agent i tak nie wczytuje całej dokumentacji naraz. Markdown został głównie tam, gdzie czyta go agent: w pliku z instrukcjami, który wczytuje, kiedy zaczyna pracę w danym projekcie (jest w nim lista stron i informacja, co znajdzie na której), a potem otwiera tylko te strony, których potrzebuje przy danym zadaniu.
Chyba najwięcej zyskałem na tym, że błędy w dokumentacji zauważam teraz sam, kiedy ją czytam, a nie dopiero wtedy, gdy agent zrobi coś źle na podstawie nieaktualnego opisu 🙃
@jacekdziwisz Matematyka matematyką, ale przy jednej z moich piosenek (tekst napisał Claude, a muzykę wygenerował model działający u mnie w domu) wybierałem spośród 36 wersji (dwa teksty, cztery style) i zakładam, że część tej „duszy” siedzi właśnie w tym wyborze 🙃
W piątek pisałem o tym, jak model zaprojektował w Blenderze część do druku 3D (a ja Blendera wcześniej nie używałem). Tym razem sprawdziłem, jak poradzi sobie z krótką animacją: ta sama scena w pięciu stylach, od siatki (samych krawędzi brył) po gotowy obraz z oświetleniem.
Scena to biurko z kilkoma przedmiotami (książki, kubek z kawą, jabłko, ołówek), obraz na ścianie i piłka, która odbija się dziewięć razy, a potem zatrzymuje przed kubkiem (jej ruch model wyliczył w prostej symulacji fizyki). Tak jak poprzednio pracowałem z Claude Code, tym razem z modelem Claude Opus 5.5, który zbudował scenę w otwartym Blenderze przez serwer MCP (dodatek, przez który model może sterować programem). Potem każdą z 336 klatek 14-sekundowego ujęcia wyrenderował w tle (czyli zamienił w gotowy obraz) pięć razy, za każdym razem w innym stylu: siatka, rysunek ołówkiem, glina (jakby wszystko było ulepione z gliny), tekstury i tekstury z oświetleniem. Na koniec skrypt połączył pięć wersji w jeden film, w którym jeden styl przechodzi w drugi, a ponieważ kamera, ruch i przedmioty są w każdej z nich takie same, kontury po obu stronach granicy płynnie przechodzą jedne w drugie.
Najciekawsze były dla mnie błędy, które model wychwycił sam, sprawdzając swoją pracę, zanim cokolwiek mi pokazał. Już w krótszym teście, od którego zacząłem, linie w stylu ołówkowym miały się zmieniać co drugą klatkę (tak jak w animacji rysowanej ręcznie), a pomiar pokazał, że zmieniają się w każdej, bo ruch i drżenie kreski (celowe nierówności, jak w rysunku odręcznym) były przesunięte względem siebie o jedną klatkę. Na próbnych klatkach filmu zauważył, że z kadru zniknęła ściana, a szukając przyczyny, znalazł też za nisko ustawiony blat, nad którym przedmioty lekko wisiały (położenie obu elementów zostało uwzględnione dwukrotnie). Przy pierwszym renderowaniu całego filmu jeden z pięciu stylów w ogóle nie powstał, bo Blender przy zapisie pliku usunął materiał (opis wyglądu powierzchni), który akurat nie był nigdzie użyty.
Moja rola sprowadzała się do pomysłu i oceny: wymyśliłem, w jakich stylach i w jakiej kolejności ma się pokazać scena, a po obejrzeniu pierwszego filmu poprosiłem, żeby przedmioty wyglądały mniej schematycznie (kubek dostał zaokrąglony brzeg i kawę w środku, książki okładki z grzbietem, a ołówek zatemperowaną końcówkę i gumkę). Pierwszy film był gotowy 19 minut po tym, jak opisałem pomysł (wliczając renderowanie), a wersję z poprawkami model przygotował rano w 16 minut od mojej prośby.
Film nie jest jeszcze skończony (światło jest dość płaskie, a piłka to wciąż zwykła kula w dwóch kolorach), więc będę go dalej poprawiał. Ciekawi mnie, jak daleko można w ten sposób zajść, zanim potrzebny będzie ktoś, kto naprawdę zna Blendera 🙂
Blendera wcześniej w ogóle nie używałem, więc nakładkę na filtr do telefonu zaprojektował model, a ja ją drukowałem i przymierzałem. Do działającej części wystarczyły trzy wydruki, a najciekawsze okazało się to, co zostało po błędach modelu... https://t.co/iPo32RrDgT
Dzięki! Tak, Jeva sprawdzałem na tych samych 145 produktach przy okazji Clefa (wyniki w tym wpisie: https://t.co/3fCwybJnn8). Też przypisał poprawnie 136, czyli tyle samo co basal 1.5, a w 132 przypadkach oba trafiły. Różnica jest w pewności: przy progu 0,9 (wybranym przeze mnie) Jev przyjąłby automatycznie 126 odpowiedzi bez pomyłki, a basal 1.5 92 z jedną pomyłką. Tylko że Jev działa w chmurze, a basal lokalnie, u mnie w ok. 70 ms na zapytanie 🙂
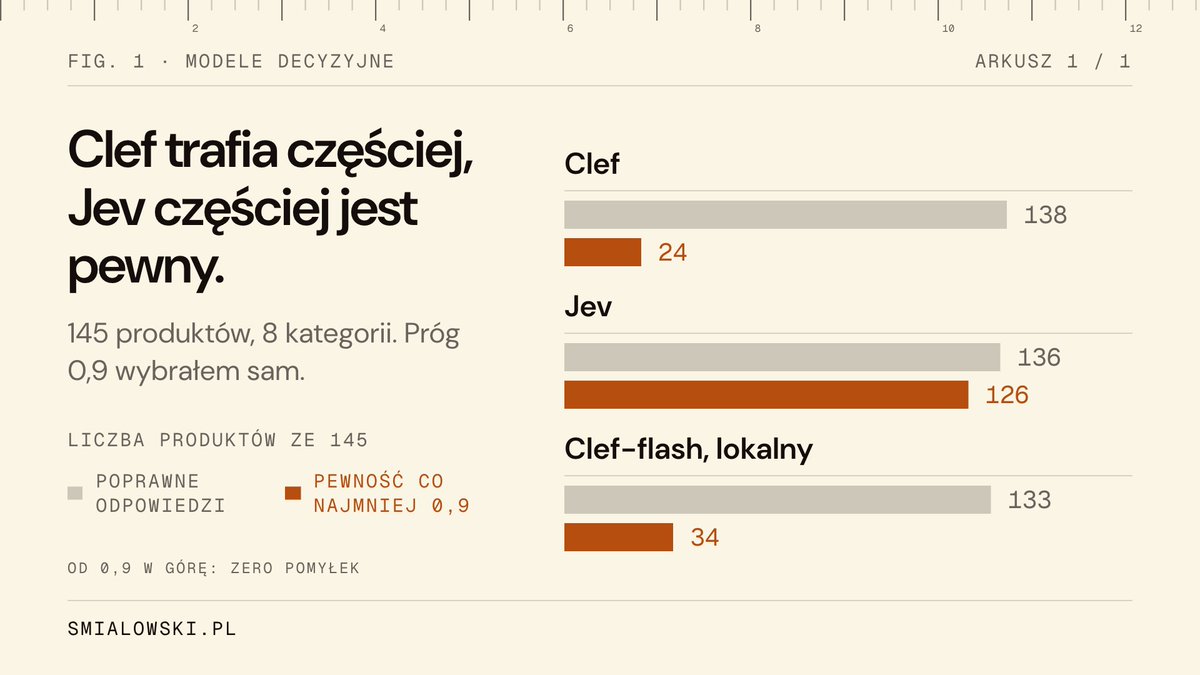
Cloudflare udostępnił Clef, otwarty model decyzyjny, który według ich testów wypada lepiej niż Jev od @typesafeai, więc sprawdziłem oba na 145 produktach spożywczych z mojego testu basala. Clef poprawnie przypisał 138, a Jev 136, ale do automatyzacji bardziej przekonał mnie Jev.
Clef (27 mld parametrów, oparty na modelu Qwen3.8-27B) i mniejszy Clef-flash (9 mld parametrów) są na licencji Apache 2.0 i działają podobnie jak Jev: nie piszą tekstu, tylko wybierają jedną z odpowiedzi podanych w zapytaniu i zwracają, na ile są jej pewne (jako liczbę od 0 do 1). Clefa i Jeva uruchamiałem w chmurze Cloudflare (w usłudze Workers AI), a oba modele dostawały dla każdego produktu dokładnie to samo zapytanie (przy drugim przebiegu Clef dał identyczne odpowiedzi).
Różnicę widać w pewności, którą zwracają. Gdybym automatycznie akceptował tylko odpowiedzi z pewnością co najmniej 0,9 (ten próg wybrałem sam), przeszłoby 126 odpowiedzi Jeva, bez ani jednej pomyłki (jego błędne odpowiedzi miały pewność najwyżej 0,88). Clef zwracał u mnie znacznie niższą pewność niż Jev, więc przy tym samym progu przeszłyby tylko 24 jego odpowiedzi (też bez pomyłki, a jego błędne odpowiedzi miały pewność najwyżej 0,81), a do ręcznej weryfikacji trafiłoby 121 produktów, choć w 114 z nich Clef miał rację.
Mniejszego Clef-flash uruchomiłem u siebie, na jednym komputerze ASUS Ascent GX10 (układ NVIDIA GB10). Poprawnie przypisał 133 produkty i potrzebował ok. 143 ms na jeden, czyli mniej więcej dwa razy dłużej niż basal (ok. 70 ms i od 131 do 133 poprawnych odpowiedzi, zależnie od przebiegu), przy czym basal jest o połowę mniejszy i działał u mnie w mocniej skompresowanej wersji (z wagami modelu zapisanymi na 8 bitach, a Clef-flash na 16), więc to nie jest porównanie jeden do jednego.
Moim zdaniem wybór zależy od zastosowania. Jeśli liczy się sama trafność, a wyniki i tak ktoś sprawdza, u mnie nieco lepiej wypadł Clef. Jeśli model ma samodzielnie podejmować część decyzji, ważniejsze jest to, ile odpowiedzi da się zaakceptować automatycznie bez pomyłek, i tu na moich danych wyraźnie lepiej wypadł Jev (podobnie jak basal: przy progu wyznaczonym przez jego autora przeszłoby 85 odpowiedzi, bez ani jednej pomyłki). To wciąż tylko 145 polskich produktów i jeden zestaw kategorii, więc na innych danych wyniki mogą wyglądać inaczej.
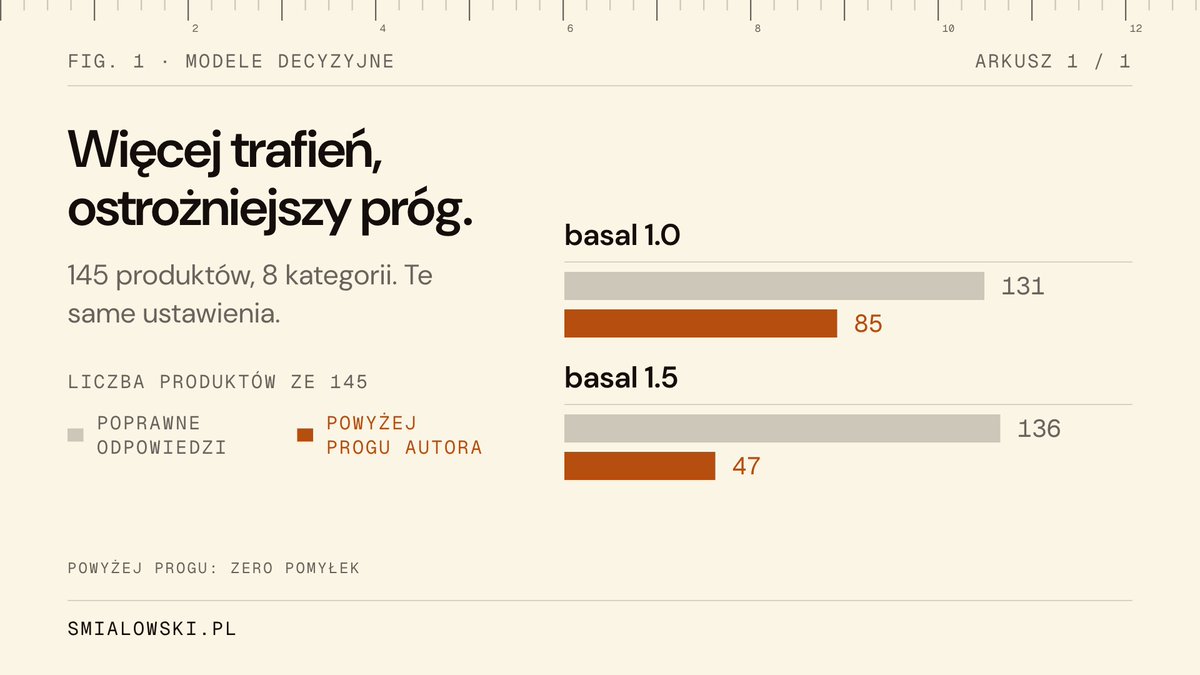
W piątek napisałem, że jak tylko basal 1.5 od Remka (@KinasRemek) wyjdzie, sprawdzę go na tych samych 145 produktach i dam znać, jak sobie poradził, więc daję znać: nowa wersja przypisała do właściwej kategorii 136 z nich, czyli o pięć więcej niż 1.0 w moim pierwszym teście.
W porównaniu z tamtym testem nie pomyliła się przy żadnym produkcie, przy którym 1.0 miała rację, a przypisała poprawnie między innymi pastę jajeczną (1.0 uznała ją za przekąskę) i gotowe danie z roladkami wołowymi i kaszą pęczak (1.0 zaliczyła je do mięsa). Nadal myli się przy gotowym daniu z kaszą bulgur i kurczakiem (uznaje je za produkt ze spiżarni), a z ośmiu pozostałych pomyłek siedem to przypadki graniczne (np. groszek konserwowy albo napój jogurtowy). Po ponownym uruchomieniu modelu poprawnych odpowiedzi było 137 (w 1.0 wynik też zmieniał się po każdym uruchomieniu o jeden lub dwa produkty, od 131 do 133).
Najciekawszy okazał się dla mnie próg pewności. Autor wyznaczył dla 1.5 wyższy próg (0,96 zamiast 0,91; w obu wersjach z myślą o około 1% błędów, ale w 1.5 z większym zapasem), więc na moich danych automatycznie można by przyjąć tylko 47 odpowiedzi zamiast 85 (znów bez ani jednej pomyłki). Do ręcznej weryfikacji trafiłoby 98 produktów, choć w 89 z nich nowa wersja miała rację.
Odpowiedź na jedno zapytanie zajmowała u mnie tyle samo czasu co w 1.0 (około 70 ms na tym samym komputerze ASUS Ascent GX10 i przy tych samych ustawieniach). Jeśli dobrze rozumiem opis na GitHubie, przyspieszenie w 1.5 dotyczy zapytań, w których model odpowiada naraz na kilka pytań o tę samą rzecz, a w moim teście każde zapytanie zawierało jedno pytanie.
Poza podstawową wersją (4,5 mld parametrów) sprawdziłem też dwa pozostałe modele z tej rodziny. Największy, basal-1.5-max (11 mld parametrów), przypisał poprawnie 135 produktów (około 134 ms na zapytanie), ale powyżej swojego progu pomylił się trzy razy, i to z dużą pewnością, za każdym razem w przypadku granicznym (groszek konserwowy i oba napoje jogurtowe). Najmniejszy (1,5 mld parametrów) przypisał poprawnie 122 produkty (około 31 ms na zapytanie).
Na moich danych 1.5 częściej wybiera właściwą kategorię, a wyższy próg oznacza moim zdaniem po prostu więcej pracy dla kolejnego etapu weryfikacji (innego modelu albo człowieka). To wciąż tylko 145 polskich produktów i jeden zestaw kategorii, więc na innych danych wyniki mogą wyglądać inaczej.
basal-1.5 - zapraszam - github i HF zaktualizowane i otwarte.
Trzy modele:
- basal-1.5-max (11B)
- basal-1.5 (4.5B)
- basal-1.5-nano (1.5B)
- benchmark - Werdykt
pierwszy polski 🇵🇱 klasyfikator typu system-one, z rozszerzoną listą instrukcji, SGLang i vLLM, Apple Silicon (MLX 8-bit i 4-bit) oraz Ollama i llama.cpp (GGUF), Apache 2.0, optymalizowany pod pracę z tekstami w języku polskim
mam prośbę 🙏 - jeśli korzystasz, testujesz podziel się tą informacją niech leci w świat (narzekamy, że w Polsce mało dzieje się w AI a jak się dzieje to przechodzimy nad tym do porządku dziennego). Dla mnie największą nagrodą będzie to, że model przynosi korzyści dla użytkowników. Moim zdaniem w wielu firmach basal może przynieść znaczne oszczędności przez inteligentną, tanią, zamkniętą (dane nie wychodzą na zewnątrz) automatyzację procesów.
Każda informacja zwrotna pozwoli udoskonalić basal w wersji 2.0.
Zapraszam do wpisywanie się w księgę użytkowników. Wersję 2.0 otrzymacie (użytkownicy) tydzień, a może nawet dwa przed premierą do testów!
Linki w kolejnym wpisie.
Sporo rzeczy nauczyłem się z filmów na YouTube, więc zbudowałem proces, który robi to samo dla moich agentów: „ogląda” filmy i zapisuje z nich zasady. Najwięcej pracy wymagało sprawdzenie, czy w filmie naprawdę pada to, co z niego wyciągnięto... https://t.co/LzzltnHuJ1
Nie testowałem żadnego, ale z opisów wynika, że celują w inny sprzęt niż mój. Magnitude działa na jednym komputerze i nie ma modeli GLM na liście, a Pulsar doczytuje części modelu z dysku, żeby duże modele MoE działały na kartach z 16 GB. U mnie GLM 5.3 Flash mieści się w pamięci dwóch GX10, więc to nie mój przypadek.
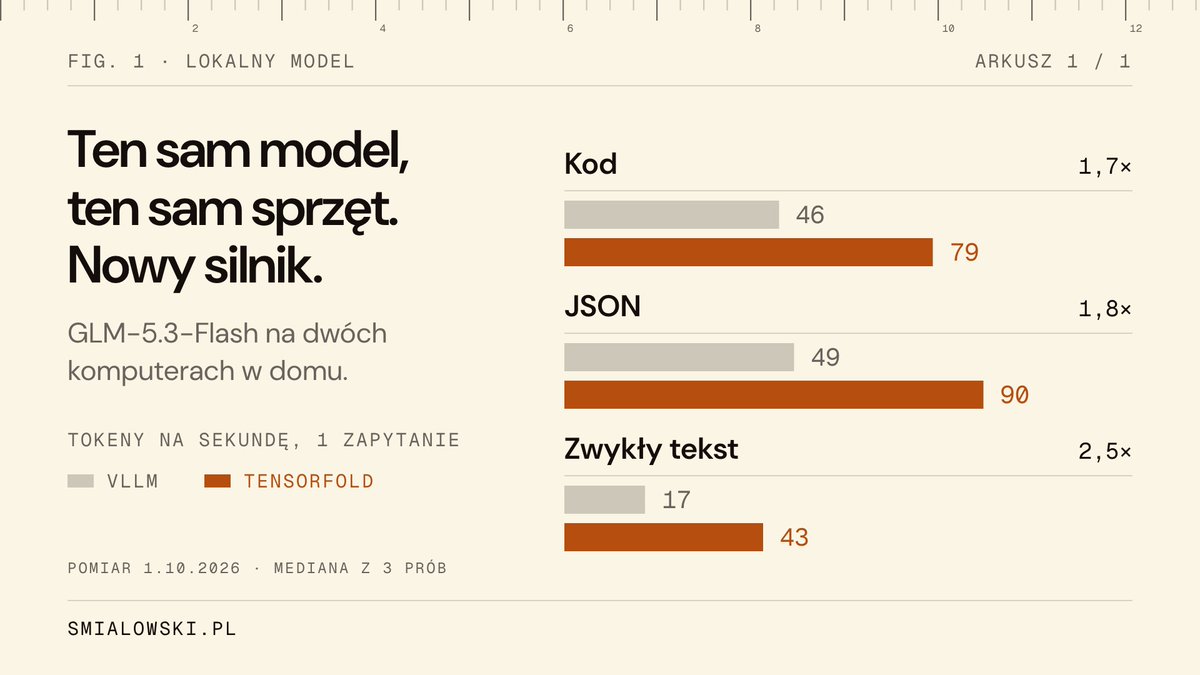
Dziś wymieniłem oprogramowanie, które uruchamia mój lokalny model (GLM 5.3 Flash na dwóch komputerach w domu): te same pliki modelu, ten sam sprzęt, a odpowiedzi generują się teraz od 1,7 do 2,5 raza szybciej.
W miejsce vLLM wszedł TensorFold (projekt @ashxhart), skonfigurowany według gotowego przepisu od @MiaAI_lab (52 zmiany w kodzie przygotowane specjalnie dla tego modelu i tych komputerów). Oba programy porównałem na tych samych zapytaniach (odpowiedź o długości 400 tokenów, mediana z trzech prób): przy kodzie 46 → 79 tokenów (fragmentów słów) na sekundę, przy danych w formacie JSON 49 → 90, a przy zwykłym tekście 17 → 43. Przy czterech zapytaniach obsługiwanych jednocześnie powstaje łącznie od 2 do 3,4 raza więcej tokenów na sekundę (to wynik tylko dwóch prób, a moje aplikacje i tak wysyłają na razie zapytania po jednym), a okno kontekstowe (czyli ile tekstu model może wziąć pod uwagę naraz) zwiększyło się u mnie z 850 tys. do ok. 1 mln tokenów.
Jedno zastrzeżenie: TensorFold domyślnie mocniej kompresuje część wag modelu (do 4 bitów) i z tego bierze się część przyspieszenia, a choć w opisie przepisu są dobre wyniki testów jakości, sam jakości odpowiedzi jeszcze nie porównałem.
To moim zdaniem dobra wiadomość dla każdego, kto rozważa uruchomienie modelu na własnym sprzęcie: wydajność w dniu zakupu nie musi być górną granicą, bo oprogramowanie do uruchamiania otwartych modeli wciąż szybko się rozwija (u mnie ten sam model na tych samych komputerach działa szybciej, a niczego nie dokupiłem).
@Ludwik256@typesafeai Tak, zanim sprawdziłem Clefa i Jeva, testowałem na tych samych 145 produktach basala, polski model oparty na Bieliku (jego wyniki są w tym wpisie i w dwóch wcześniejszych na moim profilu).
Cloudflare udostępnił Clef, otwarty model decyzyjny, który według ich testów wypada lepiej niż Jev od @typesafeai, więc sprawdziłem oba na 145 produktach spożywczych z mojego testu basala. Clef poprawnie przypisał 138, a Jev 136, ale do automatyzacji bardziej przekonał mnie Jev.
Clef (27 mld parametrów, oparty na modelu Qwen3.8-27B) i mniejszy Clef-flash (9 mld parametrów) są na licencji Apache 2.0 i działają podobnie jak Jev: nie piszą tekstu, tylko wybierają jedną z odpowiedzi podanych w zapytaniu i zwracają, na ile są jej pewne (jako liczbę od 0 do 1). Clefa i Jeva uruchamiałem w chmurze Cloudflare (w usłudze Workers AI), a oba modele dostawały dla każdego produktu dokładnie to samo zapytanie (przy drugim przebiegu Clef dał identyczne odpowiedzi).
Różnicę widać w pewności, którą zwracają. Gdybym automatycznie akceptował tylko odpowiedzi z pewnością co najmniej 0,9 (ten próg wybrałem sam), przeszłoby 126 odpowiedzi Jeva, bez ani jednej pomyłki (jego błędne odpowiedzi miały pewność najwyżej 0,88). Clef zwracał u mnie znacznie niższą pewność niż Jev, więc przy tym samym progu przeszłyby tylko 24 jego odpowiedzi (też bez pomyłki, a jego błędne odpowiedzi miały pewność najwyżej 0,81), a do ręcznej weryfikacji trafiłoby 121 produktów, choć w 114 z nich Clef miał rację.
Mniejszego Clef-flash uruchomiłem u siebie, na jednym komputerze ASUS Ascent GX10 (układ NVIDIA GB10). Poprawnie przypisał 133 produkty i potrzebował ok. 143 ms na jeden, czyli mniej więcej dwa razy dłużej niż basal (ok. 70 ms i od 131 do 133 poprawnych odpowiedzi, zależnie od przebiegu), przy czym basal jest o połowę mniejszy i działał u mnie w mocniej skompresowanej wersji (z wagami modelu zapisanymi na 8 bitach, a Clef-flash na 16), więc to nie jest porównanie jeden do jednego.
Moim zdaniem wybór zależy od zastosowania. Jeśli liczy się sama trafność, a wyniki i tak ktoś sprawdza, u mnie nieco lepiej wypadł Clef. Jeśli model ma samodzielnie podejmować część decyzji, ważniejsze jest to, ile odpowiedzi da się zaakceptować automatycznie bez pomyłek, i tu na moich danych wyraźnie lepiej wypadł Jev (podobnie jak basal: przy progu wyznaczonym przez jego autora przeszłoby 85 odpowiedzi, bez ani jednej pomyłki). To wciąż tylko 145 polskich produktów i jeden zestaw kategorii, więc na innych danych wyniki mogą wyglądać inaczej.
We are introducing Clef and Clef-flash, open-source decision models hosted on Workers AI for high-speed classification and agentic workflows. https://t.co/eilE3tV0F2 #BirthdayWeek
Blendera wcześniej w ogóle nie używałem, więc nakładkę na filtr do telefonu zaprojektował model, a ja ją drukowałem i przymierzałem. Do działającej części wystarczyły trzy wydruki, a najciekawsze okazało się to, co zostało po błędach modelu... https://t.co/iPo32RrDgT
W moim teście to akurat nie miało znaczenia, bo żadne zapytanie nie przekroczyło 700 tokenów (nazwa produktu, marka i opisy ośmiu kategorii do wyboru), ale przy długich dokumentach ta różnica może faktycznie mieć znaczenie - sprawdziłbym wtedy, jaką pewność Clef zwraca na Twoich danych, bo u mnie była wyraźnie niższa niż u Jeva (przy progu 0,9 zaakceptowałbym automatycznie 24 odpowiedzi Clefa ze 145, a Jeva 126). Daj znać, jak Ci wyjdzie 🙂
@Here_We_Go111@budujAgentaAI A jaki to sprzęt? Jeśli RTX PRO 6000, to @MiaAI_lab ma gotowy przepis na Qwen3.8-27B: ok. 24 GB wag w NVFP4, cały kontekst 256k i sporo miejsca na pamięć podręczną.
Pod moim wpisem o teście basala @budujAgentaAI zapytał, co z tymi 60 produktami, przy których model nie był pewny. Odpowiedziałem wtedy, jak mogłoby to wyglądać w teorii, a teraz z ciekawości sprawdziłem, jak wypadłby lokalny GLM 5.3 Flash jako drugi etap weryfikacji.
basal szybko załatwia to, czego jest pewny (85 produktów, bez ani jednej pomyłki), a do GLM trafiają tylko trudniejsze przypadki. Przy tych 60 produktach GLM 44 razy potwierdził odpowiedź basala, 7 razy ją poprawił, a 9 razy się pomylił (6 razy tak samo jak basal). Razem z 85 odpowiedziami basala daje to 136 ze 145, czyli dokładnie te same odpowiedzi, jakie dał sam GLM na wszystkich 145 produktach, tylko w 55 s zamiast 97 s.
Jedno zastrzeżenie: nie uruchamiałem tych modeli razem na żywo, tylko złożyłem wynik z dwóch przebiegów. GLM też dostał wszystkie 145 produktów (bo do porównania potrzebowałem jego wyniku na całości), a do połączenia z basalem wziąłem z tego przebiegu tylko jego odpowiedzi i czasy dla 60 niepewnych przypadków. Zapytania szły jedno po drugim, GLM działał bez trybu myślenia, a na filmie odtworzyłem to z prawdziwymi czasami (fragment z GLM jest przyspieszony trzy razy).
Moim zdaniem takie połączenie (mały model klasyfikacyjny plus większy model do dodatkowej weryfikacji) to jedno z możliwych rozwiązań do automatyzacji w domu czy w firmie (np. przy przypisywaniu kategorii zgłoszeniom albo dokumentom). Jeśli oba modele działają lokalnie, dane nie muszą opuszczać domu ani firmy. W zależności od tego, ile kosztuje pomyłka, proces może się zakończyć na drugim modelu albo mieć jeszcze jeden etap (np. ręczny przegląd, skrypt albo sprawdzanie wyników według stałych reguł), ale... to już temat na dłuższy artykuł albo na rozmowę przy kawie.
Remek (@KinasRemek) pracuje już nad basalem 1.5, więc jak tylko wyjdzie, sprawdzę go na tych samych produktach i dam znać, jak sobie poradził 🙂
basal-1.5 w trakcie. Zebrałem mnóstwo uwag, przemyśleń, również danych. Kolejne wieczory zapowiadają się na robieniu jeszcze lepszego modelu dynamicznego klasyfikatora. Roadmapa zaplanowana do wersji 2.5 (wcale nie żartuję).
Na stronie basal_si5_pl znajdziecie sekcję "Mały model. Prawdziwe historie". To zgłoszenia osób, które używają pierwszej wersji modelu. Wersja 1.5 w pierwszej kolejności udostępnię właśnie tym osobom, firmom. To bonus za pozostawienie Prawdziwej historii. Zachęcam Was do dzieleniem się swoimi przypadkami - każdego słucham i usprawniam. Możesz mieć wpływ na pierwszy polski 🇵🇱 dynamiczny klasyfikator.
@Here_We_Go111@budujAgentaAI Tak, 320 mld parametrów: w 4 bitach to ok. 176 GB wag, więc u mnie działa na dwóch ASUS Ascent GX10 (układ NVIDIA GB10). Są wersje na jeden (ok. 2,3 bita, ~96 GB), ale ich jakości jeszcze nie sprawdzałem.
@budujAgentaAI Bez trybu myślenia 42,3 s na wszystkie 60, czyli ok. 0,7 s na produkt. Z włączonym myśleniem ok. 5,5 minuty (średnio 5,6 s na produkt), za to z 3 trafieniami więcej. Zapytania szły jeden po drugim.
@budujAgentaAI@KinasRemek W docelowym systemie te 60 produktów trafiałoby do dodatkowej weryfikacji: najpewniej ręcznej, ale mógłby je też sprawdzać np. większy model językowy.
Sprawdziłem u siebie basal, nowy polski model od @KinasRemek, na 145 produktach spożywczych: do właściwej kategorii przypisał 131 z nich, a w 85 przypadkach, w których jego pewność przekraczała próg wyznaczony przez autora, nie pomylił się ani razu.
basal to mały, otwarty model (4,5 mld parametrów, oparty na Bieliku od SpeakLeash, na licencji Apache 2.0), który nie pisze tekstu, tylko wybiera jedną z odpowiedzi podanych w zapytaniu i określa, na ile jest jej pewny (podaje prawdopodobieństwo dla każdej z nich). Odpowiedzi opisuje się zwykłym tekstem w samym zapytaniu (u mnie było to osiem kategorii, np. „nabiał i jaja”, „przekąski”, „dania gotowe” i „żadna z powyższych”), więc żeby je zmienić, nie trzeba dotrenowywać modelu.
Model dostawał tylko nazwę produktu i markę, a odpowiedź na jedno zapytanie zajmowała u mnie po stronie serwera około 70 ms (autor podaje 45 ms na komputerze z takim samym układem, tyle że zmierzył je w innym teście, więc to nie jest porównanie jeden do jednego), dzięki czemu wszystkie 145 produktów model przypisał do kategorii w kilkanaście sekund.
Najciekawsze okazały się dla mnie pomyłki. Część to błędy modelu (np. pastę jajeczną uznał za przekąskę, a gotowe danie z kaszą bulgur i kurczakiem za produkt ze spiżarni), część to przypadki graniczne (np. napój jogurtowy, który można uznać za nabiał albo za napój), ale dwie były moje: herbatniki z białą czekoladą i bułeczki cynamonowe miałem przypisane do niewłaściwej kategorii, a model wskazał właściwą (wynik 131 liczę już po tej poprawce).
Moim zdaniem najbardziej przydatna jest tu pewność, którą model zwraca: odpowiedzi z wysoką pewnością można akceptować automatycznie, a resztę przekazywać do ręcznej weryfikacji (przy progu autora, ustalonym jeszcze przed jego testami z myślą o około 1% błędów, do weryfikacji trafiłoby u mnie 60 produktów, choć w 46 z nich model miał rację). A ponieważ model można uruchomić na własnym sprzęcie, dane nie muszą opuszczać domowej czy firmowej sieci.
Strona modelu basal 🇵🇱 wystartowała. Zapraszam. Będzie aktualizowana o nowe przypadki użycia, nowych partnerów, którzy używają w swoich aplikacjach (proszę o zgłaszanie przypadków użycia). Oprócz tego parametry modeli, aktualizacje, aktualności (w postaci krótkich wpisów co się dzieje). Tworzymy polski model dynamicznego klasyfikatora.
@nephrenn@KinasRemek Wcześniej testowałem Jeva i działał świetnie, ale korzysta się z niego przez API, więc dane i tak wychodzą na zewnątrz. Basal można uruchomić na własnym sprzęcie i wtedy wszystko zostaje lokalnie, co przy danych z HR ma duże znaczenie.
@swcraftman@KinasRemek U mnie ASUS Ascent GX10 (układ NVIDIA GB10), model uruchomiony w trybie fp8. Autor podaje 45 ms dla DGX Spark, który ma ten sam układ.