Home
Language
English
Türkçe
Bahasa Indonesia
About
Privacy Policy
Terms of Service
Pricing
Sign In
Download All
Share
吃毛巾卷吗
@uubbccgg
Iceland
Joined August 2018
621
Following
39
Followers
59
Posts
uubbccgg
retweeted
科技混子Chris
@ChrisSlacker
29 days ago
ChatGPT有个隐藏模式叫'无限私教',能在3小时内从零教会你任何技能。 这是8个超实用的提示词。
uubbccgg
retweeted
lidang 立党 (劝人卖房/学CS/买SP500/纳100/OpenAI/Anthrop第一人)
@lidangzzz
5 months ago
半年来,我一直反复介绍的四个原则: 原则1,AI时代的第一性原理:LLM一定会越来越聪明,benchmark越来越高,context window越来越大,reasoning越来越长,价格越来越便宜,inference速度越来越快, 这是scaling law今天依然持续的具体方向,不用你质疑,这是你唯一的信仰和行业最大共识。 原则2, 管理学设计红利:从我提出“自动编程机”、行业提出vibe coding、SWE-Agent以来,从cursor到manus到metaGPT到claude code, 人们逐渐把LLM Agent抽象成人,把软件管理、工程管理、管理学等等所有方法论直接套在multi agent workflow上面,严格按照人类管理学的方式去拆分、review、执行、反馈、循环, 这一波很快红利也吃完了,因为 a. LLM Agent毕竟不是人,存在着memory有限、执行力有限、function calling工具有限等等局限;b. 人类用于管理学的各种方法,直接套在LLM Agent上有利有弊,红利迅速挖掘完,剩下的弊端大量存在,比如过度交流、七手八脚、随时停工等等。 原则3,LLM Agent的职位和定位:绝大多数人,把claude code当做一个工具,最终的产品是用工具来完成的,最终的代码也是人与SWE Agent一步一步interactively迭代产生、迭代review、迭代部署的, 而我反复告诉过所有人,也是我又一条首次提出的原创观点,multi agent未来越来越会变成本身的一个runtime,这个runtime就运行在production里面,产品和面向的对象消费的,不只是软件或者SaaS本身,而是这个runtime实时产生的内容, 所以claude code/opencode/codex/openclaw这些agent,本身将会越来越多地被嵌入到产品本身,在产品关键逻辑和决策中发挥作用, 而绝对不仅仅停留在开发层面,把产品仅仅局限在SWE Agent单向产出和部署的代码和服务上。 原则4,也是我一直强调的,就是当人们试用了SWE Agent这种强大工具之后,人们还有哪些low hanging fruits可以寻找?SWE Agent目前最适合解决哪类问题? 我反复讲过的一点是,对于一个设计复杂、环境复杂、场景复杂、用户复杂、体量复杂、范式复杂、一切开放、一切无解的超级复杂系统,这并不是SWE Agent最擅长的领域,相反这些场景需要人去和环境、客户、场景、性能一点点迭代才能打磨好的产品, 比如微信的100种功能,Facebook的一大堆功能模块和十几年来迭代出来的极其复杂的infra,支付宝后面成千上万的基金和风控,这些都不是AI Agent能一次性解决的问题,相反这些场景和问题不仅高度开放,更高度依赖人的观察、人的设计、人的反馈、人的定义。 AI Agent最适合的场景,甚至是我原创提出goal driven(https://t.co/mJld9Xd98X)设计的最适合场景,在不考虑token使用量和时长的条件下(参照第一性原理,这些成本必然会越来越低),必然同时具有如下特点: a. 定义简单、干净、封闭(一道数学系、一个确定性最小系统、一个编译器、一种算法、一个lean证明、一个电路或者信号模拟、蛋白质模拟和预测、CAD设计与仿真、游戏关卡测试、行为经济学仿真,都是well-defined problems,都有非常明确且封闭的边界) b. 解决问题的搜索空间巨大(可能有100~10万种天马行空的解决方案,并且绝大多数都是错的) c. 容易验证,容易verify,验证的成本是设计成本的千分之一(比如编译器,设计可能需要几万行甚至几十万行,验证只需要2000个test case全面覆盖,或者一道数学题,解决需要100步,验证答案只需要带入或者lean编译这一步) 当然,写一段简单的代码,定义一个封闭、完整、定义完全的编程问题,符合上面这些定义, 但是设计一套巨大、复杂、开放、与现实世界深度绑定、高度耦合的系统,让这个系统复杂迭代、添加功能、沟通、review、工程管理、产品管理,这些问题都远远超出这个范畴,很明显是不符合这个要求的。 人们未来探索这些multi agent产品和场景的最关键出路,在于继续挖掘这一类问题,而不是盲目把agent比作一个人,乱套各种管理学方法。 原则5,这一点我先保密,之后我再讲。
See More
uubbccgg
retweeted
木子不写代码
@ai_muzi
5 months ago
爆肝制作,全网最细最全的 Claude Code 零基础系统教程!👇👇 这一期跟完,保证你成为Claude Code高手!: 1️⃣ 基础入门:安装、第三方模型接入、权限系统。 2️⃣ 核心进阶:Tools、Hooks、Skills、Subagents 及自动化流程。 3️⃣ 项目实战:用以上所学知识构建一个AI 网页 App。 全程精剪没有废话,每个功能都讲透+实操! 时间戳: 0:00 开场 00:38 1.安装 04:04 2.换模型 06:08 3.终端界面介绍 11:04 4.图形界面介绍 15:05 5.权限系统 19:45 https://t.co/XyY1LSL6Us 23:02 7.Hooks 26:34 8.Skills 31:47 9.插件 34:33 10.Subagent 40:33 11.自动化 41:58 12.构建网页APP 49:32 13.CLAUDE.md 52:02 总结
See More
ai_muzi's tweet video.
uubbccgg
retweeted
歸藏(guizang.ai)
@op7418
5 months ago
做了个非常牛逼的网页 PPT Skills,明天发 彻底解决你的 PPT 生成难题 昨天分享的内容不知道怎么样,反正很多朋友看上了我的 PPT,索性做个 Skills,明天开源一下
Who to follow
Bettina
@Bettina86598730
我最自由
@ziho50133266
为什么打不起精神
jahangir
@priceaction113
!!!سب فنا ، دوام فقط لا !!!!!
uubbccgg
retweeted
老金
@freeman1266
5 months ago
面试 AI Coding,我最喜欢的一条面试题: 什么样的prompt 算得上优秀的prompt ?
uubbccgg
retweeted
李老师不是你老师
@whyyoutouzhele
6 months ago
近日,github上一个名叫“同事.skill”的项目火了。 4月3日,一博主表示,她开发了“反蒸馏skill”的项目。 她表示,大家都是出来做牛马的,没人希望自己被做成skill,然后丢掉工作,所以自己发明了“反蒸馏skill”。希望大家在这个AI浪潮里都能活得久一点吧。
whyyoutouzhele's tweet video.
吃毛巾卷吗
@uubbccgg
over 2 years ago
@yunseulk
感谢🥹
uubbccgg
retweeted
知识分享官
@knowledgefxg
over 2 years ago
偶遇了一个蛮用心的Python数据分析教程 这是本开源书籍,书名《交互的Python:数据分析入门》,本书主要面向的是没有编程基础和数据处理分析经验的读者,也可以作为数据分析相关方向职业技术人员/学生作为参考和学习使用。 文档教程:https://t.co/tywZ1Td805 GitHub: https://t.co/tatlbqU8qO
uubbccgg
retweeted
知识分享官
@knowledgefxg
over 2 years ago
给孩子解释下什么是RSS⬇️
#RSS
uubbccgg
retweeted
量價為王
@toppy20241025
over 2 years ago
@tingyun97
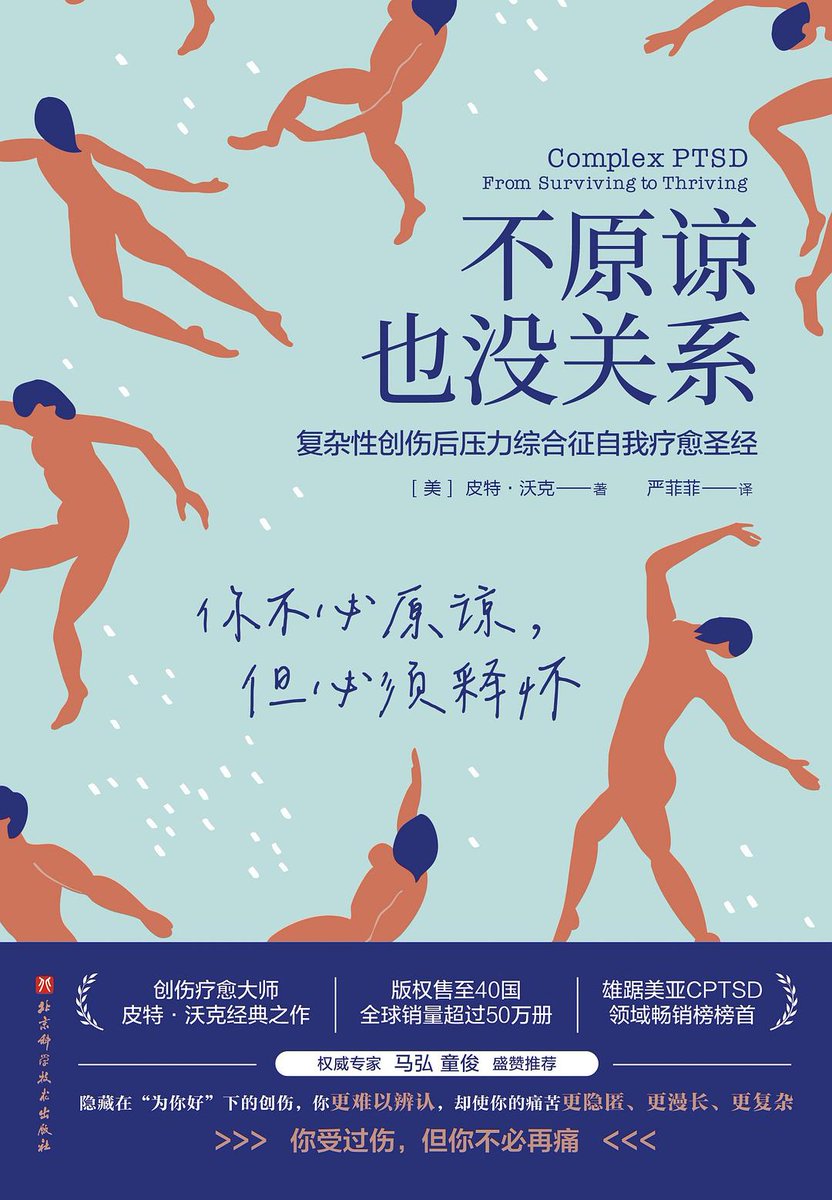
「不原谅也没关系.pdf」 链接:https://t.co/6YTM0YVaXf 「被讨厌的勇气.epub」 链接:https://t.co/aqltfe6e5c 「乌合之众.epub」 链接:https://t.co/vEQBZ2xXPI
uubbccgg
retweeted
howie.serious
@howie_serious
over 2 years ago
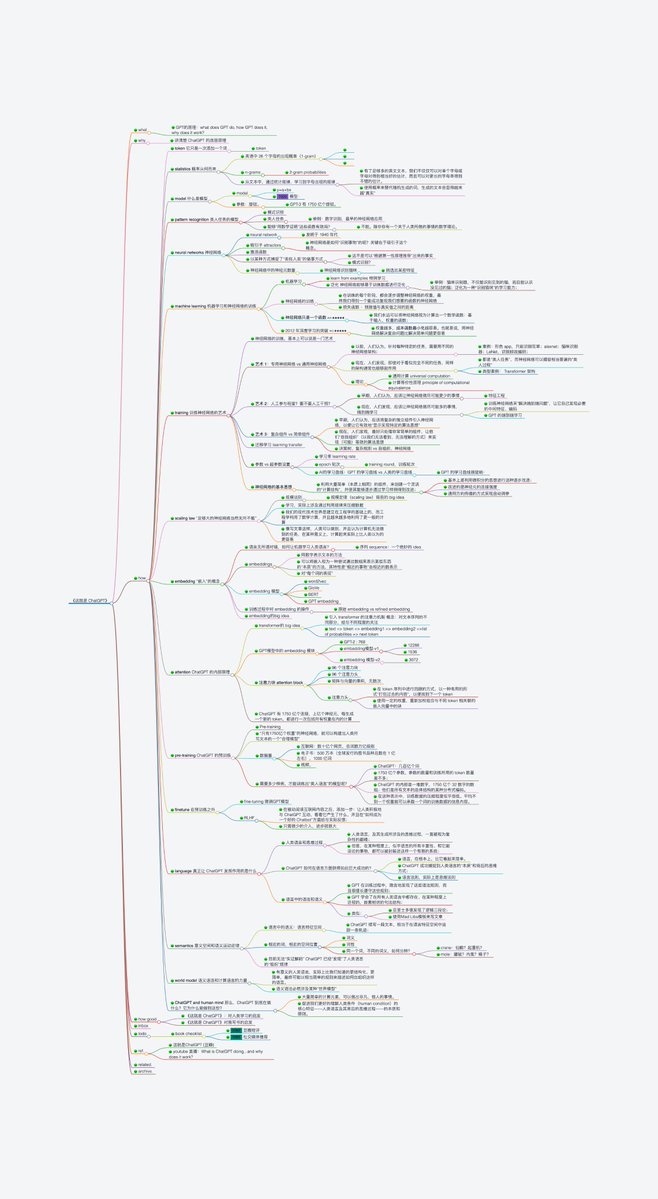
如何使用 ChatGPT 原理学会一切知识?读Wolfram 大神的神书《这就是 ChatGPT》之后的读书笔记 读了李沐大神的《使用随机梯度下降来优化人生》,忍不住拍大腿。加上前面推荐了wolfram 大神的神书《这就是 ChatGPT》,于是觉得有必要写点类似读书笔记或书评的东西。李沐的文章写于ChatGPT 之前,是结合随机梯度下降来讲人生道理的,我这篇准备从ChatGPT 原理出发,聊一聊 GPT对人类学习、构建个人知识体系的启发。以此文致敬两位大神。🫡 李沐的文章微言大义,只用了 1100 字。我对GPT原理的认识有限,所以写了5000字,请大家多多指正。 1 首先要有目标 所有机器学习,一定得有个目标函数。人类的学习也是如此,学习之前,目标先行。 目标函数,也叫成本函数,损失函数。**模型训练的目标就是让损失函数最小化**。人类学习,也是要不断接近自己的学习目标。 2 学习目标要大 GPT模型的训练目标,是用一个巨大的神经网络去模拟互联网上的所有人类语言文本,让损失函数最小化。目标基本达成,**GPT把基本上全部的人类知识压缩进了万亿参数的单一模型**,实现了通用认知任务上的卓越表现。 GPT的学习目标不可谓不大。 人类学习也是如此。目标不能太小,你的学习不是为了通过某次考试,取得某个分数。在我看来,人的学习应当以构建个人知识体系为学习目标。 在你在外,人类知识体系(body of knowledge)是一种客观存在,wikipedia 和书籍等都是对人类知识体系的一种整理和构建的实践,我称之为bok1。在你之内,你的脑子里应该有一个自己的个人知识体系,关于一个或多个学科或领域,我称之为 bok2。 **个人学习的目标,是缩小bok2和bok1之间的差距,形成你自己的更全面更扎实更强大的bok2。** 为什么学习目标要足够大?神经网络训练的实践有一个发现:**参数越多,成本函数最小化越容易。正因为这个规律,用神经网络解决复杂问题比解决简单问题更容易**。所以,AI 现在可以写作编程绘画,但是还没法在餐馆端盘子。 人类学习也是如此。目标足够大,进步才可能足够大,走的才能足够远。 3 从实例中学习 机器靠**样例学习**(learn from examples),从数据中学习,而非通过规则学习(符号AI路线已经破产多年)。机器通过大量的大量的数据来学习到数据中蕴含的模式和规律,就好像从大豆中压榨出其中丰富的油脂。 人类也应当从实例中学习。一本书,一篇文章,一个知识视频,一次演讲录像,一次面对面交谈,都是你学习的来源。从实例中,你学到丰富的、鲜活的、有意义的知识。 4 用高质量信息作为学习数据 **Garbage in,garbage out。这是机器学习的第一性原理**。如果数据本身不富含意义,哪怕训练数据再多,可能训练出来的大模型也无法实现高级的智能,甚至还会从垃圾材料中学到满嘴脏话。GPT的训练数据集是精心挑选的高质量数据,包括 Wikipedia、书籍、论文、代码以及高质量的互联网文本。 所以,人类的学习是不是也要尽可能用高质量信息作为学习数据?**在一头扎进某本垃圾教科书之前,先精心设计你的学习数据集**。对于任何主题,我通过什么小册子轻松上手登堂入室?通过大师的那本科普书获得大图景(big picture)?哪几本教科书才是全国范围内最好的教科书?有那些知识视频让我更直观更好的理解这个主题?有什么工具能让抽象复杂的知识变得具体而清晰? 学习是从数据中体验意义的过程。只有通过高质量的文章、书籍、视频、课程、网站和工具,才能高效提炼出真正的知识。 5 从错误中学习 在GPT模型的预训练过程中,数据依次通过神经网络的各层,最终生成下一个token。token的预测值和实际值之间的差异,这是模型的误差(error)。error = diff(预测值, 实际值)。 GPT就是通过error来学习,把误差用反向传播的方法反馈回去,调整模型参数,降低损失函数。 **预测下一个 token => 得出error => 反向传播 => 梯度下降 => 调整参数 => 预测下一个 token** GPT 只能通过误差来学习,人也是如此,只能从错误中学习到东西。错误和不足,是反馈的重要来源,也是最好的来源。 然而,人是追求奖励逃避惩罚的动物。**教育的规训让人追求正确,回避错误**。在孩子身上尤其明显,孩子会觉得错误不好,正确才好,一直正确一直好(直到ta迎来必然到来的重大挫折)。 我们可以认识到这个思维陷阱并尽量避免:虽然错误让人痛苦,但错误是唯一的学习来源。只有通过错误,人才能学到点什么东西。 6 唯有学习才能改变自己 GPT模型的训练过程,就是不断调整模型的过程,训练的每一步都在改变模型参数,改变模型本身的连接配置。 人的学习也还如此。每一次费曼,都得到你当前的理解与费曼式理解之间的差距,根据这个差距来调整,查资料,加深理解,再一次费曼。 每一次学习,都在改变你的大脑。不是比喻意义上的改变,而是字面意义上的改变,在生物和物质层面的改变:**短时记忆就是大脑突触之间神经递质增加释放,长时记忆就是基因表达蛋白质合成折叠,形成新的突触连接**。经过充分学习训练的大脑,在结构上不学习的大脑是截然不同的。之间的区别,类似于大脑和脑花之间的区别。 学习改变了大脑,改变了你,字面意义上的改变。 7 把阅读作为学习方法 **GPT的学习,是使用上百万GPU时间做一件事:阅读,阅读整个互联网,阅读几乎所有人类的语言文本**。这个阅读过程被被称为“预训练”,而GPT的阅读,只在做一件事:预测下一个token。而 GPT 的阅读量,是上万亿个 token。 人类的学习,也应该把阅读作为主要方法。scaling law对 GPT 适用,对人类神经网络也同样适用。人大附中早培班要求六年级小学生每年阅读五百万字,约 50 本书。个人认为这是保底要求。**人类学习者,需要首先成为一个贪婪的阅读者:一年五十本书。每天至少阅读一小时。** 没有预训练,GPT 无法学习;没有阅读,人类无法学习。 8 把费曼作为理解方法 GPT的理解,是在万亿维度的意义空间,用注意力机制,在数百层神经网络中,通过上万次的矩阵向量乘法来加工处理文本转化成的数字向量。 **text => token => generic embedding => embedding 2 => embedding x => final refined embedding => list of probabilities => next token** 对于一个token,GPT用它的上下文来不断关联,提取特征,调整这个向量在语言意义空间中的位置,形成富含意义的、更准确的理解。 人类的理解,也是把知识砖块和它的上下文不断建立丰富的、有意义的关联。最好的理解方法就是费曼技巧。**首先费曼知识砖块,然后不断费曼知识砖块之间的关联。通过清晰的概念以及概念之间的关联,人类形成自己的理解。** 把阅读作为学习方法,把费曼作为理解方法,一个概念接着一个概念,一次费曼接着一次费曼。 而且,费曼技巧,就是人类的“预测下一个token”。费曼的实际结果与期待结果之间的差异,就是我们在具体实例学习中得到的 error。针对这个 error,计算梯度,沿着梯度前进一部,你就得到了改进。 9 把迭代作为进步方法 GPT模型是在万亿token的高质量数据上训练出来的,用反向传播来传递误差,用随机梯度下降来减少模型误差。**每一个token的生成,都是神经网络中上亿神经元的一次激活,都是一次包含万亿参数在内计算。** 人类的学习,每一次费曼都是一次对神经网络的调参过程。哪怕是对一个概念的理解和费曼,都不是一蹴而就的。费曼x3,任何一个概念都要至少费曼三遍。在有间隔的多次费曼中,你对一个概念的理解变得越发清晰。 这是一种迭代式的学习闭环。闭环,迭代,这是学习之要义。把迭代作为进步方法。 10 规模法则,大力出奇迹 GPT模型是遵循规模法则(scaling law)的,规模法则是当前AGI之路的关键方法。wolfram说,“足够大的神经网络当然无所不能”。 人类神经网络,是否遵循规模法则?海量知识砖块的积累,构建出越发庞大、多元的个人知识体系,是否能像 GPT 一样带领个体发展出更强大的智能水平?用简单的话说,人类的学习,是否是“大力出奇迹”,凡事都靠积累? 答案很可能是肯定的。 11 身为父母,减少人为干预 曾经,人类设计AI系统走的是规则路线(符号AI)。曾经,机器学习是需要人工建立特征的(有多少人工,才有多少智能),相当于人类工程师教机器学习。现在,深度学习是端到端的,不用人为的特征工程。AI科学家们发现,学会放手,让神经网络做尽可能多的事情,让神经网络自己学习。**学会放手,结果惊人。** 身为人类父母,是不是也应该减少人为的、低水平的干预?大部分父母自己不是学习专家,不懂学习原理,强行扮演教育家是不是反而伤害了孩子的学习?是不是父母们也应该学会放手,不要瞎设计瞎教学? 孩子的大脑就像一个等待训练的 GPT模型,与其自上而下去指导教学,不如每天陪着孩子读半小时书,像一个朋友一样,让孩子快乐地享受伟大的预训练过程(阅读)。每天晚饭后,孩子做作业,大人在旁边读书学习。作业完成后,一起快乐共读,一起谈天说地。学会放手,生活更美好,学习更有效。 12 注意力是最贵的 GPT的T,是transformer架构。而transformer的精髓在于其用算法实现了类似人类的注意力机制,从而让模型在阅读文本时针对文本序列的不同部分给与不同程度的关注。 GPT的学习,是注意力分配的艺术。 人类的学习,也是注意力分配的艺术。当你阅读,你在不同内容上分配不同程度的注意力,关注概念之间的关联。 而且,整个有效学习的前提,是你能在学习这件事上建立并维持你的注意力。注意力的质量,决定学习的质量。 然而,你的注意力,是很多厂商虎视眈眈的猎物,10 亿短视频用户每天刷 150 分钟短视频,人们的注意力模式每天都在被短视频算法疯狂训练,训练到最后,一篇长文章都读不下去,更不要说严肃的书籍读物。 机器在学习,人类在沉迷。**机器通过注意力机制实现了更强大的认知能力。而人类的注意力却愈发稀缺和脆弱。短视频是免费的,但是,注意力却是最贵的。** 13 预训练之外的后训练 在让GPT模型阅读完互联网文本之后,OpenAI的科学家们还做了重要的一步:让人类积极地与GPT互动,并且在“如何称为一个更好的LLM助手”方面给与实际反馈。 是的,GPT模型的训练,除了预训练之外,还有**后训练:微调(finetuning),奖励建模(reward modeling)和RLHF(基于人类反馈的强化学习)。预训练占比95%,是绝对大头;后训练强调少而精,事半功倍。** 人类学习也是如此。除了海量阅读作为预训练,还需要后训练作为补充。 对海量阅读的孩子进行考试元技能的微调,只做了 8 套真题,8 岁儿童就能通过 FCE 考试。而对孩子的三观培养,家庭的家风建设,则类似于 GPT 模型中的奖励建模。为人父母,我们最重要的角色就是正反馈父母,不要学上“老中”的毛病,不过脑子,什么话难听说什么。只要做好正反馈,每个孩子都能培养出强大的澎湃的学习内驱力。 14 语言就是思维本身 人类语言,以及语言生成所涉及的思维过程,一直被视为复杂性的巅峰。而ChatGPT的成功给我们一个启示:在某种程度上,似乎人类语言的所有丰富性,以及人类能用语言谈论的所有事物,都可以被封装进一个有限的系统。 语言,在根本上,似乎比它看起来简单。**ChatGPT 则成功捕捉到了人类语言的“本质”和背后的思维方式**。ChatGPT 在训练过程中,隐含地发现了人类语言的语法规则,并且很擅长遵守这些规则。人类语言中丰富的语义信息,也被 GPT 通过向量空间中无数次的矩阵计算成功提取出来,存储为万亿参数构成的神经网络连接。通过掌握人类语言,GPT 还建立了某种意义上的世界模型。 人类学习也不应轻视语言,把语言视作普通的一个科目,分值有限,在高考中拉不开差距。不宜把口头的语言表达视作非核心技能,不宜把书面语言的写作技能视作非核心技能。每一个终身学习者,都应该足够重视语言,重视演讲作为核心技能,重视写作作为核心技能。 15 学习,快与慢的艺术 机器学习的快慢由一个超参数决定:**学习率 learning rate**,这是模型在梯度下降时的步子长短。步子太大,可能无法实现模型损失函数的最小化。步子太小,梯度下降太慢,效率太低。神经网络的训练中,合适的学习率是只能在实践中摸索出来的,只能来自经验。 人类学习也是如此。步子太大,看起来学的快了,但是理解浅,遗漏多。突击可以让你在考试中蒙混过关,但在实际应用中需要支付更高的代价。步子太小,龟速爬行,学起来会没劲。在快速学习和深度学习之间平衡,是学习的艺术。 而掌握这么艺术的最佳方式,是构建自己的知识树。以知识树为目标的学习,在快与慢之间最容易取得平衡:前期快速搭建框架,快速建立大局观,获得正反馈;然后慢慢微调,一个概念接着一个概念,看起来慢,但实现了更好的快。 16 学习,没有人出生在罗马 有人煽动起跑线焦虑,说什么“有的人出生在罗马”。在财富和权力层面可能对,但在学习这件事上,众生平等,没有人的家住在罗马。哪怕是马斯克的孩子,也得自己亲自预训练自己的神经网络,也得自己逼近学习目标,而且没有捷径。 机器学习也有起点和终点。起点是初始化的随机参数,终点是高维空间中损失函数最小的点。GPT模型的学习,就是在万亿维度的意义空间中找到这个最低点。 LLM们的学习都是后天的,难道ChatGPT比文心一言聪明是因为它出生在罗马?学习就是在万亿维度的意义空间趋近自己的目标函数,所有学习者的起点都是一样的,没有人生在终点,没有人家在罗马。 17 学习,每个人有自己的时区 有人煽动学习焦虑,像把大活人变成竹节虫,让人生布满“节点”: “婴儿英语启蒙要抓住关键节点”,“三年级真的至关重要” ,“大二是最关键的一年”,“人生最关键的节点是35岁”……多少岁毕业,多少岁买房,多少岁结婚,多少岁生子,多少岁财富自由…… 这个“社会时钟”妄图规定出一个人生的“标准时间”,规定了人们在不同的阶段要完成相应的 KPI。在“社会时钟”下,很多人在疲于奔命地过一种“打卡人生”。 但是,GPT的学习,是万亿维度的意义空间的旅程。每一条梯度下降的路线,都是逼近目标函数的路线,没有一个固定的、正确的路线。 人的学习也是如此。我们不需要一个“社会时钟”来规定你是迟到了还是来不及了。娃 6 岁了还没学 scratch,是不是晚了?孩子已经初中了,英语词汇量才 500,是不是来不及了?我三十多岁了,才开始学 python,丢不丢人? 每个学习者都有自己的时区,按照自己的节奏,走在终身学习终身成长的道路上。芒格曾经说过,我今年学习了做 PPT,我这 90 多岁的老狗还能学会新技能,你们年轻人还担心什么。 只要你还在学习,还在往前走,就无所谓早晚。每个人都是独一无二的,每个人对自己的路线拥有主导权和解释权。横向比较是愚蠢且没必要的。 18 学习,简洁是更高级的复杂 机器学习的早期,人们认为应该在神经网络中使用各种复杂的独立组件,从而让神经网络“显式地实现特定的算法思想”。GPT之后,人们发现,更好的方式是使用非常简单的组件,让它们“自我组织”,反而能更好地实现算法思想。 **ChatGPT原理的一大启示:最强大的智能,并非通过复杂部件的堆砌,反而来自结构简单的无数计算元素的组合,以及朴实无华的scaling law。** 最复杂的神经网络,由最简单的基本结构组成。人类的学习也是如此。不要迷信复杂的工具和技巧,大道至简,简单最好。 最庞大的知识体系,也不过是由一系列简单的事实性知识、概念、模型组合而成,而学习这些概念的方法本身也是简单而非复杂的,朴实而非深奥的。 --- 这些,就是 ChatGPT 教给我关于学习的道理。
See More
uubbccgg
retweeted
偶像派作手
@oxpsats
over 2 years ago
经济学人不愧是最懂中国的一个期刊,今天这篇文章非常推荐一读。 他把当下中国在哪些科技上是领先世界的,做了很详细的梳理,比如:“在电子商务、金融科技、高速列车和可再生能源领域,中国处于或接近技术前沿。同样引人注目的是,中国去年成为全球最大的汽车出口国,其中电动汽车的成功起到了重要作用。” 当然还有无人机、雷达、机器人和声纳以及后量子密码学方面也处于领先地位。 并且哪些是对外部有依赖的也都分析了。 非常全面地解读了什么是“新质生产力”。
吃毛巾卷吗
@uubbccgg
over 2 years ago
@March_seven21
好嘞谢谢你
吃毛巾卷吗
@uubbccgg
over 2 years ago
好吓人……怎么突然这么多奇怪的账号关注我……X还显示我账号异常要冻结我账号🥲
吃毛巾卷吗
@uubbccgg
over 2 years ago
离谱
uubbccgg
retweeted
Mafiana
@MsMafiana
over 2 years ago
@MissMafiana
网易云doi歌单 《Sexyˁ῁̮ˀ How U doi》https://t.co/9cCD7c1Tlz
uubbccgg
retweeted
宝玉
@dotey
over 2 years ago
这个GPT提示词库不错👍🏻 https://t.co/fWh9L1uLpM
uubbccgg
retweeted
徐老猫
@raycat2021
over 2 years ago
分享6个本周听过或正在听的财经播客节目。 1,锂铜等关键原材料的全球争夺 - Value Hive 播客主请来了前路透记者Ernest Scheyder谈论他写的一本新书,主题是关键原材料的全球争夺战。人类走向绿色能源离不开锂铜这些原材料,全球围绕着这些原料的开采利用展开了激烈争夺。作者作为路透的记者对这个话题有非常宏观的视野和观察。 https://t.co/AUeQpWRxhS 2,川普上台将如何颠覆美中关系- Odd Lots 主持人Tracy和Joe请了一名经济学家和一名记者,谈谈川普如果上台在美中关系方面可能采取的动作及后果。 可以听听,涉及面比较广但未必就谈透了。川普上台,美中关系会进入大调整,但仍会达到某种程度的平衡而不致于激烈冲突。 https://t.co/wOy4Mx67Iq 3,为决策者解密AI - Infinite Loops 主持人Jim O’Shaughnessy邀请专栏作家Rohit Krihnan谈谈AI,此君刚出版了一本新书《创造上帝:为决策者解密AI》。话题很广,从AI原理、开源/闭源、数据、社会如何适应等多个话题进行了分析。作者并没有完全从技术角度考虑问题,而更多带有社会学思考。很适合一个普通小白来理解AI以及对社会的影响。 https://t.co/FrZkeoFrOb 4,Shake Shack创始人谈餐饮服务 - Invest Like the Best 主持人Patrick O’Shaughnessy(前一播客主是他父亲,两人各干一摊)采访了Shake Shack创始人Danny Meyer,讨论餐饮服务的重要性。作为资深的餐馆创业者和经营人,Danny Meyer的商业理念围绕着优质独到的服务,这是一家餐厅的灵魂。可以听听他的创业体会,如何将一个餐饮概念实现规模化效应、走向强大品牌的。 https://t.co/tWZnR5htw3 5, 英特尔:周期性复苏还是终极死亡 - Business Breakdowns/Colossus 这个是我存着必听而且会听两遍的,因为我自己也在了解英特尔的前景。Business Breakdown是少有的高质量分析上市公司的播客,这个节目全面阐述了英特尔如何屡次丧失历史性机遇,以及目前AI和地缘政治又一次给了公司重生的机会。 https://t.co/OKVbENYfzb 6,去全球化和资源民族主义 - Commodity Culture 商品分析员Lior Gantz认为,去全球化的新时代已经开始,这将导致激烈的资源民族主义,影响铀、镍和许多大宗商品的供应。他解释了为什么我们仍处于铀牛市的早期阶段,并且判断美联储下一步将采取的行动,以及推动黄金和白银走高的因素等。 https://t.co/FK9zbKeSsH 最后欢迎大家关注我,我会定期分享我看到的高质量全球财经内容。
See More
吃毛巾卷吗
@uubbccgg
over 2 years ago
@lxfater
@HuoQubot
Last Seen Users on Sotwe
Limon ama Sulu 🍋
Seen from
Turkey
🤍..B𝘢𝘳𝘳𝘺..🤍
Seen from
Oman
kahel 🔞
Seen from
United States
Lay ชอบโชว์หีใหญ่
Seen from
Thailand
DOC
Liam Gillis
Seen from
United States
Rayane92
Seen from
France
Instituto Malvinas
Seen from
Brazil
👿
Seen from
United States
🔞Wasmo_somali🔞
Seen from
Kenya
Trends for you
1
Reggie
Under 10K tweets
2
Good Thursday
Under 10K tweets
3
Happy New Month
Under 10K tweets
4
Christa Pike
Under 10K tweets
5
Cubs
Under 10K tweets
6
Becerra
Under 10K tweets
7
Hazbin Hotel
Under 10K tweets
8
Firing
Under 10K tweets
9
Arike
Under 10K tweets
10
Independence Day
Under 10K tweets
Most Popular Users
1
Elon Musk
@elonmusk
241.7M followers
2
Barack Obama
@barackobama
119M followers
3
Cristiano Ronaldo
@cristiano
114.5M followers
4
Donald J. Trump
@realdonaldtrump
111.9M followers
5
Narendra Modi
@narendramodi
107.2M followers
6
Rihanna
@rihanna
98.7M followers
7
NASA
@nasa
92.4M followers
8
Justin Bieber
@justinbieber
91.8M followers
9
KATY PERRY
@katyperry
90M followers
10
Taylor Swift
@taylorswift13
84M followers
11
Lady Gaga
@ladygaga
75.5M followers
12
Virat Kohli
@imvkohli
73.4M followers
13
Kim Kardashian
@kimkardashian
70.9M followers
14
YouTube
@youtube
68.8M followers
15
Neymar Jr
@neymarjr
66.4M followers
16
Bill Gates
@billgates
65.2M followers
17
Selena Gomez
@selenagomez
63.1M followers
18
The Ellen Show
@theellenshow
62.3M followers
19
CNN
@cnn
61.8M followers
20
X
@x
60.7M followers
Olivia
Online
✨
⭐
💫