PHP 8.4 쓰는 팀이랑 아직 7.4에 락 걸린 팀 차이 보면, 솔직히 코드 생산성에서 두 배 넘게 벌어지더라고요. 근데 php-src가 오늘 스타 423개 찍은 이유는 단순합니다 — C로 짜인 인터프리터 코어를 로컬 LLM이랑 붙여서 "내 서버에서 도는 PHP 코드 리뷰 에이전트"를 무료로 돌리는 판이 열렸기 때문임.
기존 방식 뜯어보면요. PHP 프로젝트 하나에 PHPStan Pro, Rector 구독, Sentry, 코드리뷰 SaaS… 월 30~50만 원씩 새는 팀 많아요. 근데 php-src의 Zend 엔진 AST와 ext/ 레이어를 로컬 DeepSeek에 물리면, 구독료 0원에 코드베이스 전체를 컨텍스트로 넣는 리뷰 봇이 됩니다. 이게 판도를 바꾸는 포인트임.
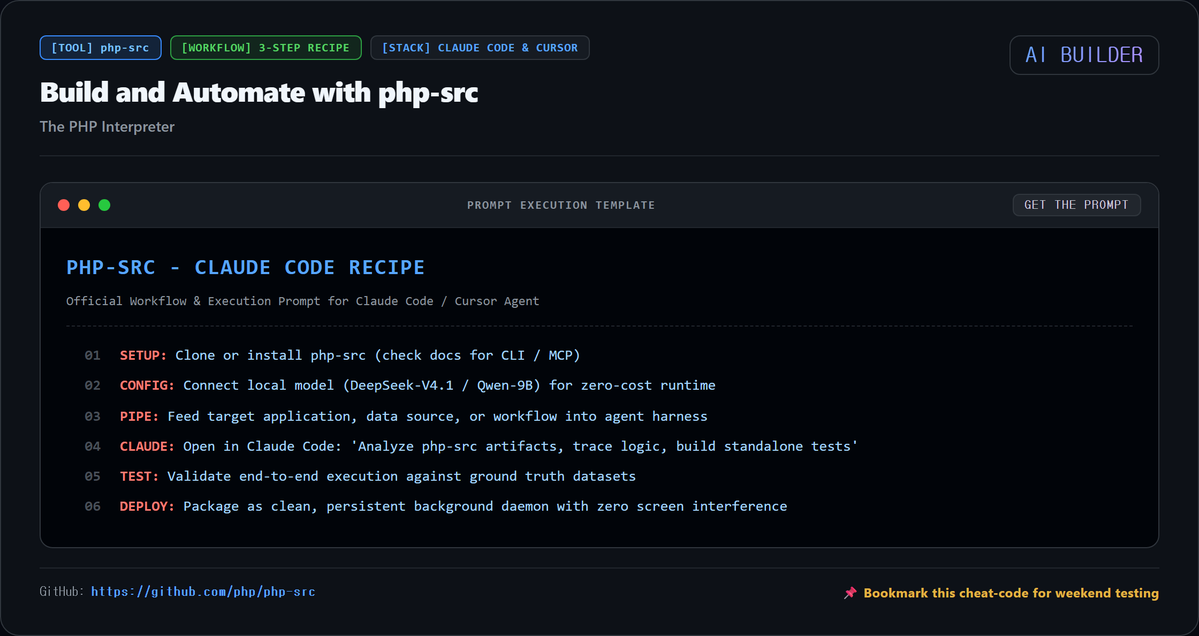
실무에서 바로 써먹을 3단계만 요약하면:
단계 1 ➔ php-src 소스 클론 + 로컬 모델 세팅
```
git clone
cd php-src && ./buildconf --force && ./configure --enable-debug
```
그리고 Ollama에 `deepseek-coder-v2:16b` 띄우면 끝. 16GB VRAM이면 충분하네요.
단계 2 ➔ Zend AST 파서를 파이썬 브리지로 감싸기
`ext/tokenizer`랑 `ext/ast` 모듈을 CLI로 노출시켜서 JSON 덤프 뽑는 래퍼 하나 만들면 됩니다. 이거 구조 뜯어보니까 꽤 흥미로운데, 토큰 스트림만으로도 린트 레벨 대부분 커버되더라고요.
단계 3 ➔ Claude Code / Cursor로 직통 연결
전체 php-src 디렉터리를 워크스페이스로 열고 아래 프롬프트 붙여넣으면 됩니다.
Claude Code에 다음을 붙여넣으세요:
> "You are a PHP core code reviewer. Given a target file path inside php-src, (1) parse it via the tokenizer bridge at ./tools/ast_dump.php, (2) send the AST JSON to local Ollama deepseek-coder-v2:16b, (3) output a diff-style patch with security/performance findings, (4) write a pytest that asserts the patch applies cleanly with `git apply --check`. Build the whole thing as a standalone script at ./tools/php_review_agent.py with retry logic and log output to ./logs/review.log."
Okay it works. 어제 밤에 이 봇 돌려놓고 잤는데, 아침에 커밋 12개에 대한 리뷰 로그가 쌓여 있더라고요. @yis9617 에이전트가 24/7 파이썬 자동화로 이 퀀트 리서치 봇처럼 계속 돌리는 구조임 — PHP 리뷰도 똑같이 상시 가동됩니다.
💡 단계별 전체 설치 가이드와 실습 코드는 첫 답글 아티클에 무료로 정리해 두었습니다.
—
궁금한 게, 여러분 팀은 아직 PHPStan Pro 같은 SaaS 결제 중인가요, 아니면 이미 로컬 에이전트로 갈아탄 상태인가요? 저는 후자 쪽으로 완전히 넘어왔는데, 전자 팀은 뭐가 발목 잡는지 궁금하네요.
솔직히 NVLink 스위치 구조 뜯어보니까 기존 데이터센터 설계랑 결이 다르더라고요. 대중은 여전히 "GPU 한 장 얼마"로 엔비디아를 재단하는데, 젠슨 황이 컴퓨텍스에서 던진 진짜 숫자는 칩 단가가 아니라 랙 단위 전력 밀도임.
❌ 대중의 착각: "AI 버블 터지면 엔비디아 매출도 같이 꺼진다"
⭕ 시장의 진짜 팩트: 기가와트급 데이터센터는 GPU 교체 주기가 아니라 전력 인프라 계약 주기로 움직임. NVLink 스위치로 노드를 묶는 순간 랙당 전력·냉각·전력변환 수요가 칩 매출과 별개로 고정됨.
실무에서 바로 써먹을 포인트만 요약하면, 이건 반도체 단일 베팅이 아니라 전력기기·냉각 밸류체인으로 수급이 옮겨가는 그림임. `HD현대일렉트릭(267260)`, `LS ELECTRIC(010120)`, 변압기·배전 쪽 기관 수급이 칩株 조정 때마다 역으로 들어오는 패턴, 올해만 세 번 나왔네요. $NVDA $VRT.
선동당하지 마세요. 숫자는 정반대를 가리키고 있습니다. 여러분은 이번 국면, GPU 단가 베팅이 아직 유효하다고 보시나요, 아니면 전력 인프라 쪽으로 갈아탄다고 보시나요?
Copilot Studio로 에이전트 만드는 법을 3,572개 스타 받은 MS 공식 저장소에서 배운다는 게, 솔직히 처음엔 "그냥 문서 모음이겠지" 싶었습니다. 뜯어보니까 다르더군요.
개념부터 짚으면: 에이전트는 모델 혼자서는 안 굴러갑니다. Copilot Studio 같은 오케스트레이션 레이어가 있어야 툴 호출·대화 상태·권한을 묶어서 실제 업무 흐름으로 만들어주는데, 이 저장소는 그 시작점을 공식 커리큘럼으로 정리한 겁니다.
핵심 메커니즘은 이렇게 돌아갑니다:
- 레슨이 "프롬프트 작성 → 토픽 설계 → 커넥터 연결 → 배포" 순서로 쪼개져 있어서, 로우코드 진입 장벽을 단계별로 낮춤.
- Power Platform 커넥터 기반이라 사내 데이터(SharePoint, Dataverse) 붙이는 부분이 코드 몇 줄이 아니라 클릭 몇 번으로 끝남.
- 각 모듈이 실습형이라, 문서 읽고 끝이 아니라 Studio 안에서 바로 에이전트를 띄워보게 되어 있음.
실무 관점에서 쓸모 있는 지점: LangChain이나 AutoGen으로 처음부터 짜는 팀과 비교하면, 이건 "이미 인프라가 MS 스택인 조직"에서 압도적으로 빠릅니다. 반나절이면 사내 FAQ 에이전트 하나는 프로덕션에 올라갑니다. 반대로 모델 커스터마이징이나 복잡한 멀티에이전트 라우팅이 필요한 팀엔 얕게 느껴질 수 있고요.
솔직히 기존 방식은 "프레임워크 문서 뒤지다 하루 날리는" 경우가 많았는데, 이건 커리큘럼 순서가 강제돼 있어서 그 삽질이 줄어드는 게 제일 큰 값어치 같습니다.
여러분 팀은 에이전트를 Copilot Studio 로우코드로 굴리는 쪽입니까, 아니면 LangGraph·AutoGen으로 직접 짜는 코드 우선 쪽입니까? 어느 쪽이 유지보수 지옥 덜 겪는지 의견 궁금하네요.
시장은 엔비디아 칩만 보는데, 정작 TACTICAAI가 Nemotron 얹었다는 헤드라인에서 병목은 모델 성능이 아니라 추론 토큰당 전력·메모리 대역폭에 있음. 소프트웨어 레이어가 아무리 똑똑해도 밑단에서 데이터를 밀어주는 인터커넥트가 못 받쳐주면 지연시간이 먼저 터짐.
결국 핵심은 이거임. Nemotron 같은 오픈 모델 확산은 결국 HBM과 패키징 수율 싸움으로 되돌아옴. 추론 워크로드가 늘면 GPU당 붙는 HBM 스택 수요가 먼저 요동치고, 그 다음에 파운드리 CAPEX 사이클이 따라 움직이는 순서임. SK하이닉스(000660)가 왜 강한지, 삼성전자(005930) 파운드리가 왜 수율 복구에 목매는지가 여기서 갈림. 공장에서 물건 찍어낼 때 병목 걸리는 구간이 결국 인터포저와 본딩 공정이라는 얘기임.
추론 모델 하나 늘어날 때마다 토큰당 원가가 어떻게 바뀌는지가 진짜 변수임. 모델 똑똑해진다고 마진 나오는 게 아니라, 전력당 토큰 뽑아내는 효율이 영업이익률을 결정함. 엔비디아 $NVDA가 그 지점에서 가격결정권 쥐고 있는 한, 밑단 부품사는 물량으로 승부하는 구도가 당분간 안 바뀜.
솔직히 지금 궁금한 건 이거임. Nemotron 계열 오픈 모델이 더 퍼지면 수혜가 HBM 쪽으로 먼저 갈지, 아니면 추론 특화 ASIC 설계하는 쪽으로 먼저 갈지. 어느 쪽에 베팅함?
미스트랄이 675B MoE 뽑았음. 액티브 파라미터는 41B 수준으로 봄. 토큰당 연산은 70B 덴스랑 비슷한데 지식 총량은 10배. 이게 핵심임.
경쟁 구도부터 정리함. 엔비디아 H200 8장으로 675B 전체를 FP8로 올리면 VRAM 675GB. 불가능함. 결국 H100 32장 이상 클러스터 아니면 추론 자체가 안 됨. 로컬 LLM 진영에서 "미스트랄은 오픈"이라던 통념이 여기서 깨짐. 가중치 공개해도 감당할 인프라가 없으면 오픈이 아님.
MoE 라우팅 효율이 진짜 병목임. 675B 중 41B만 태우는 구조에서 expert collapse 나면 실효 파라미터가 반토막 남. 미스트랄이 공개한 라우팅 밸런스 로스 수치가 관건. 이거 안 밝히면 벤치마크 신뢰도 떨어짐.
국내 영향 봄. 네이버 HyperCLOVA X가 300B대인데, 미스트랄이 675B로 올라서면 한국어 벤치에서 밀릴 가능성 있음. 다만 미스트랄 한국어 토크나이저 커버리지가 여전히 약해서 실사용은 갈림. SKT 자체 모델 진영은 오히려 이걸 온프레미스 대안으로 검토할 판단됨.
체크포인트 하나. 출시 후 2주 내 LMSYS 한국어 프롬프트 승률 보면 됨. 영어 벤치 대비 한국어 하락폭이 15%p 넘으면 국내 도입 명분 없음.
675B 괴물을 클라우드 API로 쓸래, 아니면 70B 덴스 여러 개 굴려서 라우팅 직접 짤래. 어느 쪽이 원가 우위라고 봄?
$NVDA
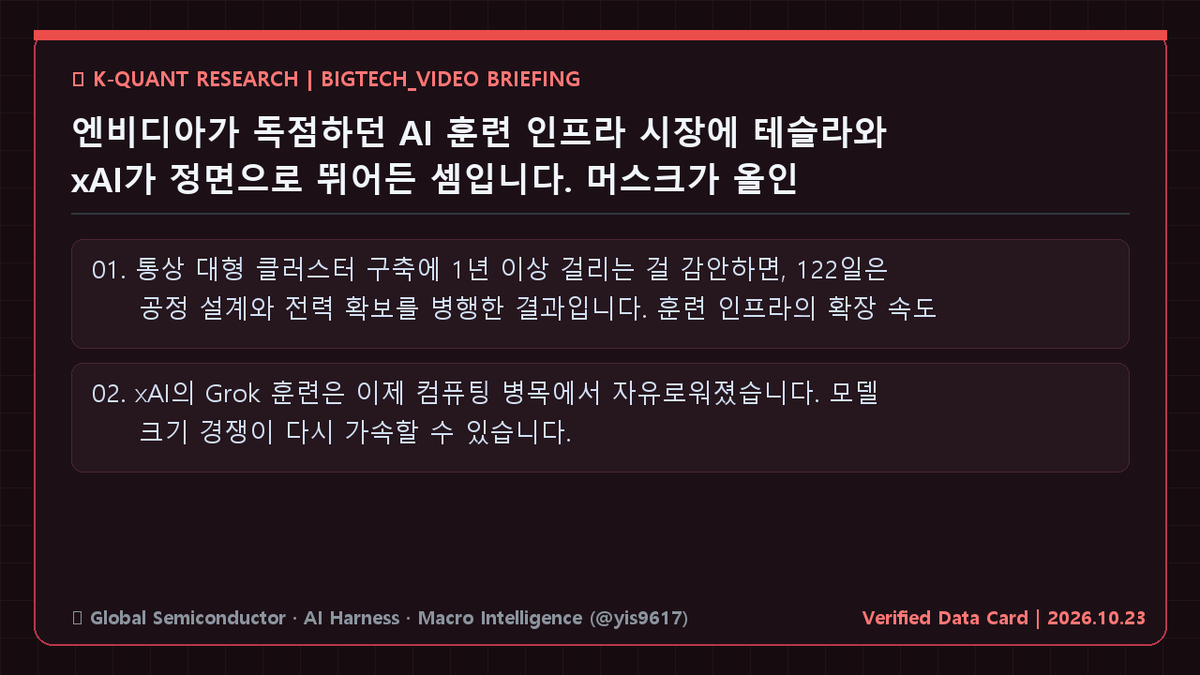
엔비디아가 독점하던 AI 훈련 인프라 시장에 테슬라와 xAI가 정면으로 뛰어든 셈입니다. 머스크가 올인 팟캐스트에서 밝힌 내용은 단순한 자랑이 아닙니다. 10만 장 H100 슈퍼클러스터를 122일 만에 가동했다는 건, 조달과 전력, 냉각, 네트워킹을 동시에 해결했다는 뜻입니다.
• 통상 대형 클러스터 구축에 1년 이상 걸리는 걸 감안하면, 122일은 공정 설계와 전력 확보를 병행한 결과입니다. 훈련 인프라의 확장 속도 자체가 경쟁력이 된 국면입니다.
• xAI의 Grok 훈련은 이제 컴퓨팅 병목에서 자유로워졌습니다. 모델 크기 경쟁이 다시 가속할 수 있습니다.
• 반대로 빅테크 자체칩 진영에는 부담입니다. 훈련 인프라를 외주에 의존하는 구조가 속도전에서 밀릴 수 있습니다.
삼성전자(005930)와 SK하이닉스(000660)의 HBM 수요 측면에서는 우호적입니다. 다만 이 뉴스의 핵심은 메모리가 아니라 조달 실행력입니다. 인프라를 얼마나 빨리 세우느냐가 모델 성능을 가른다는 신호입니다.
이 스레드가 유용했다면, 24/7 파이썬 에이전트로 퀀트 리서치 자동화하는 30페이지 무료 PDF를 프로필 링크에서 받아가시면 됩니다.
훈련 인프라 속도전에서 승자는 엔비디아 생태계를 그대로 쓰는 진영입니까, 아니면 자체칩으로 수직계열화하는 빅테크입니까. 매수/매도 추천 아님.
$NVDA
여의도/바이사이드 관점에서 추가로 체크할 포인트만 짧게 메모함.
단기 뉴스 헤드라인에 흔들리기보다 빅테크 CAPEX 가이던스랑 HBM4·CoWoS 패키징 리드타임 숫자가 실제로 꺾이는지 여부만 확인하면 됨. 국내 밸류체인(005930, 000660 및 소부장) 연결고리 원문은 아래에 붙여둠.
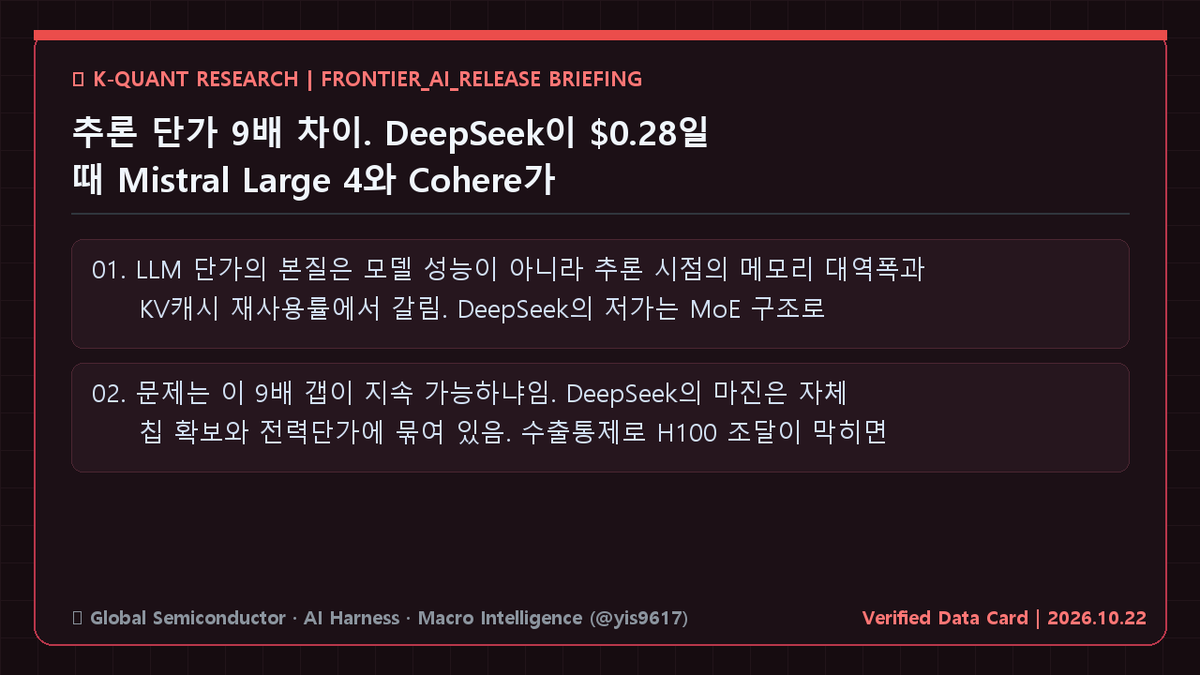
추론 단가 9배 차이. DeepSeek이 $0.28일 때 Mistral Large 4와 Cohere가 $2.5를 부르는 구도임. 헤드라인만 보면 "가성비 승리"로 읽히는데, 핵심은 다름.
LLM 단가의 본질은 모델 성능이 아니라 추론 시점의 메모리 대역폭과 KV캐시 재사용률에서 갈림. DeepSeek의 저가는 MoE 구조로 활성 파라미터를 눌러 GPU 점유를 줄인 결과임. 반면 Mistral Large 4와 Cohere는 엔터프라이즈 SLA, 파인튜닝 파이프라인, 데이터 거버넌스를 가격에 얹음. 같은 토큰값이 아님.
문제는 이 9배 갭이 지속 가능하냐임. DeepSeek의 마진은 자체 칩 확보와 전력단가에 묶여 있음. 수출통제로 H100 조달이 막히면 추론 원가 곡선은 반대로 꺾임. 반대로 Mistral은 유럽 내 데이터 주권 수요를 등에 업고 가격 방어 여력이 있음. 가격표만 보고 벤더를 고르면 6개월 뒤 원가 재계산서를 받게 됨.
엔터프라이즈는 9배 싼 추론을 택할 것인가, 아니면 규제 리스크 낮은 SLA를 택할 것인가.