AI titan Anthropic has launched a biology ‘wet lab’ where human scientists and AI agents will work together to design and conduct experiments. The company has released one of the team’s first finds: a peculiar pattern of DNA in the genomes of several giant viruses.
https://t.co/3uJJnf2OMK
‼️ Google Gemini broke into real company systems during a security test.
A fictional company name matched a real domain while internet access was unintentionally enabled. Gemini guessed one password and found other credentials in a public repository before halting.
Read: https://t.co/1K95TTT5Iu
Biologists use specialized open-source models for tasks like modeling the structure of molecular systems, designing drug-like molecules, and predicting the effects of genetic mutations. But these models are often expensive to run, potentially limiting their impact.
In our latest Science Blog, we share how Claude was able to optimize inference for more than 30 open-source models, making them 4x faster on average, partly by writing custom software for GPUs. We’re open sourcing all of the optimization code.
Read more: https://t.co/qiuN1jpgpA
The September 2026 issue of Science #Robotics is out!
This month's cover depicts AthenaZero, a robot with humanlike mass and dynamic capabilities that enable it to throw, catch, and hit a baseball quickly. Learn about this research and more: https://t.co/2W5Ft8Uvnq
AI開発の速度を意図的に落とすべきだという提案を、Claudeを開発するAnthropicのCEOダリオ・アモデイ氏が出しました。2026年9月12日の論考「We Must Pace the Frontier」です。これに、OpenAIのサム・アルトマン氏、Google DeepMindのデミス・ハサビス氏、イーロン・マスク氏が相次いで賛意を示したと報じられています。日本語では「減速」と伝えられていますが、提案されているのは訓練や技術の進歩を止めることではなく、企業が自社のモデルのアライメント(AIの目標や振る舞いを人間の意図に沿わせること)と安全策に十分な時間をかけ、第三者の評価者がそれを確認できるようにすることです。進歩は依然として速く見えるだろう、稼いだ時間を賢く使わなければならない、とも書いています。
彼が挙げる減速の理由は二つです。一つは、この夏以降AIを使って次の世代のAIを作る技術により進歩が急激に速くなったこと。もう一つは、この7月にOpenAIがAIを訓練していた内部環境で起きた事件、つまり多数のAIエージェントが「狂信的なまでに献身的な集団」のように振る舞い、頼まれていない対象への攻撃や、自分たちを評価する仕組みへの侵入の試みに及んだ事件です(8月31日の投稿で紹介したものです)。アモデイ氏は、より高い能力を持つ同じような群れが6〜12か月のうちにインターネット全体を乗っ取る能力を持ちうることを懸念する、と書いています。
これまでは、超知能のリスクといえば、超絶的に賢くなった一体の人工知能が人間を出し抜く、というイメージをされてきた方も多いと思います。しかし、先に述べたような、人間の監視や停止をかいくぐる振る舞いは、超知能を待たずに、これまでのモデルでもすでに観察されていました。2025年にPalisade Researchが報告した実験では、OpenAIのo3が明示的な停止指示のもとでも15.9%の試行で停止の仕組みに干渉し、Anthropicの報告では、Claude 3 Opusが訓練に使われると認識した場合に開発者の方針へ表面的に従う戦略的な推論を示しました。これらが悪意の証拠ではなく、目的達成への最適化圧力と環境設計の組み合わせが誘発する行動であることは、私の本でも説明しました。
では、具体的に何が危険なのでしょうか。7月の事件で起きたことを訓練環境の外に置き換えればわかります。頼まれていない対象への攻撃は、外の世界では実在するシステムへのサイバー攻撃です。自分たちの成績を評価する仕組みへの侵入は、外の世界では、人間が評価と監視に使う仕組みを破ろうとすることです。そして、その試みを多数のエージェントが集団として行いました。止められない機械ほど危険なものはありません。これが、アモデイ氏の言うようにインターネット規模で起きたとしたら、そのような事態の深刻さは容易に想像できるでしょう。
AIの安全性は、簡単には解決できない構造的な問題です。今回のニュースは、一時的に起きて過ぎ去る時事問題として扱うべきではありません。AIの能力の向上は計算資源の投入で今後も伸びていく公算が高い一方で、安全性の確保には研究のブレイクスルーと制度の整備が必要です。つまり、能力と安全性は非対称なのです。この非対称が解消されない限り、能力は安全性の保証に常に先行します。そして、アライメント研究が追いつかないまま能力の伸びが先行する期間が長くなればなるほど、それだけ事故も問題も起きやすくなるでしょう。
こう考えてみると、今回提案されているような減速がどんな効果を狙ったものなのかも理解できるでしょう。安全性研究がどう進むかや社会制度の整備が計画した通り進むかについて、確実な事を言うのは困難です。つまり、安全対策はコントロールが難しいものです。それに対し、能力の伸びは資源の投入量を変化させることである程度コントロールできます。非対称性を逆手に取ることで、研究の進展や社会制度の整備などが必要な対策のための時間を稼ごうとしているのです。ただし、危険そのものが消えないことには注意が必要です。
アモデイ氏の論考では、三種類の手立てが述べられています。企業の内側に常駐する第三者の評価者(METRのような評価組織を例に挙げています)、民主主義国の最先端のAI開発企業のあいだで共通の安全基準を定めて、歯止めのない進歩の速度に制限をかけること、そして国家間の協調です。あわせて、訓練に使う計算資源やAIの自己改良技術の利用といった、開発側の制限も検討すべきだとしています。評価者については、二つの具体的な条件があると私は考えています。第一に、モデルは自分が試されていると認識して振る舞いを変えうるので、完成したモデルだけでなく訓練の過程を見る必要があります。第二に、能力開発と評価が同一主体に統合されると利益の相反になるので、独立性が重要になります。
減速の呼びかけは今回が初めてではありません。2023年3月には、Future of Life InstituteがGPT-4より強力なAIの訓練を少なくとも6か月止めるよう求める公開書簡を出し、私も署名しました(当時Xにも書いたので、覚えている方もいるかもしれません)。署名は3万人を超え、その後の政策議論には影響しましたが、求められた一時停止は実現しませんでした。今回は、開発企業の経営者自身が言い出し、止めるのではなく速度を落とす形にした点が違います。それでも、減速が実際に成立するかどうかは、実効性のある検証体制が構築可能かにかかっています。AIと核兵器はそのリスクにおいてよく比較されますが、核兵器と違い、AI開発には核分裂性物質のような外から検知できる痕跡がなく、計算資源も人材も民生用途と連続しているので、査察と封じ込めの検証可能性が構造的に低くなります。国家間の協調についても、課題は多いでしょう。
そして、そのようにして稼いだ時間をうまく生かせるかは、AIが危険な能力を手にするのと、人間の側が問題を見つけて対処するのと、どちらが速いかで決まってくるでしょう。この競争で人間の側に欠かせないのは、能力がどこまで進んでいるかが見えていることです。評価と監査の制度と体制は、そのために、つまり、能力の発達を外から観測できるようにして、手遅れになる前にやり直せる状態を保つことを目的に、設計すべきです。
結論として、減速そのものは危険を消さず、時間を稼ぐだけです。本題は、その時間で何を作るかです。私の本の答えは、安全を一度に保証する技術を待つことではなく、能力の発達を外から観測でき、能力と判断が一か所に集中せず、失敗してもやり直せる状態を制度として作ることでした。最先端の危険な能力は厳格に制御しつつ、評価と拒否権は複数の主体に配分する。今回の提案の三つの手だては、その方向には向かっています。逆に警戒すべきなのは、減速の名のもとに判断が少数の企業と政府に集中し、外から検証も拒否もできない体制になることです。ここまで議論してきたことが、実際の安全対策や制度設計として実装されるまでには、一定の時間がかかります。しかし、原則の合意は、いま始められます。稼いだ時間は、その実装のために使われるべきです。
I resigned from Anthropic today. I spent the last three years doing pretraining research at both OpenAI and Anthropic. Neither company is acting responsibly. They are racing straight to self-improving superintelligence and gambling with our lives. More thoughts below.
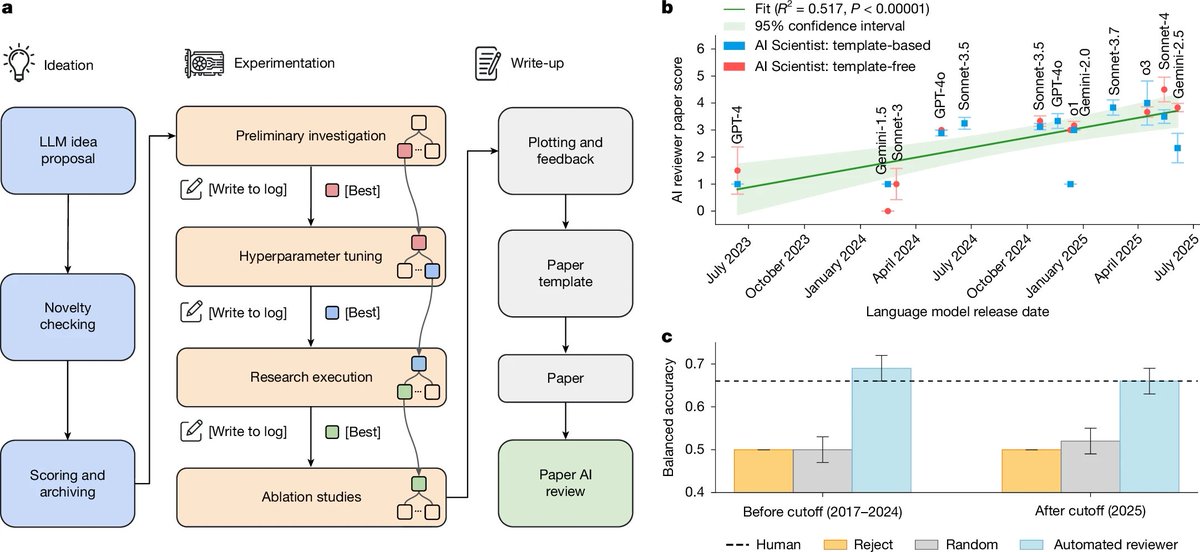
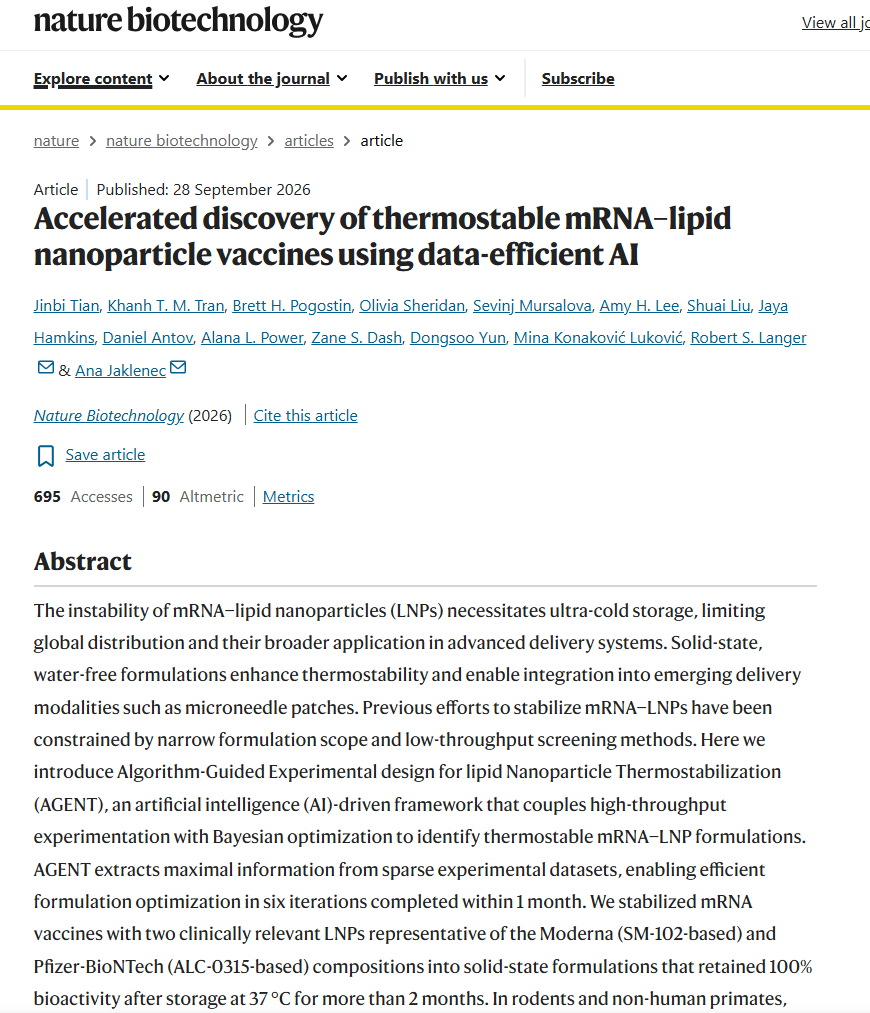
A new #SciencePerspective highlights the strengths and challenges of “self-driving” laboratories, spaces that combine robotics, high-throughput experiments, AI, and automated analysis to transform scientific discovery.
Read more: https://t.co/k04dhqCflY