We need to reconsider our priors on code readability.
Humans, compared to agents, are pretty slow at understanding large quantities of text. So in the old days, readability was important so the human could efficiently grok what was going on.
So readability now comes down to:
1. Can a human, if needed, jump in and understand the code
2. Does the code use the same domain language as the human describing the code?
1 helps with observability and the occasional spot checks you need to do on important PR's. 2 helps the agent translate the words you use into code changes.
In other words, readability is now a nicety, not a necessity.
The way agents 'read' code is different - good agents are all about gathering data about how the code works. They'll prod around with it, execute parts of it.
So 'readability' to agents really means 'verifiability'. How easy it is to mess about with that code to see it working.
Let's take this scenario:
- You have a huge module in your codebase that uses all sorts of complex performance tricks
- It has 100% test coverage
A talented human would need an hour or two to get comfortable working in that module.
An agent needs zero time. They verify it with the tests, poke about a bit, and they're good to go.
The takeaways:
- When judging a module (or a codebase), don't think about how easy the code is to read
- Instead, think about how easy it is to verify
- Design your codebase so modules can be tested and verified independently
- Feel free to sacrifice a bit of readability for performance
- Cyclomatic complexity and function size don't matter to agents
Real life: My developer friend was recently compromised by an exercise during a fake job interview. They were asked to download a tarball then run git operations within it as part of the live interview.
Git security models prevent hooks from transferring during a standard git clone (since hooks live in the .git/hooks directory, which is local to a repository and ignored during remote fetches). Receiving a project as a ZIP file, tarball, or untrusted directory however bypasses this protection allowing malicious code to execute during seemingly ordinary git commands.
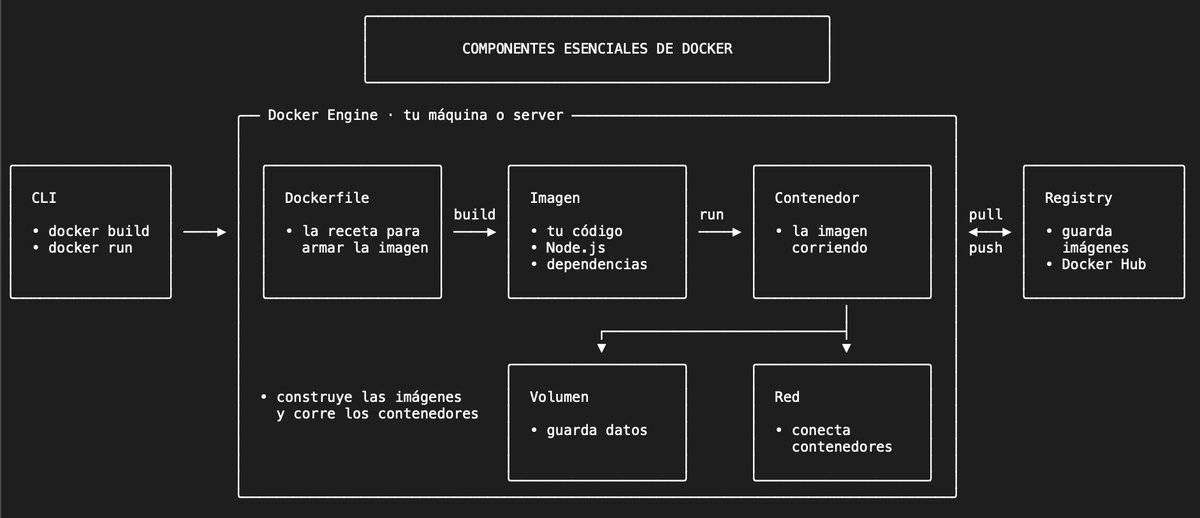
¿para qué se usa Docker y qué problema resuelve?
desarrollás una API con Node.js y en tu computadora funciona perfectamente, pero cuando la llevás a producción aparecen problemas:
-> el servidor tiene otra versión de Node.js.
-> faltan dependencias o librerías del sistema.
-> el entorno está configurado de otra manera.
podrías instalar y configurar todo manualmente en cada servidor, pero repetir ese proceso lleva tiempo y es fácil cometer errores.
por eso se usa Docker.
Docker te permite crear una imagen que contiene tu código, Node.js y las dependencias necesarias para funcionar.
en lugar de configurar cada servidor desde cero, usás esa imagen para levantar un contenedor: un entorno aislado donde se ejecuta tu API.
¿qué ganás con esto?
1) consistencia: usás la misma imagen en desarrollo y producción.
2) portabilidad: podés ejecutarla en otros servidores compatibles.
3) aislamiento: distintas aplicaciones pueden convivir con sus propias dependencias.
construís la imagen una vez y podés usarla en distintos entornos, sin tener que preparar todo desde cero.
¿y si necesitás administrar cientos de contenedores distribuidos en varios servidores? ahí ya podes usar Kubernetes.
voy a hablar un poco sobre el vídeo que hice sobre "Matamos SDD por ODD", porque hay mucha opinión sin leer la docu que vengo a aclarar: Sí, con sdd podes iterar y además el titulo es picante (como yo), pero acá viene el tema.
Todas las definiciones de sdd (spec kit, la taxonomía de birgitta böckeler en thoughtworks) arrancan con una spec escrita antes del código en cada cambio, y la spec es la verdad. Si un cambio chico va sin spec ya no es sdd por ninguna definición, y eso justamente es lo que hace odd. y si sdd "lean" como muchos llaman, pasa a ser un "a veces escribo requisitos antes de codear" el termino ya no define nada, un prd o un issue bien escrito también serian sdd entonces.
Lo de que depende de como lo usen expone el problema. Porque si el método anda solo cuando cada equipo sabe que pasos saltearse y el modelo obedece unos templates, entonces todo depende de la buena voluntad del pueblo. En ODD eso lo decide el runtime, el harness controla delegaciones, ediciones, subagentes y verificadores.
Y ya les digo que vibecoding no es, vibecoding es aceptar código sin entenderlo ni verificarlo, es hacer un "lo que Dios quiera". ODD te pide autorización explicita, test en rojo antes del fix, riesgo declarado, verificación proporcional y la entrega la decide un humano.
Specs escribe cuando hacen falta, y solo según si el problema se entiende, su riesgo y si el trabajo se puede retomar desde el git diff, nunca por tamaño. Las historias de usuario siguen siendo clave, lo que cambia es que la verdad esta en el código verificado con la suite en verde.
Y además lo medimos internamente, el bug de 3 lineas paso de 335s a 77s y si en tu equipo ya armaron sus skills para hacerlo mas "lean", buenísimo, vamos para el mismo lado (y de paso ODD puede agarrarlos y hacerlos suyo para trabajar). Yo le puse nombre y lo metí en el runtime, es así.
Espero que haya sacado algunas dudas, mis locuritas cósmicas.
BREAKING: 🇦🇷 BUENOS AIRES, ARGENTINA JUST REVEALED THE NEWEST STATUE OF #BITCOIN CREATOR SATOSHI NAKAMOTO
THIS IS THE LARGEST SATOSHI MONUMENT IN THE WORLD
HONORING THE GREATEST INVENTOR OF ALL TIME
BEAUTIFUL 🧡
Bitcoin whitepaper purists should note that the following things are NOT described in the whitepaper:
script
multisig
block size
addresses
ASIC mining
mining pools
21M coin cap
decentralization
8 decimal precision
2016 block difficulty adjustment
and much, much more...
Satoshi Nakamoto published the Bitcoin whitepaper 18 years ago today. If you've never read it, check out this annotated version: https://t.co/fLLq9VKqmS
The FBI is releasing information advising the Democratic People's Republic of Korea (North Korea) was responsible for the theft of more than $6 billion USD in virtual assets from cryptocurrency exchange, Binance, on or about October 29, 2026. The FBI refers to this specific North Korean malicious cyber activity as "TraderTraitor."
The FBI, together with partners at the USSS and IRS-CI, has observed TraderTraitor actors converting stolen assets primarily into Ethereum (ETH). It is expected these assets will then be further laundered by converting them using DeFi and instant swap services as they prepare them for further laundering stages.
How You Can Help:
FBI, USSS, and IRS-CI are urging private sector entities including THORNode operators, RPC node operators, instant exchanges, DeFi services, blockchain analytics firms, and other virtual asset service providers to block transactions with or derived from addresses TraderTraitor actors are using to launder these stolen assets.
A list of addresses associated with this activity is available here: https://t.co/g0oIWx0WeD
HISTORY: 18 years ago today, Satoshi Nakamoto officially published the #Bitcoin white paper.
The blueprint for the first true digital cash.
Today it’s a $1.6 trillion reserve asset held by nations
Watch the full journey 🔥
Great line from the CTO of Proton. I’m paraphrasing and stealing it :
Your job is not to use agents to help you write code. Your job is to lead the agents to help them write code.
¿Windows, macOS o Linux para programar en 2026?
La IA y la nube amplían las opciones, pero la compatibilidad, el hardware y los costos siguen importando.
Comparto una guía para elegir según el proyecto.
¿En qué entorno trabajás? https://t.co/kamNPa1PjT
Ya tenemos la foto completa del hackeo de Binance. Y es mucho peor de lo que se contó anoche: 6.300 millones de dólares. El mayor robo de la historia de las criptomonedas. Cuatro veces el de Bybit.
Os explico lo que ha pasado, porque la historia es de película.
No reventaron ninguna clave privada. Hackearon el portátil de UN ingeniero de Binance. Desde ese portátil accedieron a un contenedor interno del sistema y empezaron a firmar retiradas como si fueran la propia Binance. En una sola transacción contra una de las hot wallets había 50 autorizaciones firmadas. El atacante no rompió la caja fuerte: se sentó en la silla del empleado que tiene la llave.
Resultado: vaciaron hot wallets en DIEZ blockchains a la vez. 200.630 ETH y 185 tokens en Ethereum, 18.270 bitcoins, 233 millones de XRP, más Solana, Tron, Avalanche... La mayor parte de los 6.300 millones salió en apenas 20 minutos.
El detalle que parece escrito por un guionista: dos días antes, Binance había anunciado que acababa de repeler una campaña de hackers de Corea del Norte que usaban falsas entrevistas de trabajo para colar malware. Repelieron el asalto a la puerta y entraron por la ventana del empleado. Hoy TRM Labs y Chainalysis atribuyen el ataque "con alta confianza" a TraderTraitor, la unidad norcoreana del grupo Lazarus. Los mismos de Bybit. Han cuadruplicado su propio récord en 20 meses.
La contraofensiva también ha sido histórica: en menos de 12 horas se han congelado unos 3.000 millones. Tether bloqueó más de 1.500, Circle 823, Ripple unos 200 en RLUSD, y hasta Coinbase, el mayor competidor de Binance, se ofreció a ayudar bloqueando envíos a las direcciones del hacker. La mitad del botín ya está muerto. La otra mitad, en Bitcoin y Ethereum que nadie puede congelar, se está lavando ahora mismo en cadenas de transferencias cada vez más pequeñas.
Binance ha suspendido las retiradas mientras revisa sus sistemas, asegura que los fondos de los usuarios serán cubiertos al completo, y espera reabrir en unas 48 horas. Ese será el verdadero momento de la verdad: el día que reabran, veremos si la confianza aguanta.
Y una reflexión final: el mayor hackeo de la historia no ha tocado la criptografía. Ha tocado a una persona. Las blockchains funcionaron perfectamente. El eslabón débil sigue siendo el mismo de siempre.
Something that the world is quickly learning in the age of AI:
If something can be hacked, it will be hacked.
This week has been a prime example of this.
Security has never been more crucial than it is now