J’aime mes anecdotes au point. Jeu vidéo, musique et linguistique française. En ce moment, je file un coup de louche à @leCNJV (& @PuissanceZelda à l’occasion).
@GeorgesArzou@Fabien_Mikol Il avait été plus évasif que ça : « J’ai eu recours çà et là à des outils pour des recherches, s’agissant notamment des idiomes étrangers. »
https://t.co/dGcQ3GApCh
@Fabien_Mikol@SamuelFitouss10@enraje Je pense qu’une partie de l’explication est la répercussion sur nos exigences des efforts cognitifs que l’on doit consentir pour éprouver un contenu (lire > écouter de la musique).
@Fabien_Mikol Posture peu étonnante compte tenu des grosses ventes du livre, mais irrespectueuse envers leurs lecteurs. Quand tu affiches une politique éditoriale « no AI » (https://t.co/Rjmp6z33Mg) et que le doute est aussi fort, la prudence devrait l’emporter.
@Fabien_Mikol Dans ce logiciel, que je connais très bien, les corrections sont des corrections (sans traces de LLM), et les reformulations une fonctionnalité à part. Délibérément ou non, quand elle dit qu’elle n’a pas validé ça, elle ment.
Bon puisque pas mal de monde se pose la question, comment les détecteurs anti-IA arrivent à être relativement fiable aujourd’hui ?
Trois facteurs principalement :
*Les modèles de langue (dit “de base”) sont d’abord entraînés sur des milliards de textes en ligne (ce qui n’est pas tout ce qui existe loin de de là, mais quand même des sources assez diverses). C’est ce qu’on appelle le pre-training. Mais ensuite les dernières phases d’entrainement (le “post-training”) reposent sur beaucoup moins d’exemples d’instructions, notamment pour faire en sorte que le modèle génère des conversations et, de plus en plus, des séquences de travail avec des traces de raisonnement (“interleaved reasoning”). Les laboratoires d’IA imposent ici un style assez spécifique, notamment pour faciliter l’alignement des modèles et potentiellement économiser les coûts de génération. Typiquement la dernière version d’Opus utilise un raisonnement beaucoup plus compact. Les dernières méthodes d’entrainement notamment par reinforcement learning tendent aussi à faire émerger un style d’écriture nettement plus artificiel voir torturé, qu’on voit assez bien dans les traces de raisonnement des derniers modèles d’OpenAI, parce que la génération du texte vise avant tout à résoudre des problèmes, plus qu’à communiquer avec l’utilisateur.
*Les modèles s’entrainent de plus sur des contenus générés, simplement parce qu’on manque de données pour décrire l’accomplissement de tâches souvent non écrites, mais aussi pour des questions de coûts. Il y a plein de débats en ce moment sur la légitimité de la distillation de modèles principalement issus d’Anthropic ou d’OpenAI (en principe interdit par les conditions d’utilisation mais pas clair du tout s’il y a vraiment une base légale pour ça, notamment en dehors des États-Unis). La conséquence pratique c’est que la plupart des modèles se ressemblent aujourd’hui. C’est ce qui permet à Pangram de fonctionner à l’échelle : il y a un style généré “mainstream” relativement facile à identifier, quasiment quel que soit le modèle utilisé. D’autant que cet entraînement synthétique se fait de plus à plus à l’échelle au cours de la phase de pré-entraînement : mêmes les modèles de base génèrent du texte de moins en moins divers.
*La régulation en train d’arriver (notamment via l’AI Act) va imposer l’identification des contenus d’IA (ou “watermarking”). Concrètement, au moment de la génération, les modèles vont adopter une certaine combinaison statistique de lettres. Cela fait déjà plusieurs années que l’on discute de techniques mais toute la difficulté est de les employer sans détériorer les capacités des modèles. A priori Anthropic y serait parvenu et je pense que cela va devenir un standard dans l’industrie. À la différence de Pangram, l’identification ne repose pas sur modèle de classification mais sur une analyse déterministe du texte. Seulement, seul Anthropic en a le recette pour l’instant.
Je pense que ce sera un problème essentiellement réglé dans les années à venir : il y a une demande sociale forte pour l’identification des contenus générés et les dernières techniques d’entraînement, reposant de plus en plus sur la donnée synthétique, en facilitent grandement la mise en œuvre.
@CyrLav22757 @MrSam144 Si cela est arrivé pour le sampling, c’est parce que la technique a intrinsèquement modelé les résultats d’une matière inédite. S’en tenir à générer des mots par I.A. ne permettra pas une telle novation. Pourquoi serait-elle indispensable à un genre qui en émergerait ?
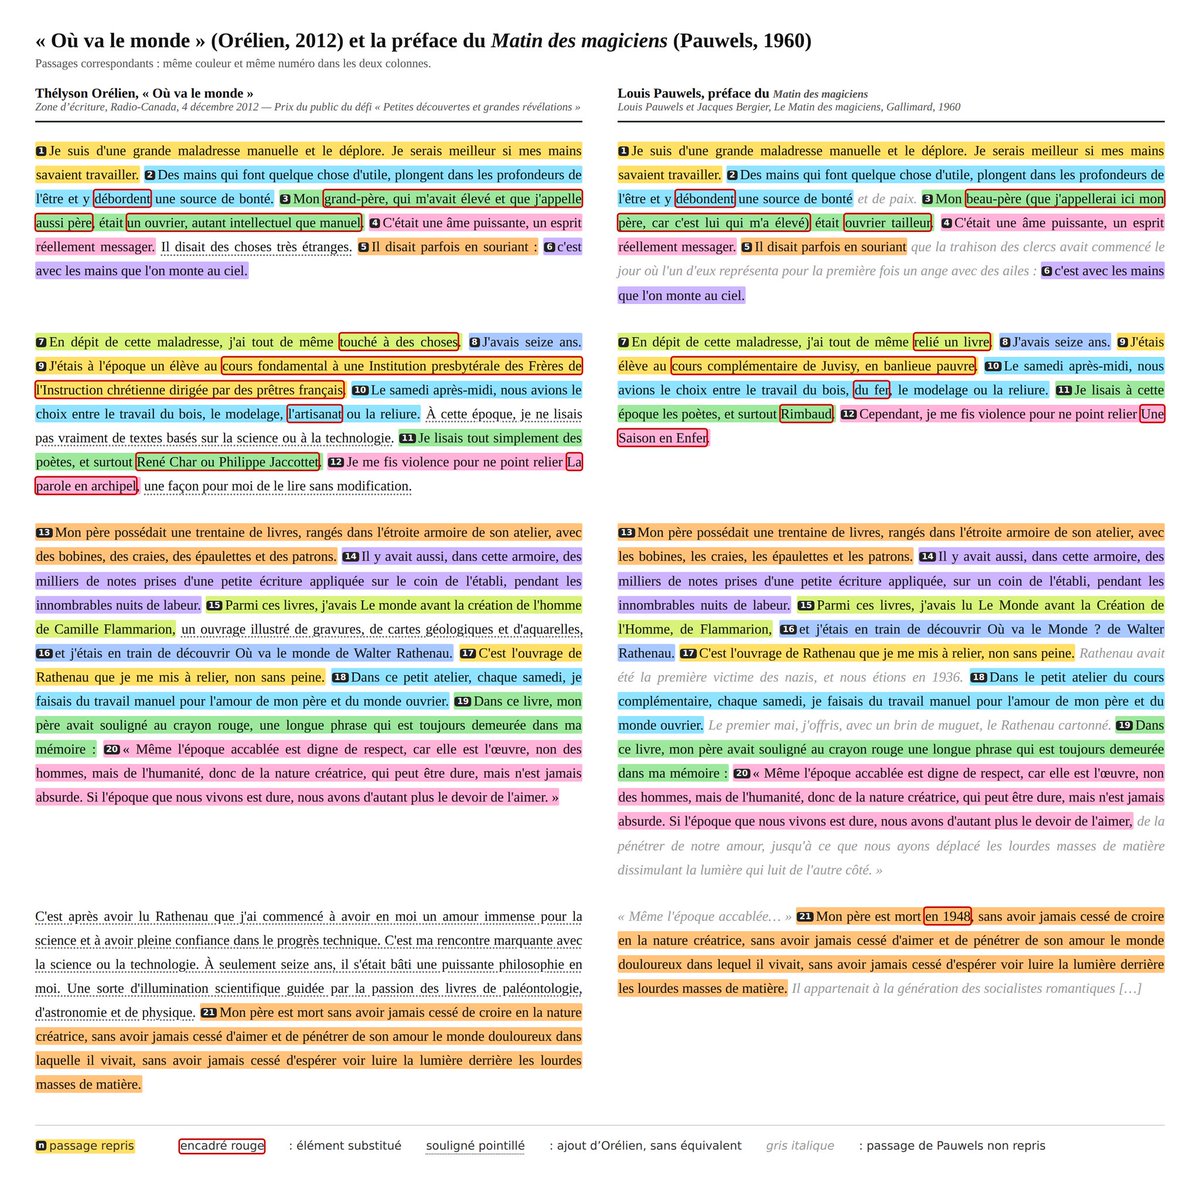
En 2014 Orélien reçoit le prix du public de Radio-Canada pour sa nouvelle "Où va le monde".
Nouvelle est entièrement plagié d'un texte de Louis Pauwels de 1960. Cette fois, on a bien du plagiat *sur un texte littéraire*. J'espère que ça permettra aux éditeurs de sortir du déni.
@MrSam144 Comment ça, « le meilleur » ? Une chose, en tout cas : le sampling est au fondement de certains genres musicaux (hip-hop, « jungle »), indissociable d’autres (« future funk », « vaporwave »), et même inhérent à certains (« plunderphonics », « sampledelia »).
@Fabien_Mikol Je continue de penser régulièrement que là peut-être qu’il va y avoir un ralentissement, mais encore, et encore, et encore… Délirant. (Merci pour la veille, je viens souvent voir les nouvelles publis sur ton compte.)