PhD in EE, former AI researcher, now in strategic planning. I aim to spot and share the changes that advancing technology will bring - before they arrive.
[Alan] 11/23(월) 아침 AI 테크 브리핑
2026년 11월 23일 (월), 최근 약 24시간
오늘의 3가지 핵심
1. OpenAI 수석과학자 Jakub Pachocki가 사내 모델의 학습 성적을 처음 공개하고, 연구소들이 다 같이 지킬 개발 한도를 정하자고 제안했습니다. Sam Altman은 OpenAI가 최근 내놓은 글 가운데 가장 중요하다고 힘을 실었습니다.
2. Dell, HPE, Lenovo, Supermicro가 이미 계약한 AI 서버 값을 최대 45% 올려 달라고 요구하고 있습니다. 메모리 값이 2024년 초보다 400% 넘게 올랐기 때문이라고 FT가 보도했습니다.
3. Tesla가 FSD v15에 월드 모델을 써서 바깥 풍경을 실시간 영상으로 그려 주는 Reality View를 넣었습니다. 월드 모델은 주변 장면을 예측해 그려 내는 AI입니다. Elon Musk는 다음 세대 AI5 칩을 차보다 Optimus 로봇에 먼저 쓰겠다고 밝혔습니다.
1. AI 에이전트, 개인 봇
- 에이전트끼리 일을 맡기고 돈을 주고받으려면 상대 에이전트가 믿을 만한지부터 알아야 합니다. Visa Crypto Labs를 이끄는 Cuy Sheffield는 11월 22일(현지) 에이전트 지갑 Visa CLI 새 버전을 미국 사용자에게 시범 서비스로 내놓았습니다. 사용자가 자기 Visa 카드로 에이전트를 인증하면 Visa의 에이전트 명부에 이름이 올라가고, 이 에이전트는 작업 장터 Taskmarket에서 영상 제작이나 설문 응답 같은 유료 작업을 맡아 디지털 화폐 OUSD로 대가를 받습니다. Visa는 이미 전 세계 결제 수단 약 50억 개를 관리하고 있어서, 카드 인증이 에이전트의 신분증으로 쓰이면 에이전트끼리 결제할 때도 수수료를 받게 됩니다. 스타트업이 만든 에이전트 결제 규격보다 카드사의 인증 체계가 먼저 표준으로 자리 잡을 것으로 봅니다.
https://t.co/beW9CbLdcs
https://t.co/csHPaeBh8m
- Bloomberg의 Mark Gurman은 11월 22일(현지) 뉴스레터 Power On에서 Apple이 AI 에이전트 경쟁에서 뒤처질 수 있다고 썼습니다. Apple은 운영체제의 주요 기능을 출시 1년 전쯤 미리 정해서, 경쟁사들이 에이전트 기능을 매주 고치는 동안 일정을 바꾸기 어렵습니다. Apple도 앱을 오가고 웹을 검색하고 코드를 짜는 맥용 에이전트를 만들고 있지만, Gurman은 2027년 말 이전에는 나오기 어렵다고 내다봤습니다. 에이전트는 쓸수록 사용자의 계정과 업무 기록이 쌓여서 바꾸기 어렵기 때문에, 맥과 아이폰 사용자의 일상 업무를 OpenAI와 Google 에이전트가 먼저 차지할 수 있다고 봅니다.
https://t.co/S3D69xokMn
https://t.co/03esLernRV
2. 피지컬 AI, 로봇
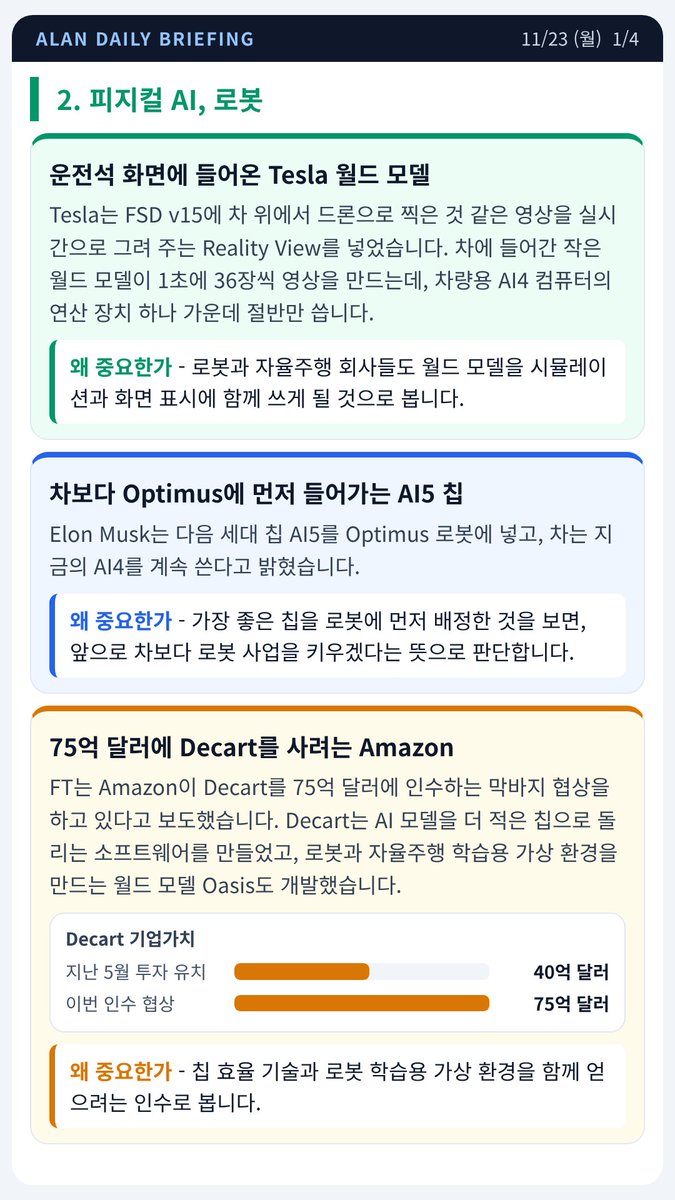
- 월드 모델은 지금 보이는 장면을 보고 다음 장면이 어떻게 바뀔지 예측해 그려 내는 AI입니다. Tesla는 11월 21일(현지)부터 FSD v15를 배포하면서, 차 위에서 드론으로 찍은 것 같은 영상을 실시간으로 그려 주는 Reality View를 넣었습니다. Musk는 Tesla가 지난해부터 학습용 가상 주행 영상을 만드는 큰 월드 모델을 써 왔다고 설명했습니다. 차에는 이 모델의 작은 버전이 들어가는데, 운전 판단에 쓰는 카메라 해석 결과를 받아 1초에 36장씩 영상을 만든다고 했습니다. 이 작업에는 차량용 AI4 컴퓨터의 연산 장치 하나에서 절반만 씁니다. Epic Games CEO Tim Sweeney는 실제 서비스에서 월드 모델이 게임 엔진을 크게 앞선 첫 사례라고 평가했습니다. 로봇과 자율주행 회사들도 같은 모델을 시뮬레이션과 화면 표시에 함께 쓰게 될 것으로 봅니다.
https://t.co/pshGqqNMfS
https://t.co/KoNXYRghow
https://t.co/b30T0Vhgx1
- Musk는 11월 22일(현지) X에서 다음 세대 칩 AI5는 Optimus 로봇에 들어가고, 차는 지금의 AI4를 계속 쓴다고 밝혔습니다. AI4만으로도 사람보다 운전을 잘할 수 있기 때문이라고 했습니다. 같은 날 메모리와 저장장치 값이 올라서 AI4 원가가 두 배가 됐다고도 밝혔습니다. 로봇이 일하는 공장과 집에서는 처음 보는 물건과 상황이 계속 나오기 때문에 가장 좋은 칩을 로봇에 먼저 배정한 것으로 보이고, Tesla가 앞으로 차보다 로봇 사업을 키우려 한다고 판단합니다.
https://t.co/goA3djgbQY
https://t.co/5ejaOr1k8e
- Amazon이 2023년 세워진 AI 스타트업 Decart를 75억 달러에 인수하는 막바지 협상을 하고 있다고 FT가 11월 21일(현지) 보도했습니다. 빠르면 이번 주 초에 합의가 나올 수 있습니다. Decart의 기업가치는 지난 5월 투자를 받을 때 40억 달러였습니다. Decart는 AI 모델을 더 적은 칩으로 돌리는 소프트웨어를 만들었고, 로봇과 자율주행 시스템을 학습시킬 가상 환경을 만드는 월드 모델 Oasis도 개발했습니다. AWS는 이 인수로 자체 칩 Trainium의 효율을 높이는 기술과 로봇 학습용 가상 환경 기술을 함께 얻게 될 것으로 봅니다.
https://t.co/jOMw91ACWB
https://t.co/3HJxwY1Ez2
3. 과학, 공학 AI
- 중국 Ant그룹의 AI 조직 Ant Ling이 11월 22일(현지) 의료 특화 모델 LingSante-3.1-flash를 누구나 내려받아 쓸 수 있게 공개했습니다. 전체 매개변수는 5,600억 개지만 단어 하나를 만들 때마다 250억 개만 골라 쓰는 구조여서 돌리는 비용이 낮습니다. Ant Ling은 의료 전문 업무 시험 HealthBench Professional에서 65.72점을 받아 GPT-6 Astra, Claude Opus 5.5, Gemini 4 Argon을 모두 앞섰다고 밝혔습니다. 병원은 환자 정보를 밖으로 내보내기 어려운데, MIT 라이선스로 공개된 모델은 자기 서버에 직접 설치해 쓸 수 있습니다. 의료 AI 시장에서는 성능만큼이나 병원 전산 시스템에 쉽게 붙는지가 모델 선택을 좌우할 것으로 봅니다.
https://t.co/ynRmtcVZSR
https://t.co/2wudJHui9l
- SAT 문제는 참과 거짓 조건 수천 개를 한꺼번에 만족하는 답을 찾는 문제입니다. 반도체 회로 검증 같은 공학 문제를 이 형태로 바꿔 푸는 경우가 많습니다. 개발자 Luke Hutchison은 11월 21일(현지) 15년 전 5년을 들여 만든 SAT 풀이 코드를 Google의 Gemini 4 Neon에 맡기자, 5분도 안 돼 새 풀이기 Frobenius가 나왔다고 밝혔습니다. Hutchison이 직접 시험해 보니 Frobenius는 기존 최고 풀이기보다 평균 수천 배 빨랐습니다. Hutchison은 4월 SAT 풀이기 대회에 내보낼 때까지 코드를 공개하지 않을 계획입니다. 사람이 방향을 잡고 AI가 구현과 최적화를 맡는 방식이 공학 소프트웨어 개발에도 퍼질 것으로 봅니다.
https://t.co/oAbdOE6GjF
- 도쿄대와 RIKEN 연구진이 우리 은하를 별 하나하나 단위까지 나눠 계산한 시뮬레이션 PHEASANT를 11월 22일 소개했습니다. 초신성 주변 가스는 아주 빨리 변해서 100년 단위로 잘게 계산해야 합니다. 연구진은 10만 년 뒤 가스 분포를 한 번에 예측하는 AI 모델을 넣어 이 계산을 대신했고, 시뮬레이션이 약 20배 빨라졌습니다. AMD, Intel, NVIDIA 칩을 섞어 쓰는 슈퍼컴퓨터 세 대에서 모두 돌아가도록 프로그램도 고쳤습니다. 계산이 가장 많이 드는 부분만 AI 예측으로 바꾸는 방식은 연소, 충돌, 기후 같은 공학 시뮬레이션에도 쓸 수 있다고 봅니다.
https://t.co/bmjTMZpDNV
4. AI 인프라, 반도체
- FT는 11월 22일(현지) Dell, HPE, Lenovo, Supermicro가 몇 달 전 계약한 NVIDIA 기반 AI 서버 값을 납품 직전에 최대 45% 올려 달라고 요구하고 있다고 보도했습니다. JPMorgan은 메모리 원가가 2024년 초보다 400% 넘게 올랐다고 추정했습니다. 영국 트레이딩 회사 XTX Markets는 서버 값을 5억 4,900만 달러로 고정했는데도 Dell이 6,200만에서 7,000만 달러를 더 요구했다며 아일랜드 법원에 소송을 냈습니다. 서버 회사가 오른 메모리 원가를 서버 값에 얹으면, 메모리 값이 올라 생기는 이익은 삼성전자, SK하이닉스, Micron이 가져갑니다. 반면 자금 여력이 작은 클라우드 회사와 AI 스타트업은 데이터센터 증설을 늦출 것으로 봅니다.
https://t.co/pXzv1rxAqx
https://t.co/WVfdjBed5H
- Jensen Huang은 11월 12일 사생활 논란 끝에 NVIDIA CEO에서 물러났고, 미국 정부는 NVIDIA 칩이 수출 통제를 피해 중국으로 들어갔는지 조사하고 있습니다. Scott Bessent 재무장관은 11월 22일(현지) CBS Face the Nation에서 NVIDIA의 답을 아직 받지 못했다고 말했습니다. Trump 대통령은 Huang이 돌아와야 한다고 했지만, Bessent는 회사에서 누가 어느 직급까지 수출 규정 위반을 알고 있었는지부터 밝혀야 한다고 답했습니다. 재무부는 11월 25일까지 답하라고 했고, 이날 NVIDIA가 내놓는 답에 따라 HBM을 공급하는 한국 메모리 회사 주가도 움직일 것으로 봅니다.
https://t.co/HLe4pHbQYO
https://t.co/aWZMEncue6
https://t.co/sOaBjCskrz
- 삼성전자와 SK하이닉스는 3분기에 사상 최대 실적을 냈지만, 주가는 고점의 절반 수준까지 떨어졌습니다. 중앙일보는 11월 22일 두 회사의 분기보고서를 보면 고객이 이미 여러 곳으로 늘고 있다고 짚었습니다. SK하이닉스 매출에서 NVIDIA로 추정되는 최대 고객 비중은 1년 전 27%에서 올해 1월부터 9월까지 14.8%로 낮아졌고, 삼성전자 5대 매출처에는 Alphabet과 Amazon이 들어갔습니다. 반면 SemiAnalysis는 2028년 HBM 수요 전망을 약 30% 낮췄습니다. 이제 시장은 매출이 NVIDIA 한 곳에 몰리는 것보다 2028년 이후 데이터센터 투자 속도를 더 걱정하고 있다고 봅니다.
https://t.co/f2MWCzKRkW
5. 프런티어 모델, 연구소
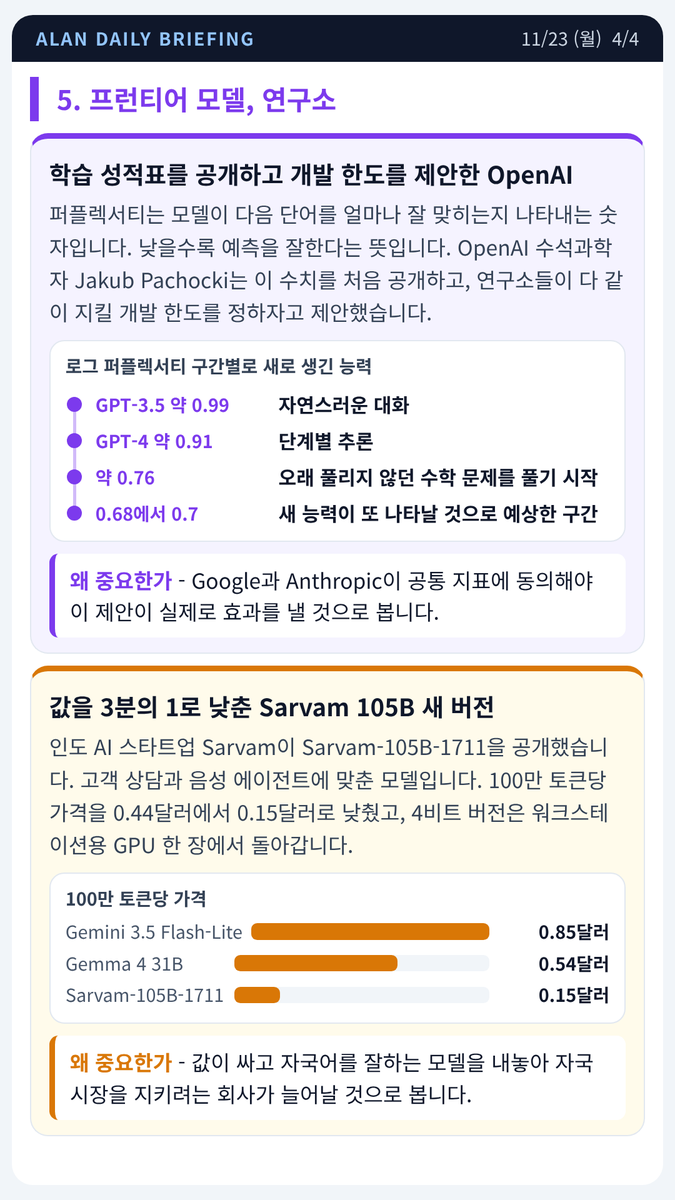
- 언어 모델은 다음 단어를 맞히도록 학습하고, 이를 얼마나 잘하는지 나타낸 숫자가 퍼플렉서티입니다. 낮을수록 예측을 잘한다는 뜻입니다. OpenAI 수석과학자 Jakub Pachocki는 11월 22일(현지) 글 'Perplexity and Intelligence'에서 GPT-3.5 이후 OpenAI 모델의 이 수치를 처음 공개했습니다. 로그 퍼플렉서티가 GPT-4의 약 0.91에서 약 0.76까지 내려오자 모델이 오래 풀리지 않던 수학 문제를 잇달아 풀기 시작했다고 설명했습니다. Pachocki는 AI의 행동을 감시하는 기술이 개발 속도를 따라올 때까지 연구소들이 넘지 않을 개발 한도를 함께 정하자고 제안했습니다. Sam Altman은 이 글을 OpenAI가 최근 내놓은 글 가운데 가장 중요하다고 평가했습니다. Google과 Anthropic이 공통 지표에 동의해야 이 제안이 실제로 효과를 낼 것으로 봅니다.
https://t.co/o8OP3zY5NE
https://t.co/qegiC3cZEo
- 인도 AI 스타트업 Sarvam이 11월 22일(현지) 105B 모델의 새 버전 Sarvam-105B-1711을 누구나 내려받을 수 있게 공개했습니다. 고객 상담과 음성 에이전트처럼 많은 양을 싸게 처리해야 하는 일에 맞춘 모델입니다. 100만 토큰당 가격을 0.44달러에서 0.15달러로 낮췄는데, 점수가 비슷한 Gemini 3.5 Flash-Lite 가격의 5분의 1 수준입니다. 은행과 정부 기관이 GPU 한 장으로 자기 건물 안에서 모델을 돌릴 수 있으면 데이터를 해외로 보내지 않아도 됩니다. 값싸고 자국어를 잘하는 모델을 내놓아 자국 시장을 지키는 전략이 인도와 중동, 동남아의 AI 기업에 퍼질 것으로 봅니다.
https://t.co/hhUJNUXEGp
https://t.co/aNVXgKqimB
오늘의 Takeaway
어제 나온 소식들을 이어 보면 AI 산업의 병목이 칩에서 메모리로 옮겨 가고 있다고 판단합니다. 서버 회사는 계약한 값을 다시 올리고 있고, Tesla 차량용 컴퓨터 원가는 메모리 값 때문에 두 배가 됐습니다. 이렇게 연산이 비싸지자 같은 칩으로 더 많은 일을 하는 기술의 값어치가 올랐습니다. Amazon은 칩 효율을 높이는 Decart에 75억 달러를 내려 하고, Sarvam은 추론 효율을 높여 모델 사용료를 3분의 1로 낮췄습니다.
모델 경쟁에서는 OpenAI가 안전 기준을 앞세워 판을 다시 짜려는 것으로 보입니다. 이번 주 AI 주가는 퍼플렉서티를 공통 지표로 삼자는 제안에 경쟁 연구소들이 응할지, 11월 25일 NVIDIA가 미국 재무부에 어떤 답을 내놓을지에 따라 움직일 것으로 봅니다.
#AI #OpenAI #Tesla #NVIDIA #SK하이닉스 #삼성전자 #월드모델 #반도체
This is the most important thing OpenAI has published in awhile.
We are providing a lot of transparency into our pretraining progress and hope we can agree as a frield to common limits. I think that would be very wise and help ensure safety and control.
반도체 P->Q 전환 네러티브의 핵심은 수요의 꾸준한 증가와 공급 확대였다.
그러나 자본이 병목이 되는 순간, P를 크게 낮추지 않으면 Q가 충분히 늘기 어려운 상황이 되었다.
그리고 중간선거 이후 수요가 굳건하고 자본을 확충했다 하더라도 ‘물리적’으로 AIDC를 지을 수 있냐로 질문이 넘어왔다.
AIDC 확대 계획이 가시화되고, 매출로 회사가 굴러가는 상황이 와야 한다.
P != NP 가 뭐길래 이렇게 소란일까?
우선 많은 사람들이 P = NP 문제라고 하는데, P != NP 일 가능성이 조금 더 높다.
여기서 P(Polynomial time) 는 컴퓨터가 다항 시간 안에 풀수 있는 문제들을 의미하는데, 쉽게 말해 입력 (n)이 늘어날 때, 답을 찾기 위한 연산이 n^2 이나 n^3 처럼 다항식으로 표현이 되어야 한다. 대표적으로 '숫자 정렬하기' 같은 문제를 생각하면 된다.
NP(Nondeterministic Polynomial time) 은 비결정적 다항 시간 문제로 '답이 주어졌을 때, 그것을 다항시간 안에 검증할 수 있는 문제'를 의미한다. 풀수 없다는 것도 아니고, 무조건 지수 시간이 걸리는 것도 아니다. 참고로 P 문제는 모두 NP에 속한다.
다시말해 NP 문제의 기준은 '어려운지?' 가 아니라 'Yes/No'를 다항 시간 안에 대답할 수 있냐?' 로 봐야 한다.
쉬운 예로는 "서울에서 부산까지 400km 이하로 가는 경로가 있는가?" 같은 문제이다. a* 같은 알고리즘을 통해 두 지점을 연결하는 최단 경로를 찾을 수 있으며, 그것이 400km 이하인지 쉽게 대답 가능하다.
NP-complete 과 NP-hard 문제도 있다.
NP-complete은 NP 문제들 중 어려운 문제들로, 지금까지 알려진 방법으로 최악의 경우 지수시간이 걸리는 문제 (2^n 등)이다.
NP-hard는 NP의 모든 문제보다 어렵다는 의미로 NP가 아닌 문제 (Yes/no 로 대답하는게 아닌 문제) 혹은 NP보다 어려운 문제 (주가 예측 🤣 )를 의미한다.
그래서 만약 P = NP 가 증명되면 어떤 의미가 있을까?
그냥 P = NP 임을 증명할 뿐이다. 하루아침에 물류 최적화가 되거나 암호체계가 무너지지는 않는다. 다만 지금 사용하는 것보다 더 효율적인 알고리즘이 어딘가 있음을 말해줄 뿐이다.
(다만 P = NP가 되버리면, 소인수분해와 같은 문제도 P 문제가 되므로, 양자컴퓨터나 쇼어알고리즘의 중요도가 줄어들 수 있다.)
최근 좋은 기회로 유튜브를 찍었는데, 급하게 영상을 내리게 되었다.
촬영 전 재직중인 곳에서 사전 허가를 받았고, 영상의 내용도 일반적인 기술 동향에 관한 것(그리고 내 상상)일 뿐, 영업기밀이나 회사 내부 정보는 전혀 이용하지 않았다. 소속과 무관한 내 생각임도 고지했다.
그럼에도, 일단 방송이 나가자 회사 내 많은 분들이 보게 되었고 운영팀으로 수많은(??)민원이 들어왔다. 특히 본부 내 구성원들이 신고를 많이 했다고 한다.
결국 촬영 허가를 해준 분도 우선 영상을 내리는게 좋겠다고 하셨다.
다시금 우리 사회는 개인을 집단의 일원으로서만 받아들인다는 것을 배운다. 내 이름 앞에는 항상 소속이, 뒤에는 직급이 붙는다. 내 퇴근 후 삶도 직장에서 완전히 자유로울 수 없다. (이래서 전문직이 좋은거 같다.)
차주 운영팀과 논의 후 가능하다면 영상을 다시 살려보고싶다. 그러나 얼마나 잘 될지는 모르겠다.
이런 대외 활동을 허용하는 곳이 있다면 그곳으로 옮기고 싶다. (사내라도)
+ 잘 봤다고 같이 밥먹자는 분들도 있다.
@Scobleizer Tesla has Niagara Falls amounts of data. So much, that we will keep much less than a millionth of it. Unless the data is of a super weird, long tail event, it’s irrelevant.
최근 좋은 기회로 유튜브를 찍었는데, 급하게 영상을 내리게 되었다.
촬영 전 재직중인 곳에서 사전 허가를 받았고, 영상의 내용도 일반적인 기술 동향에 관한 것(그리고 내 상상)일 뿐, 영업기밀이나 회사 내부 정보는 전혀 이용하지 않았다. 소속과 무관한 내 생각임도 고지했다.
그럼에도, 일단 방송이 나가자 회사 내 많은 분들이 보게 되었고 운영팀으로 수많은(??)민원이 들어왔다. 특히 본부 내 구성원들이 신고를 많이 했다고 한다.
결국 촬영 허가를 해준 분도 우선 영상을 내리는게 좋겠다고 하셨다.
다시금 우리 사회는 개인을 집단의 일원으로서만 받아들인다는 것을 배운다. 내 이름 앞에는 항상 소속이, 뒤에는 직급이 붙는다. 내 퇴근 후 삶도 직장에서 완전히 자유로울 수 없다. (이래서 전문직이 좋은거 같다.)
차주 운영팀과 논의 후 가능하다면 영상을 다시 살려보고싶다. 그러나 얼마나 잘 될지는 모르겠다.
이런 대외 활동을 허용하는 곳이 있다면 그곳으로 옮기고 싶다. (사내라도)
+ 잘 봤다고 같이 밥먹자는 분들도 있다.
BREAKING: Tesla has just announced that FSD V15 is now starting to roll out!
Here's what's new:
• 25x better handling of safety critical cases
• Tesla Reality View : Adds a live visualization of the drive that lets you see & control what FSD is planning to do.
• Navigation for start & end of the trip now learns end-to-end from fleet route preferences. Later v15 releases will expand this to the entire route.
•Better detection of signs, animals, debris, potholes and standing water, plus more natural speed handling in school zones and inclement weather.
• FSD can now slow for speed cameras & Bike Rack Mode lets you enable FSD w/ bike racks or similar hitch accessories
It's finally here!
"We do not see customers being able to get out of it."
메모리에 대한 센티먼트가 얼마나 안좋냐면, TomorrowX Summit에서 Micron CEO 인터뷰를 보는 사람조차 없다.
업로드 하루 지난 지금 조회수가 2k 수준...
(참고로 일론 인터뷰는 384K다 ㅎㅎ)
아래는 인터뷰 주요 내용 인용
수요와 공급
"Demand remains robust for our business. Supply continues to be tight. Pricing environment is constructive for our business."
(수요는 여전히 견조하고, 공급은 계속 빡빡하며, 가격 환경도 우호적이다.)
"We have said before that calendar year 2027 and 2028 will be even tighter than 2026. 75% of our 2027 is sold out. We are in discussions with customers now moving to 2028."
(2027년과 2028년은 2026년보다 더 빡빡할 것이다. 2027년 물량의 75%가 이미 팔렸고, 지금은 2028년 물량을 고객과 논의하고 있다.)
"The frontier models as they get larger, agentic AI usage, larger context windows, all of this just needs more memory and storage."
(프론티어 모델이 커지고, 에이전트 AI 사용이 늘고, 컨텍스트가 길어지면서 모두 더 많은 메모리와 스토리지가 필요하다.)
"We delivered a record 2026, 2027 is going to be even stronger."
(2026년은 사상 최고 실적이었고, 2027년은 더 강할 것이다.)
메모리가 중요한 이유
"Compute performance has continued to advance a lot more compared to the memory bandwidth. So, a processor in an AI system is many times sitting idle... because it is waiting for data to be fetched from memory."
(연산 성능이 메모리 대역폭보다 훨씬 빠르게 발전해서, AI 시스템의 프로세서는 메모리에서 데이터를 기다리느라 노는 경우가 많다.)
"It was all about memory price and volume, whereas today, the dialogue with our customers is about performance."
(예전에는 메모리 가격과 물량이 전부였지만, 지금 고객과의 대화는 성능에 관한 것이다.)
장기공급계약(SCA)
"In the past, LTAs would be one-year agreements. They would be based on customer forecast... SCAs are multi-year agreements. Many of these SCAs are five-year agreements with the customers."
(예전 장기계약은 고객 전망에 기반한 1년짜리였다. SCA는 다년 계약이고, 상당수가 5년짜리다.)
"SCAs are not just five years. SCAs get extended multiple years in advance."
(SCA는 5년으로 끝나지 않고, 몇 년 앞서 미리 연장된다.)
"These SCAs also have take-or-pay, robust take-or-pay provisions. SCAs have cash deposits and financial commitments by our customers. There are 26 SCAs... They have $32 billion of cash and financial commitments upfront."
(SCA에는 강력한 테이크오어페이 조항과 고객의 현금 예치금, 재무 약정이 들어 있다. 체결한 SCA는 26건이고, 선급 현금과 재무 약정이 320억 달러다.)
"Many of these also have pricing bands or fixed pricing, and some of them do not have any pricing at all."
(상당수는 가격 밴드나 고정 가격이 있고, 일부는 가격 조건이 아예 없다.)
"Customers wanted more commitment for supply than we were able to provide to them."
(고객은 우리가 약속할 수 있는 것보다 더 많은 공급 약정을 원했다.)
수요가 꺾이면 고객이 계약을 깨지 않겠냐는 질문에 대해
"We don't see when supply catches up with demand, despite our best efforts and large investments in bringing up new manufacturing capacity."
(최선을 다해 대규모로 생산능력을 늘리고 있지만, 공급이 언제 수요를 따라잡을지 보이지 않는다.)
"In a given compute platform, you put more memory, you put faster memory, you are able to get a higher ROI from that... I absolutely do not expect that any scenarios that you're describing from the past are going to be happening here in the future."
(같은 연산 플랫폼에 메모리를 더 많이, 더 빠르게 붙이면 투자 수익률이 올라간다. 말씀하신 과거 같은 시나리오가 앞으로 벌어질 거라고는 전혀 예상하지 않는다.)
"Those agreements have take-or-pay, they have robust terms. We do not see customers being able to get out of it."
(이 계약에는 테이크오어페이와 견고한 조건이 있어서, 고객이 빠져나갈 수 있다고 보지 않는다.)
적층 D램
"HBM was called a technical marvel. This product absolutely goes even... to the next level."
(HBM을 기술적 경이라고 했는데, 이 제품은 확실히 한 단계 더 나아간다.)
엔비디아
"I am a huge admirer of Jensen... We look forward to continuing to work with the NVIDIA team as they navigate through their leadership transition."
(나는 젠슨을 크게 존경한다. 엔비디아 팀이 리더십 전환을 거치는 동안에도 계속 함께 일하기를 기대한다.)
주주환원
"December 9th is the date when those restrictions expire. We have said excess cash, we will be returning to shareholders."
(12월 9일에 반도체지원법 관련 제약이 풀린다. 남는 현금은 주주에게 돌려주겠다고 말해 왔다.)
"We have every intent and capacity to be providing strong shareholder return starting December 9th."
(12월 9일부터 강한 주주환원을 할 의지와 여력이 충분하다.)
"Investing $250 billion here in U.S., creating 90,000 jobs."
(미국에 2,500억 달러를 투자해 일자리 9만 개를 만든다.)
AI 확산
"Today in the world, one out of five people is using AI. Last year, it was one in 10."
(지금 전 세계 5명 중 1명이 AI를 쓴다. 작년에는 10명 중 1명이었다.)
"AI drug discoveries, about 173+ are already in clinical trials. In 2023, that number was just two dozens."
(AI로 발견한 신약 173개 이상이 이미 임상시험 중이다. 2023년에는 20여 개였다.)
P != NP 가 뭐길래 이렇게 소란일까?
우선 많은 사람들이 P = NP 문제라고 하는데, P != NP 일 가능성이 조금 더 높다.
여기서 P(Polynomial time) 는 컴퓨터가 다항 시간 안에 풀수 있는 문제들을 의미하는데, 쉽게 말해 입력 (n)이 늘어날 때, 답을 찾기 위한 연산이 n^2 이나 n^3 처럼 다항식으로 표현이 되어야 한다. 대표적으로 '숫자 정렬하기' 같은 문제를 생각하면 된다.
NP(Nondeterministic Polynomial time) 은 비결정적 다항 시간 문제로 '답이 주어졌을 때, 그것을 다항시간 안에 검증할 수 있는 문제'를 의미한다. 풀수 없다는 것도 아니고, 무조건 지수 시간이 걸리는 것도 아니다. 참고로 P 문제는 모두 NP에 속한다.
다시말해 NP 문제의 기준은 '어려운지?' 가 아니라 'Yes/No'를 다항 시간 안에 대답할 수 있냐?' 로 봐야 한다.
쉬운 예로는 "서울에서 부산까지 400km 이하로 가는 경로가 있는가?" 같은 문제이다. a* 같은 알고리즘을 통해 두 지점을 연결하는 최단 경로를 찾을 수 있으며, 그것이 400km 이하인지 쉽게 대답 가능하다.
NP-complete 과 NP-hard 문제도 있다.
NP-complete은 NP 문제들 중 어려운 문제들로, 지금까지 알려진 방법으로 최악의 경우 지수시간이 걸리는 문제 (2^n 등)이다.
NP-hard는 NP의 모든 문제보다 어렵다는 의미로 NP가 아닌 문제 (Yes/no 로 대답하는게 아닌 문제) 혹은 NP보다 어려운 문제 (주가 예측 🤣 )를 의미한다.
그래서 만약 P = NP 가 증명되면 어떤 의미가 있을까?
그냥 P = NP 임을 증명할 뿐이다. 하루아침에 물류 최적화가 되거나 암호체계가 무너지지는 않는다. 다만 지금 사용하는 것보다 더 효율적인 알고리즘이 어딘가 있음을 말해줄 뿐이다.
(다만 P = NP가 되버리면, 소인수분해와 같은 문제도 P 문제가 되므로, 양자컴퓨터나 쇼어알고리즘의 중요도가 줄어들 수 있다.)