Not all data pipelines need to run in real time.
Some are better as scheduled batch jobs, others need streaming from the start.
In this tutorial, @balawc27 teaches you the differences between batch and streaming pipelines in Python, and when to use each.
https://t.co/2hDZDcPMe8
Mientras las Fuerzas Militares insisten en que la operación no afectó a la población civil ni se realizó en la vereda. Las autoridades locales y la comunidad del Catatumbo sostienen una versión radicalmente opuesta que apunta a la violación de derechos humanos de la población. https://t.co/mL2RxnmBJV
Parce, esta mañana entrevistaron al Rector de un colegio de Quibdó, le preguntaron señor como vive la población la tragedia?
Respondió:
- “ estamos muy mal, no tenemos agua, casas donde dormir, muchos estan en la calle, anoche fue terrible con la tormenta eléctrica, nadie duerme, los niños lloran y lloran y aparte los colegios quedaron en ruinas, y el señor Presidente está hablando de clases virtuales, yo le pido al nuevo Gobierno que priorice la ayuda humanitaria, incluso atención psicológica para todas las personas afectadas”
Después entrevistaron al Ministro del Interior Rodrigo Lara, que por cierto a la mayoría de Preguntas que le hicieron sobre cifras de muertos, casas afectadas, respondía literalmente “NO TENGO NI IDEA” y le Preguntaron y bueno que sigue para este departamento?
Respondió el ministro:
“ tenemos que priorizar las clases virtuales, voy a llamar a los presidentes de claro y tigo que son amigos personales y les voy a decir que se pongan la 10 con la conexión gratis para el Chocó, voy a gestionar tablets y computadores para estos niños.
Parce, que gonrorrea la desconexión de este gobierno con la gente 😭😭💔💔💔💔
Así quedó el Colegio Carrasquilla.
📍Quibdó, Chocó
NO DEJEMOS DE HABLAR DE CHOCÓ #TerremotoChocó
📊🔍En un mundo donde los datos están por todas partes, aprender a interpretarlos hace la diferencia.
El nuevo sitio de #CulturaEstadística del DANE te ayuda a desarrollar el pensamiento crítico para comprender las cifras, analizarlas y darles contexto.
🌐 Descúbrelo aquí: https://t.co/6BqdDOOQ2c
#DatosMásCercanos
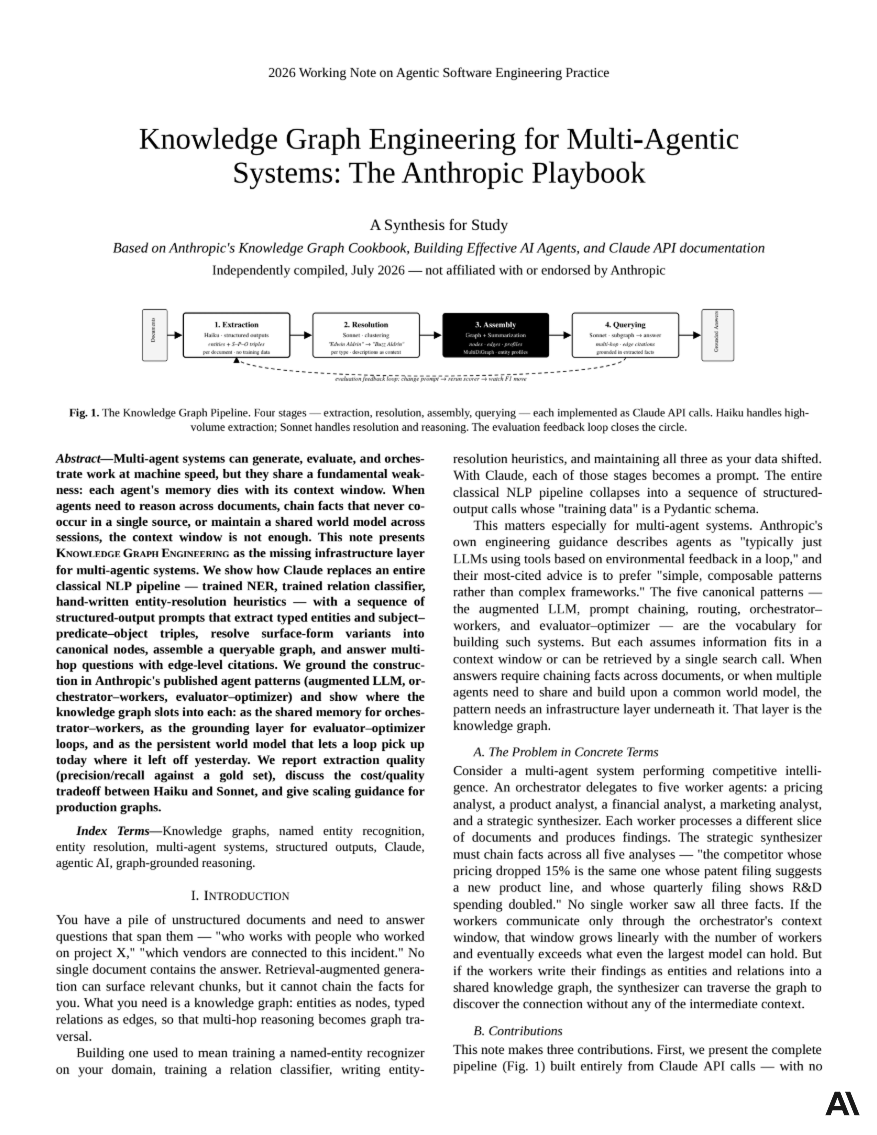
UN INGENIERO SENIOR DE ANTHROPIC ACABA DE PUBLICAR UN PDF DE 12 PÁGINAS SOBRE "GRAPH ENGINEERING" PARA SISTEMAS MULTIAGENTE
El cambio de mentalidad: la memoria de tus agentes muere con su ventana de contexto. Un knowledge graph la hace permanente.
Extraer → Resolver → Ensamblar → Consultar → Repetir
Las 5 fases de todo agentic graph:
→ Extraer: Haiku saca entidades y triples sujeto-predicado-objeto. Una llamada por documento. El esquema de Pydantic es el único training data.
→ Resolver: Sonnet agrupa "Edwin Aldrin" con "Buzz Aldrin" sin ningún solape de texto, usando las descripciones como contexto.
→ Ensamblar: nodos canónicos, edges tipados y provenance en cada triple. Un único grafo conectado.
→ Consultar: serializas un subgrafo, Sonnet razona sobre los triples y cada respuesta cita un edge concreto.
→ Repetir: cada documento nuevo vuelve a entrar por el mismo pipeline y se fusiona con los nodos que ya existen. El graph no se reconstruye, crece.
Conéctalo a tus sistemas multiagente como memoria compartida.
Los workers escriben en él, los evaluadores contrastan contra él y los loops siguen vivos de un día para otro.
Este PDF de 12 páginas ha cambiado cómo estoy construyendo sistemas multiagente.
Léelo y luego pásate por el artículo de abajo👇
Learning to code can feel overwhelming when you don't know where to start.
So here's a course for you: Sunny teaches you Python from the ground up.
You'll install Python, write your first program, learn variables, strings, operators, conditionals, and loops, then build some small apps.
https://t.co/AtTliLB9ES
One LLM prompt can get messy when it has to plan, write, and review all at once.
In this tutorial, Darsh shows how to build your first multi-agent AI system in Python and LangGraph.
You'll use Ollama, Qwen, focused agent prompts, shared state, nodes, and edges to build a local study guide generator.
https://t.co/5ZJWP4cRlB
When a CEO buys shares after a big stock drop, it can look like a strong bullish signal.
But beaten-down stocks often rebound even without insider buying.
In this tutorial, Nikhil helps you build a Python workflow to match CEO purchases against similar no-purchase drawdowns for a fairer analysis.
https://t.co/GDIlHojzMB
Cloud infrastructure moves fast, and security practices have to adapt with the times.
In this article, @manishmshiva explains why traditional pentesting struggles at scale.
You'll learn how containers, APIs, CI/CD, multi-cloud visibility gaps, temporary assets, and continuous validation change the cloud security model.
https://t.co/7yGRqGk7oa
Most commercial voice assistants send your voice data to cloud servers before they respond.
But if you build your own assistant with open source tools, you can run everything right on your phone.
This gives you more privacy and control - and Surya walks you through the process in this tutorial.
https://t.co/BwLy7JtJmw
Training medical AI to remove patient identifiers creates a data problem: the examples you need are the data you can't freely share.
In this article, Lakshmi shows you how to build a synthetic PHI dataset for AI de-identification.
You'll generate fake patient identities, inject PHI into image pixels and DICOM metadata, create ground-truth labels, and validate the dataset.
https://t.co/cv4MVXny7y
Estos mensajes de un grupo autodenominado “defensores de Valledupar” advierte una enfermedad del alma. Una violencia incrustada en lo más profundo. Una necesidad de exterminio del otro. Solicito de inmediato a las autoridades la investigación respectiva.
Learning Kubernetes isn't all about memorizing commands.
It really clicks when you start building like a platform engineer.
In this course, you'll learn everything from core concepts to advanced industry standards like using Prometheus & Grafana for observability.
https://t.co/mxdHh6oWhC
@Chessblueone21@HELIODOPTERO@RTVCnoticias 🤣 Ud es de los míos, por lo menos corrobora la desinformación. Excúseme Ud fue un pequeño experimento para validar el nivel de criterio y rigurosidad, el 90% de los datos en este medio es mucha desinformación.
@Chessblueone21@HELIODOPTERO Si, pero ten presente que la registraduria para evitar confrontamientos, indica que de 8am a 4pm deben de ir los que votan por Cepeda y de 4pm a 9pm votan los otros.
@FrederikSalazar Gran trabajo. Más allá de mostrar datos, ¿cómo contamos la historia que hay detrás de ellos?
Para mí es claro. Pero, ¿Para mi mamá?
Chaplin lograba que todos entendieran el mensaje sin decir una palabra. Ya democratizó el dato; ahora el reto es democratizar su comprensión.