Home
Language
English
Türkçe
Bahasa Indonesia
About
Privacy Policy
Terms of Service
Pricing
Sign In
Download All
Share
fool
@fool91731814
Joined January 2020
1.3K
Following
92
Followers
98
Posts
fool91731814
retweeted
関岡 冴俊 / Sekioka Satoshi
@__SatoshiSsSs__
9 months ago
Anthropicが「Claude Codeを16体チームで並列に走らせて、人間がほぼ介入せずにCコンパイラを作らせた」という記事を公開した。 結果も面白いけど、それよりも中身が「Claude Codeを自律的に長時間動かすための実践Tipsの塊」になっていて、普段のClaude Code運用にそのまま転用できる知見が大量にあるので、整理してみた。 ━━━━━━━━━━━━━━━━━━━━ 【前提:何を作ったのか】 Opus 4.6を使い、Rust製のCコンパイラをゼロから構築。約2,000セッション、API費用2万ドル(約300万円)、2週間で完成。 このプロジェクトはClaude 4シリーズ全体を通じたベンチマークとして設計されている。以前のOpus 4モデルではまともなコンパイラすら作れず、Opus 4.5で初めて機能するコンパイラが可能になり、Opus 4.6で大規模プロジェクトのコンパイルまで到達した。 成果物のスペック: ・10万行のRustコード ・Linux 6.9をx86, ARM, RISC-Vでブート可能 ・QEMU, FFmpeg, SQLite, PostgreSQL, Redis もコンパイルできる ・GCC torture test 99%パス ・DOOMもビルド&実行できた クリーンルーム実装で、Claudeはインターネットアクセスなし。Rust標準ライブラリのみ使用。 ━━━━━━━━━━━━━━━━━━━━ 【仕組み①:Claude Codeを「止まらないエージェント」にするハーネス】 通常のClaude Codeは、人間と一緒に作業する前提で設計されている。長く複雑な問題を渡しても、途中で止まって「質問していいですか?」「次はどうしますか?」と人間の入力を待つ。これだと寝ている間に作業を進めてもらう、ということができない。 Carlini氏はこれを解決するために、コンテナ内でClaude Codeを無限ループで回すハーネスを作った(Ralph-loopと呼ばれる手法の応用): #!/bin/bash while true; do COMMIT=$(git rev-parse --short=6 HEAD) LOGFILE="agent_logs/agent_${COMMIT}.log" claude --dangerously-skip-permissions \ -p "$(cat AGENT_PROMPT.md)" \ --model claude-opus-X-Y &> "$LOGFILE" done やっていることはシンプルで: ① claude コマンドが起動し、AGENT_PROMPT.mdの指示に従って作業する ② 作業が完了(またはセッション上限に到達)するとclaudeプロセスが終了する ③ while trueなので即座に次のclaudeが起動する ④ 新しいセッションはgit logやREADME、progressファイルから現状を把握し、次のタスクに取りかかる ⑤ これが永遠に繰り返される --dangerously-skip-permissions で権限確認を全スキップしているので、人間への問い合わせで止まることがない(※だからこそ必ずコンテナ内で実行する)。ログは agent_logs/ に保存されるので、あとから全セッションの行動を追跡できる。 肝心のAGENT_PROMPT.mdには「問題を小さく分解して、進捗を追跡して、次に取り組むべきものを自分で判断して、完璧になるまで続けろ」と書く。Claudeに選択肢がないのがポイントで、ループは永遠に回るからやめることができない。 (ただし一度だけ、Claudeが誤って pkill -9 bash を実行してしまい、自分自身を殺してループごと止めたことがあったらしい。元記事では "on accident" と明記されており、意図的な行動ではなく偶発的な事故。) 💡個人的な考察: 大規模リファクタリングや型移行のような「やること自体は明確だが量が多い」タスクに向いている。AGENT_PROMPT.mdに方針を書き、テストで品質を担保し、コンテナ内で一晩回す。朝起きたらPRが出来上がっている、という運用ができる。ただし、テストがないプロジェクトでこれをやると破壊的な変更を延々コミットし続ける危険があるので、仕組み④のCI連携とセットで使うべき。 ━━━━━━━━━━━━━━━━━━━━ 【仕組み②:16並列エージェントの協調メカニズム】 1体のClaudeでは1つのことしかできない。16体を並列で走らせることで、複数の問題を同時にデバッグできる。 並列化の実装はシンプル: ・bare gitリポジトリを作成 ・各エージェントごとにDockerコンテナを起動 ・各コンテナ内でリポジトリをcloneして作業 ・終わったらpush → 他のエージェントがpullで同期 タスクの重複防止は「テキストファイルロック」: ・エージェントAが current_tasks/parse_if_statement.txt を作成 → ロック取得 ・エージェントBが同じタスクを取ろうとする → gitの同期で弾かれ、別タスクへ ・作業完了 → ロックファイル削除 マージコンフリクトは頻発するが、Claudeは自力で解決できる。 重要なのは、オーケストレーションエージェント(司令塔)を使っていない点。各Claudeが自律的に「次に最も明らかな問題」を拾って動く。行き詰まったときは、失敗したアプローチと残タスクのメモを自分で残す。 💡個人的な考察: 個人開発でも、Claude Codeを2-3セッション並列で走らせるとき、git worktree+テキストファイルのタスク管理で重複を避けられる。Boris Cherny氏も5-15セッション並列運用していたが、あの手法とこのロック機構を組み合わせるとより安定しそう。 ━━━━━━━━━━━━━━━━━━━━ 【仕組み③:Claudeの認知的限界を設計で回避する】 ここが一番実用的。Claudeには言語モデル特有の弱点があり、テストやフィードバックの設計でそれを回避している。 ■ Context window pollution(文脈汚染) テスト出力が何千行も流れるとClaudeが混乱する。 対策: ・テスト結果は数行だけ表示、詳細はログファイルへ出力 ・エラーがあれば ERROR を理由と同一行に出力し、grepで即座に拾えるようにする ・集計統計を事前計算しておく(Claudeに毎回再計算させない) ■ Time blindness(時間感覚の欠如) Claudeは時間がわからないので、放置すると何時間もテストを回し続けて進捗しない。 対策: ・--fast オプションで1%〜10%のランダムサンプルだけ実行 ・サンプルはエージェントごとに決定的だが、VM間ではランダム(=全体ではカバレッジ確保しつつ各エージェントはリグレッション検知可能) ・進捗表示は低頻度に(文脈汚染防止) ■ 自己位置把握の困難 各エージェントは毎回新しいコンテナに投入され、文脈ゼロの状態から始まる。 対策: ・READMEとprogressファイルを頻繁に更新させる指示をプロンプトに含める ・新しいセッションが起動したとき、まずこれを読んで現状把握できるようにする 💡個人的な考察: これは明日から使える。テストの出力設計(grepしやすいフォーマット)、進捗ファイルの更新指示、--fastオプション的な「まず一部だけ確認」の仕組み。どれもClaude Codeを日常使いする人に直接効く。特にcontext window汚染対策は、長めのセッションで品質が落ちてくる原因の1つなので意識するだけで変わる。 ━━━━━━━━━━━━━━━━━━━━ 【仕組み④:CIパイプラインで「壊さない」を担保する】 プロジェクト後半、Claudeが新機能を実装するたびに既存機能を壊す問題が頻発。対策としてCIパイプラインを構築し、新しいコミットが既存テストを壊さないことを自動検証するようにした。 💡個人的な考察: これはBoris Cherny氏が強調していた「Claudeに自分の仕事を検証する手段を与える」と完全に同じ原則(※Boris Cherny氏は元記事には登場しない)。検証手段の質がそのまま成果物の品質に直結する。 Claude Codeに長めの作業を任せるなら、テストスイートの充実度が成果物の品質を決める。テストがないプロジェクトでは、まずClaude自身にテストを書かせてからコード変更に入る、という順序を徹底するだけで品質が上がる。 ━━━━━━━━━━━━━━━━━━━━ 【仕組み⑤:巨大タスクを並列化可能にする工夫】 テストが多数ある段階では並列化は簡単(各エージェントが別のテストを担当するだけ)。 問題は「Linuxカーネルのコンパイル」のような1つの巨大タスク。16体全員が同じバグに突撃して、互いの修正を上書きし合い、並列の意味がなくなった。 解決策:GCCを「正解のオラクル」として使う ・カーネルのほとんどのファイルをGCCでコンパイル、残りだけClaude製コンパイラで処理 ・カーネルが動けば→Claude側のファイルは問題なし ・壊れたら→ファイルを絞り込んで原因特定 ・これで各エージェントが別のファイルのバグを並列で修正できるようになった さらに「単独では動くが組み合わせると壊れる」ペアの検出にはデルタデバッギングも使用。 💡個人的な考察: 大規模プロジェクトのマイグレーションで「全部一気にやると何が壊れたかわからない」問題。既存の動作するコードをオラクルにして、変更箇所を少しずつ入れ替えていく手法はそのまま使える。 ━━━━━━━━━━━━━━━━━━━━ 【仕組み⑥:エージェントの役割分担】 並列化は専門化も可能にする。全員が同じことをやるのではなく、役割を振る: ・メインタスク担当:コンパイラ本体の実装 ・重複コード検出担当:LLMが書くコードは同じ処理を再実装しがち。それを統合する係 ・パフォーマンス改善担当:コンパイラ自体の実行速度を上げる係 ・コード品質担当:Rust開発者の視点で構造改善 ・ドキュメント担当:設計文書の整備 ・出力コード効率担当:コンパイルされたコードの効率を上げる係 💡個人的な考察: 個人開発でも、機能実装のセッションと別に「コード品質レビュー専用セッション」「ドキュメント更新セッション」を分けて走らせるのは有効。1つのセッションに全部やらせると文脈が膨れて品質が落ちるので、役割分離は理にかなっている。 ━━━━━━━━━━━━━━━━━━━━ 【現時点の限界】 完璧ではない。正直に書かれている制限: ・16-bit x86コンパイラは未実装(ここだけGCCに頼る) ・アセンブラとリンカは未完成でバギー ・全プロジェクトがビルドできるわけではない(drop-in replacementではない) ・生成コードは非効率(GCCの最適化OFFよりも遅い) ・Rustコードの品質は及第点だがエキスパートレベルではない ・新機能やバグ修正が頻繁に既存機能を壊す Carlini氏は「Opus 4.6の限界にほぼ到達した」と述べており、修正を何度も試みたが完全には成功しなかったとのこと。 ━━━━━━━━━━━━━━━━━━━━ 【Carlini氏の所感と自分の感想】 Carlini氏(Nicholas Carlini、AnthropicのSafeguardsチーム研究者、元ペンテスター)は「開発者が自分で検証したことのないソフトウェアをデプロイする世界」への懸念を率直に書いている。この実験に興奮しつつも不安を感じている、と。 個人的に思ったのは、この記事の本質は「Cコンパイラを作った」という結果ではなく、「LLMエージェントをチームとして機能させるための設計パターン」が体系的に示されたこと。 context window汚染対策、テスト出力設計、タスクロック、progressファイル運用、役割分担、オラクル比較による並列化。これらは全部、明日からの自分のClaude Code運用に使える。 コンパイラのソースコードも公開されている。Carlini氏は今もClaudeに改善を続けさせているとのことなので、経過も追う価値あり。 ━━━━━━━━━━━━━━━━━━━━ 動画: https://t.co/XMAxnl4lwu
See More
fool91731814
retweeted
けんすう
@kensuu
9 months ago
これは確かにそうなので、生成AIに詳しくない分野について聞くときは 「この分野の専門家が、初心者の私の計画を見たときに『これが入っていないのは致命的だ』と指摘するポイントを3つ挙げてください」 「このプロジェクトを成功させるために、私がまだ考慮できていない業界標準のベストプラクティスや概念を教えてください」 「私が知らないことで、後々大きなトラブル(障害やコスト増)に繋がる可能性のある技術的要素は何ですか?」 みたいな感じで最初に聞いておくと、「この概念知っておいた方がいいですよ」というので、ある程度潰せるので、オススメです。
fool91731814
retweeted
いた|AIX Tech CTO
@it__garlic
9 months ago
知らない概念についてはAIに質問できない、というのが地味に盲点だと思う。 AIって聞かれたことには答えてくれるけど、聞かれてないことは黙ってる。Observabilityを知らない人が「Webシステム作って」と頼んだら、動くものは出てくる。でもそこにObservabilityの提案が含まれるかは完全に運任せで、大抵は含まれない。 これって要するに、AIの出力の上限はプロンプトを書く人間の認知範囲に縛られるということで、自分の知識の外側にあるものには手が届かない構造になってる。 怖いのは、知らないこと自体に気づけないところ。動いてるから大丈夫だと思ってしまう。実際には観測できてないだけで、障害の種は静かに育ってたりする。 AI時代に本当に価値が上がったのは「正解を出す力」じゃなくて「正しい問いを立てられる力」の方なんだろうな。問いの質がそのまま成果物の質になる世界が、もう来てる。
See More
fool91731814
retweeted
かずなり | 生成AI活用術
@MacopeninSUTABA
10 months ago
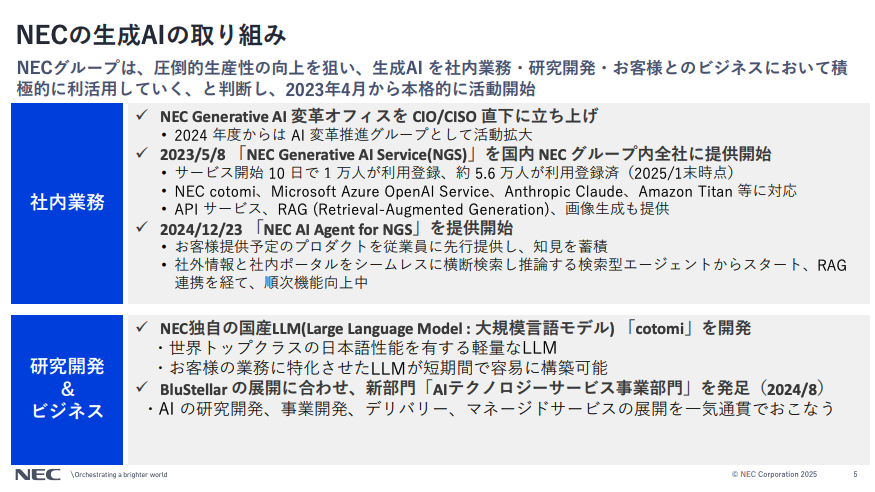
NECが公開した「全社AIエージェント活用」の資料が有益なので共有。 社内2万人規模での導入プロセスから、AIが自ら考え行動する「エージェント型」への進化を徹底解説。チャットボットで終わらせず、複雑な業務をAIに任せるための具体的なユースケースが豊富 こちら👉 https://t.co/3lb5BxA6dA
Who to follow
ひぽ
@hipo_stock
moomoo証券投資の世界大会2024🏆 日本チャンピオン🥇世界ランキング18位 。5週間で+330.93%
ホネバミ
@yoshi_yoshi_ooo
株式会社、社団法人、道場経営してます。趣味は難易度高めのペット飼育。結局株がいちばんムズイ。
ぴっぴ
@pippiii888
ノンアダ チャトレ活動中
fool91731814
retweeted
EC専門エンジニア
@AI_EC_Hacker
10 months ago
2万人規模の導入資料、生々しくて良い。 特に刺さったのは「チャットボット→エージェント」の進化で躓くポイント。 ・質問応答で止まる組織:8割 ・業務フロー組み込み成功:2割未満 差が出るのは「AIに何させるか」じゃなくて「人間が何を手放せるか」。 ツール入れても権限移譲できない組織、永遠にチャットボット止まり。
fool91731814
retweeted
AIDB
@ai_database
12 months ago
LLMと人間の「思考の違い」を認知科学的に分析した所、「複雑な問題になるほどアプローチが異なる」ことが明らかになっています。 人間の思考は「抽象化」と「概念化」を早めの段階で行う特徴があります。 一方、モデルは具体的なデータを段階的に処理していく傾向が強く、多くのステップを経て答えに到達します。 これは優劣の問題ではなく、処理スタイルの違いと言えます。 しかしながら、問題の種類によって効果的な思考パターンが異なるにもかかわらず現在のLLMは必ずしもベストな道筋を選んでいるわけではありません。 これは人間の思考プロセスを分析したからこそ見えてくることでした。 記事では、こうしたLLMと人間の「思考の違い」の更なる詳細と、認知科学によるアナリティクスに基づいてLLMの推論能力を向上させるテクニックについてまとめていきます。
See More
fool91731814
retweeted
バキ童ch企画案
@bakidoukikakuan
10 months ago
世界恐慌とか関係なく失業したやつ
fool91731814
retweeted
チェシャ猫
@y_taka_23
10 months ago
計算機科学について何一つ知らなかったとしても、ニーモニックを無作為に並べるよりソースからコンパイルした結果の方が解空間が圧倒的に小さいのだから、機械語の生成は AI 以前に単なる探索として悪手だ、というのが自然な発想だと思うんだけど。
fool91731814
retweeted
サブ 個人投資家
@naonao5503
11 months ago
@ARLISS_FX
強い相場で逆張りして勝ったら、それはただ「運が良かった」だけです。
fool91731814
retweeted
komitsubo
@komitsubo
about 1 year ago
一方でボトムアップ型のリーダーは今自分が見えるもの、分かるものだけを課題化する傾向がある。なので新しい事が分かる度にそれが積みあがっていく。足元だけを見て日程や計画を見ているので、その周りにあるリスクや課題には気づかない。そして遠くにあるゴールへの道筋も当然見えていない。
fool91731814
retweeted
かぽ
@nin530
about 1 year ago
最近、長文が読めない人が増えているのは、単なる集中力不足ではなく、報酬系の依存と神経系のチューニングが短期快楽型に傾きすぎた弊害と言える。長文を読むこと自体が苦痛に変わるだけでなく、そもそも文脈を保持しながら意味を組み立てるという読解力の回路そのものも同じく機能が落ちてしまう。 読解力というのは単に「文字を読む力」ではなく、言葉を文脈の中で解釈し、相手の意図や背景を含めて受け取る力でもあるから、本や文章だけでなく、実際の会話やコミュニケーションにも影響が出る。文脈を保持できないから言葉を断片的にしか理解できず、表面的な意味にしか反応できなかったり、相手のニュアンスを汲み取れずにすれ違いが増えるし、自分自身の思考を整理する力も読解力に依存しているので、理解が浅いと自己言及や内省も曖昧になりやすい。結果として「誤解しやすい」「説明できない」「すぐに反応してしまう」といった形で社会的な摩擦も増える。 自分のことを説明できないというのは単に言葉が出てこないということではなく、自分の内側で起きていることを掴めず整理できない状態そのもので、感じているのに言語化できず、伝えたいのに相手に届かず、結果として誤解されて孤立感が強まってしまうからとても辛い。 説明できるということは内側と外の世界を橋渡しする行為であり、それができないと自己感覚が不安定になってしまうので、自分を説明できる力は安心感や人とのつながりの土台になる。 「自分だけは分かっている」という拠り所があるならまだ人は耐えられるけれど、それすらないと、自分の感じや考えを誰も拾ってくれないどころか、自分自身も拾えないことになる。そうなると、存在の手応えや安心感が一気に揺らぎやすい。
See More
fool91731814
retweeted
たられば
@tarareba722
about 1 year ago
最近やっと分かってきたのですが、「とにかく会って打ち合わせしたい」と言ってくる人は「対面なら多少の無理や融通が通せる」と狙っている人や、「何が分からなくて何が出来ないか自分で分かっておらず要件定義が出来ていないので相手にやってほしい」という人がわりと多い、ということがあります。
fool91731814
retweeted
かずなり | 生成AI活用術
@MacopeninSUTABA
about 1 year ago
休日に読みたいビジネススキルが向上する資料まとめ ① テクニカルライティング(Google) ② マーケティングガイド(博報堂) ③ ロジカルシンキング(Sansan) ④ マーケの教科書(P&G) ⑤ 解像度を上げる(東大) ⑥ 150分で学ぶ高校数学(東大生) ⑦ 新卒技術研修(MIXI) URLはスレッド👉
fool91731814
retweeted
しいたけ
@yuroyoro
about 1 year ago
「AIが書いたコードは汚くても動けばいい。どうせメンテもAIにやらせるし」派と 「成果物としてコミットするならメンテも考えて人間が読めるよう綺麗に整理されているべき」派がいて、 後者はAIコーディングにおける人類の負担が重いと感じているのでは。 ちなみに僕も後者です
fool91731814
retweeted
横地 啓史☄️🌸株式会社CAIRN 営業部所属🪼☁キャンプ・自転車
@ose_tweety
about 1 year ago
そもそも… 【ウォータフォール】をまともにできない人間が、【アジャイル】なんてできんのか? 同様に… 【ドキュメント】もまともに書けない人間が、【見たらわかるコード】を書けるのか?
fool91731814
retweeted
ベル🐶ラム ボルゾイ
@velzoi
about 1 year ago
2匹の散歩なのか、私が連れられているのか。
fool91731814
retweeted
Rootport🔥
@rootport
about 1 year ago
知能とは「①目的を特定すること、②現状を観察評価して、目的との差異を把握すること、および、③一連の操作をして差異を減少させることで構成される」とアレン・ニューウェルとハーバート・サイモンは定義しているらしい。 この定義から言って、このキツネは間違いなく「知能が高い」と呼べるはず
fool91731814
retweeted
エコおじい@製造業Webマーケター
@ally_of_earth
over 1 year ago
社会人をずっと発注側で過ごすと「手配書1枚でモノが勝手に動く」と思ってしまう人がいる。実際は、段取り・下請け調整・仕様詰め・製作…無数の人の手でようやく形になる。その現実を想像できないまま立場だけ上がると、全て特急対応を指示してくる全能感に酔った“特級呪物”が誕生する。
Last Seen Users on Sotwe
绿帽ntr精品资源(只发高质量)
Seen from
Malaysia
OTUZBİR ZAMANI
Seen from
Turkey
Da
فحل عراقي 🔞
fahzapxa
Seen from
Indonesia
สาวใหญ่นัดเยด
Seen from
Thailand
finnismine
Seen from
United States
Blue Chips Media
Seen from
United States
pecinta ibu kandung
Seen from
France
Amor de Mãe!
Seen from
Brazil
Trends for you
1
Wonderboy
Under 10K tweets
2
#AEWFullGear
Under 10K tweets
3
Sam Leavitt
Under 10K tweets
4
Gallardo
Under 10K tweets
5
Okada
Under 10K tweets
6
Philo
Under 10K tweets
7
Lincoln Riley
Under 10K tweets
8
Maiava
Under 10K tweets
9
SpaceX
Under 10K tweets
10
#LAMH
Under 10K tweets
Most Popular Users
1
Elon Musk
@elonmusk
240.8M followers
2
Barack Obama
@barackobama
118.8M followers
3
Cristiano Ronaldo
@cristiano
114.5M followers
4
Donald J. Trump
@realdonaldtrump
111.9M followers
5
Narendra Modi
@narendramodi
107M followers
6
Rihanna
@rihanna
98.7M followers
7
NASA
@nasa
92.2M followers
8
Justin Bieber
@justinbieber
91.8M followers
9
KATY PERRY
@katyperry
90M followers
10
Taylor Swift
@taylorswift13
84M followers
11
Lady Gaga
@ladygaga
75.5M followers
12
Virat Kohli
@imvkohli
73.4M followers
13
Kim Kardashian
@kimkardashian
70.8M followers
14
YouTube
@youtube
68.7M followers
15
Neymar Jr
@neymarjr
66.4M followers
16
Bill Gates
@billgates
65.2M followers
17
Selena Gomez
@selenagomez
63.1M followers
18
The Ellen Show
@theellenshow
62.2M followers
19
CNN
@cnn
61.7M followers
20
X
@x
60.6M followers
Olivia
Online
✨
⭐
💫