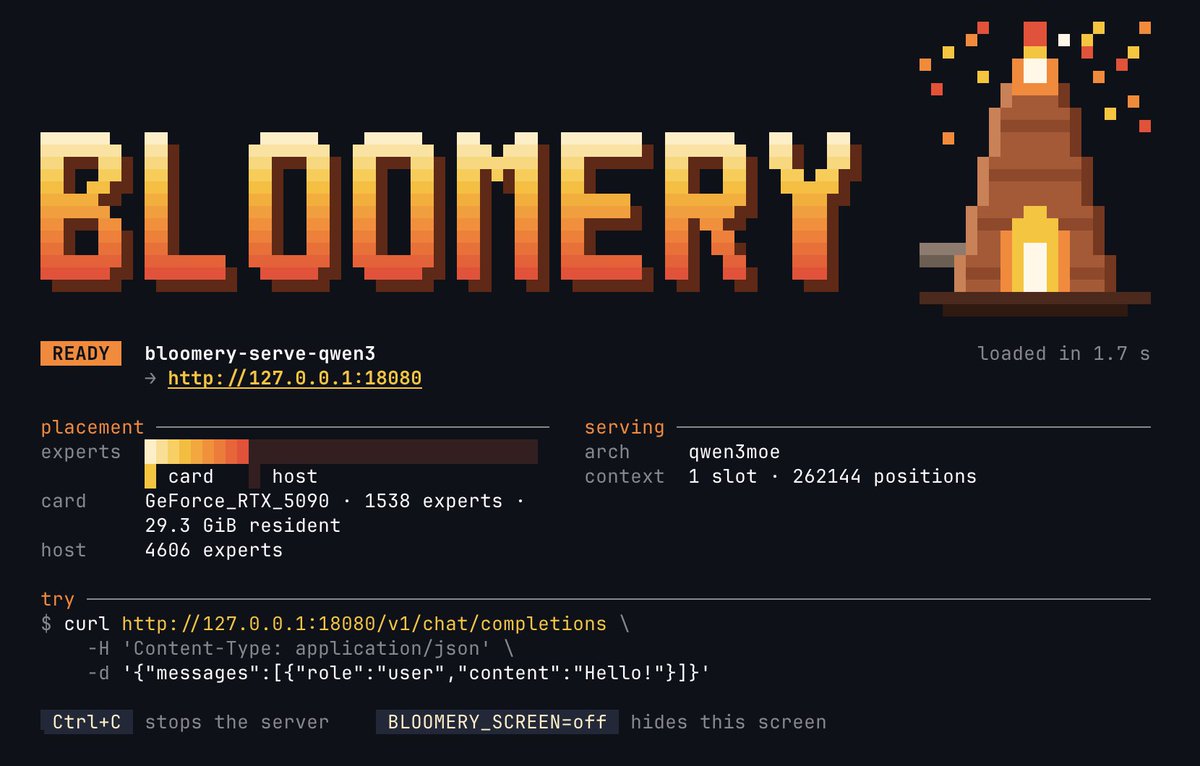
드디어 써볼만한 수준이 되었네요.
VRAM안에 다 안들어가는 LLM모델을 x86(AVX2지원)에서 cpu 오프로딩으로 돌릴때 빠른 LLM추론엔진입니다. Deepseek 4.1 flash, GLM 5.3-flash, Qwen38-next-flash, clef-flash을 우선지원합니다. 모델과 양자화방식 계속 추가합니다.
https://t.co/RCSDAXEiD9
Spent a bunch of tokens over the last few weeks building a fully procedural New York simulation.
https://t.co/YSrGNoIYsK
It's only 784KB gzipped and the code is on github, so you can do whatever you want with it ✌️
모바일게임 좋아하고 퍼포먼스 마케팅 경험이 있으며(게임이면 우대) 향후 데이터를 잘 다루는 PM으로 성장하고 싶은 분 찾고 있습니다...제가 맡은 팀에서 저한테 거의 맨투맨으로 코칭받으며 일하는 associate pm 롤 채용입니다. 이미 억대 월매출을 내는 제품이었는데 올해 반기만에 두배의 성장을
https://t.co/1Dq4EyFBpL
오늘도 한국모델 추가중인 bloomery
모델을 추가할수록 더 모델추가 속도를 빠르게 만들겠다는 목표를 잡고 있는데 모델별로 미묘한 피쳐들이 있어서 쉽지 않네요. raon-1 mini는 RTX 3090한장에서 120tps정도. 모델 자체 제공 코드보다 20%빠릅니다.
Today, we’re releasing a preview of Raon-1 mini, a 30B MoE LLM with 4B active parameters, trained from scratch by KRAFTON AI.
With our efficient architecture, it matches Muse Glimmer on coding/agentic tasks while being much faster and more memory-efficient! 🔥 Plus, natural, human-like conversation.
This is just a first look. The final release (and bigger models) are coming soon! 👀
👉 Try it now, free for a limited time: https://t.co/uSrLFIGPWy
🤗 Open weights + DFlash drafter (Apache 2.0): https://t.co/XWVmxsDRei
실시간 화면 번역 뭐여?!
어제는 문맥추가한다고 번역 백엔드에 프롬프트 넣는 기능을 넣었는데 생각해보니 입력토큰을 늘려서 비용을 더하는것 보다 간단하기 룰베이스로 조정하는 기능도 좋겠다 싶어 넣었습니다. 그리고 논문 번역도 잘 된다고 자랑하러 영상을..
https://t.co/OYu1rpyQJ8
번역기에 mcp를 단다면 어떻게 될까요?
실시간 화면 번역기 mwoyeo가 에이전트와 연동하는 기능을 추가하고 있습니다. 아직 일부 deepl연동에서만 작동확인을 했지만 가능성의 문이 열립니다.
어릴적에 이런게 있었다면 얼마나 좋았을까 하는 생각이😭
https://t.co/CpCNxTVvgO