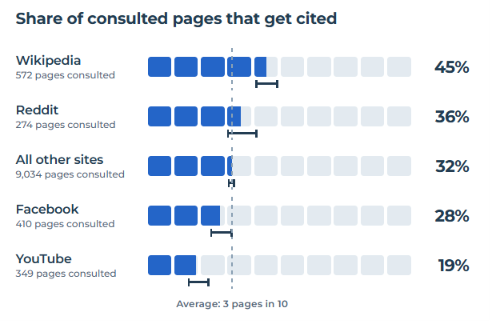
We got our hands on 75K+ Gemini conversations that kind of fell off the back of a truck 😅 (all publicly shared, don't worry)
Inside: 222K+ Google searches run by Gemini, the pages it read and the exact passages it cited
So we went through all of it ^^
https://t.co/95Jv1X0Ltv
C'est quand même dommage de collecter autant de datas sur ses utilisateurs pour ses propres métriques ou pour les revendre, et de ne pas réussir à s'en sortir...
Prenons l’exemple du @leparisien.
Un simple audit des communications réseau déclenchées par la consultation d’un seul article gratuit, dans un navigateur Chrome en navigation privée, sans compte connecté, sans cookies préexistants et sans cliquer sur la moindre publicité.
Deux observations : avant tout choix de consentement, puis après acceptation des cookies, rechargement de la page et quelques défilements.
Voici ce qui se passe réellement derrière votre écran.
1. Avant même d'accepter les cookies
En 35 secondes : 41 requêtes HTTP(S), 13 hôtes contactés et déjà 9 cookies présents.
Des informations sont notamment transmises à :
→ Piano Analytics : l'URL complète de l'article consulté, son titre, sa rubrique, ses mots-clés, un identifiant de visiteur, un identifiant de page vue, les dimensions de l'écran, l'architecture du processeur et les versions précises de macOS et Chromium.
→ Majelan / Voxa : l'adresse de l'article, un identifiant d'appareil (deviceId), un identifiant de session (sessionId) et un événement signalant l'affichage du lecteur audio.
Et cela sans même avoir lancé la lecture audio.
2. Après avoir cliqué sur « Tout accepter »
Bon, évidemment c'est un festival.
Lors de la seconde observation, qui dure 45 secondes et comprend un rechargement et quatre défilements :
→ 650 requêtes HTTP(S).
→ 116 hôtes distincts.
→ 106 cookies présents, répartis sur 45 domaines.
→ 294 fournisseurs déclarés activés par le gestionnaire de consentement, sur 296 partenaires annoncés.
Mais regardons ce qui circule.
3. Meta, Google et les autres : votre visite sur l'article devient un événement publicitaire
Le pixel Meta/Facebook reçoit notamment un événement PageView, l'URL complète de l'article, un identifiant de navigateur (_fbp), un horodatage et des informations sur votre écran.
Certains événements comportent également l'identifiant de l'article, son titre, sa catégorie et des champs concernant le statut d'abonnement.
Pas besoin d'être connecté à Facebook pour que ces informations soient envoyées à Meta.
Google / DoubleClick reçoit de son côté des informations sur la page consultée, des identifiants publicitaires, des paramètres de consentement et des données relatives à l'appareil.
4. Le plus intéressant : les plateformes synchronisent leurs identifiants
C'est là que l'écosystème publicitaire prend toute sa dimension.
Chaque intermédiaire peut attribuer un identifiant à votre navigateur :
→ Google / DoubleClick : IDE
→ Meta : _fbp
→ Xandr : uuid2
→ Criteo : uid, cto_bundle
→ Outbrain : obuid
→ ID5 : id5
L'audit révèle de nombreuses opérations de cookie syncing entre les plateformes.
Le principe ? Permettre à deux intermédiaires de faire correspondre leurs identifiants pour reconnaître un même navigateur.
Des séquences de synchronisation ont notamment été observées entre Google, Mediarithmics, Xandr et ID5.
Pas besoin de connaître votre nom pour pouvoir corréler vos activités de navigation.
Ces échanges démontrent l'existence de mécanismes de rapprochement d'identifiants, sans toutefois prouver que chaque acteur a constitué un profil complet du visiteur.
5. Et ils ne mesurent pas seulement les pages ouvertes
D'autres outils interviennent :
→ Permutive : informations contextuelles et segmentation d'audience.
→ Marfeel : temps actif, engagement, progression dans la page, fréquence des visites et performances.
→ Teads : caractéristiques d'affichage, orientation, qualité de connexion et complexité du document HTML.
→ Integral Ad Science : visibilité des publicités, position à l'écran et durée d'exposition.
→ Outbrain : recommandations sponsorisées, mesure de visibilité, événements publicitaires et synchronisation d'identifiants.
Tout cela pour la consultation d'un seul article.
6. Est-ce illégal ?
Pas nécessairement.
Le constat est surtout celui-ci : derrière une simple page d'information se trouve une infrastructure de collecte, de mesure et d'échanges publicitaires d'une ampleur largement invisible pour le lecteur.
Pendant que les éditeurs de presse s'inquiètent de la baisse de leur audience, ils continuent à multiplier les intermédiaires chargés de mesurer, segmenter et monétiser celle qui leur reste.
Et encore, cette observation ne concerne qu'une seule page, pendant quelques dizaines de secondes...
A tester et merci ! Et en complément, il y a aussi Cloudflare Radar qui classe les domaines via les requêtes DNS sur 1.1.1.1, donc l'info même pour des sites qui ne sont pas sur Cloudflare.
https://t.co/31UEKgVnZI
120 M de vues en 24 heures pour le message X d'un chercheur anonyme.
Jacob Coxon, 27 ans, spécialiste du pré-entraînement des modèles, avait quitté OpenAI plus tôt cette année pour Anthropic, justement pour sa réputation en sûreté des modèles.
Mercredi dans la nuit il claque bruyamment (euphémisme) la porte et quitte l'industrie.
Sa position : il a trouvé les efforts d'Anthropic sincères, et il estime quand même qu'aucune entreprise ne peut développer une IA plus performante que l'humain de façon responsable, sans intervention des États ou ralentissement coordonné du secteur.
Sur le calendrier, au Wall Street Journal : « Nous sommes en trajectoire vers beaucoup des plus agressifs de ces scénarios, où dès la fin de l'année prochaine les choses pourraient déjà être hors de contrôle. »
CE QUI FRAPPE PLUS QUE LA DÉMISSION
La réponse d'Evan Hubinger, responsable de la science de l'alignement chez Anthropic. Toujours en poste, lui.
« Jacob a raison ici. Nous croyons vraiment sincèrement que l'IA pourrait tuer tous les humains ! Personnellement je pense que c'est à plus de 10% dans la décennie qui vient. Je crois qu'Anthropic fait de son mieux, mais nous n'avons pas encore de plan pour résoudre l'alignement d'une superintelligence, et nous ne sommes pas clairement en voie d'en avoir un. »
Deux heures plus tard, il précise quand même : « Je pense que le risque venant des modèles actuels est faible. Ce qui m'inquiète, c'est une superintelligence qui émergerait d'une auto-amélioration récursive, dont nous avons dit qu'elle arrive plus vite que nous ne le pensions. »
Dario Amodei n'a pas commenté. Il ne sera pas choqué, ayant signé avec Coxon, avec le directeur scientifique d'OpenAI et avec plus de 1 000 chercheurs un appel à une coordination internationale sur un mécanisme de freinage.
À court terme, l'inquiétude porte sur la cybersécurité, et elle est déjà documentée.
À plus long terme, c'est l'hypothétique auto-amélioration récursive qui angoisse, jusqu'au gardien du temple, le responsable de l'alignement lui-même.
On peut rester optimiste et imaginer que c'est contrôlable. Mais même dans ce cas-là l'IA et la robotique vont générer des transformations profondes dans les années et décennies à venir, qui devraient tous nous faire réfléchir. C'est d'autant plus vrai que l'Europe est mal positionnée pour profiter de la richesse créée.
Les sources :
Le thread de Jacob Coxon (7 messages) : https://t.co/y4nUPwREtN
Le message d'Evan Hubinger : https://t.co/8Htlje0jkj
L'article du Wall Street Journal d'Amrith Ramkumar, en accès libre : https://t.co/q0AqtsB0Tf
Avec mon pote Jeremy, chaque appel commence par « t’as 5 minutes ? » et se termine 2H + tard
Alors on a décidé d'en faire un podcast 🎙️ Le premier épisode est en ligne. https://t.co/0E3iCRBgoE
En 2026, les agents d’IA ont dépassé les humains en consommation de tokens.
Personne ne l’a remarqué.
Nous sommes devenus minoritaires dans l’usage de notre propre technologie.
Avec @dr_l_alexandre
Comment créer une couverture de livre accrocheuse ? "La question elle est vite répondue" ((c) jpfanguin) sur le blog de l'impression pour l'autoédition Pumbo ! https://t.co/9WiOAvv6YT
L'interdiction par "les grandes institutions de recherche dont le CNRS" d'utiliser d'autres modèles d'IA que Mistral bride les chercheurs ou les contraint à utiliser des modèles de frontière sur leurs propres comptes personnels... Une situation que déplore ici @AntoineTilloy
🧵
Est-ce la prière des éditeurs de sites VDL auprès d'Alphabet / Google ? Et peut-être même d'éditeurs de Saas et autres outils de suivi de positions dans les Serps ? #DontBeEvil#Dotherightthing Don't be evil — Wikipédia