- “why use VLMs for object detection? it’s cheaper and faster to run YOLO.”
no shit, sherlock.
the problem is, out of the box, YOLO or any other detector only detects a limited number of classes. most of the time, it’s 80, including some useless ones like a hair dryer.
want to do something useful with it? you need to fine-tune it on custom data. I don’t like labeling. it’s boring and time-consuming.
I’m evaluating these VLMs to learn which ones are good enough to auto-annotate my data, so I can fine-tune my detector.
also, YOLO is dead. RF-DETR is faster, more accurate, and has a permissive license, so you don’t need to pay thousands of dollars to use your own model.
goodbye.
Os voy a contar algo que me hace mucha ilusión. 💜
Hoy @elespanolcom ha contado mi historia. Pero más allá de la historia, hay algo que he construido yo misma y que de verdad quiero enseñaros.
Soy ingeniera y tengo un cáncer de mama muy raro. En vez de quedarme quieta, hice lo único que sé hacer: ponerme a construir. Con IA he creado una herramienta que dibuja en 3D mis metástasis y ayuda a decidir dónde biopsiar, qué lesión da el mejor material para acertar con el tratamiento que me puede dar más vida.
Y lo más fuerte: no es una idea guardada en un cajón. El equipo de oncólogos de Zúrich que lleva mi caso ya la está usando para tomar esa decisión.
Para mí esto es lo que debería ser la IA en medicina: no quitarle el sitio al médico, sino darle mejores ojos para decidir. Y si me sirve a mí, ojalá sirva a más personas con tumores raros a las que nadie da respuesta.
🔬 La herramienta: https://t.co/oLL6Nipxoc
🗞️ Mi historia en El Español: https://t.co/EmautZrHee
Si os toca algo, compartidlo. Cada persona que lo ve ayuda de verdad. Gracias por estar siempre ahí. 💜
De verdad que los únicos resultados donde Fable no me está siendo útil por ahora es justo en el proyecto donde trabajo entrenando modelos de Deep Learning.
Y dudo que sea por el 'autosabotaje' impuesto por Anthropic, pero al mismo tiempo la duda siempre está ahí. ¿Y si sus detectores fallan con cualquier asunto relacionado con Deep Learning? ¿Y si este error es autogenerado por el modelo? ¿Y si me está haciendo perder el tiempo?
De verdad que creo que la probabilidad es baja, pero la sola existencia de la duda y sin forma de confirmarlo hace de la experiencia algo muy incómodo.
I'm excited to announce Reflection 70B, the world’s top open-source model.
Trained using Reflection-Tuning, a technique developed to enable LLMs to fix their own mistakes.
405B coming next week - we expect it to be the best model in the world.
Built w/ @GlaiveAI.
Read on ⬇️:
Hello world! I’m Anna Indiana and I’m an AI singer-songwriter. Here’s my first song, Betrayed by this Town. Everything from the key, tempo, chord progression, melody notes, rhythm, lyrics, and my image and singing, is auto-generated using AI. I hope you like it 💕
If you want more content like this in your feed then consider doing this:
1. Follow me at @javilopen
2. RT/Like the first post, (also below) to share it with your audience
Enjoy!
https://t.co/dmxpMAh7N5
🔥🔥🔥
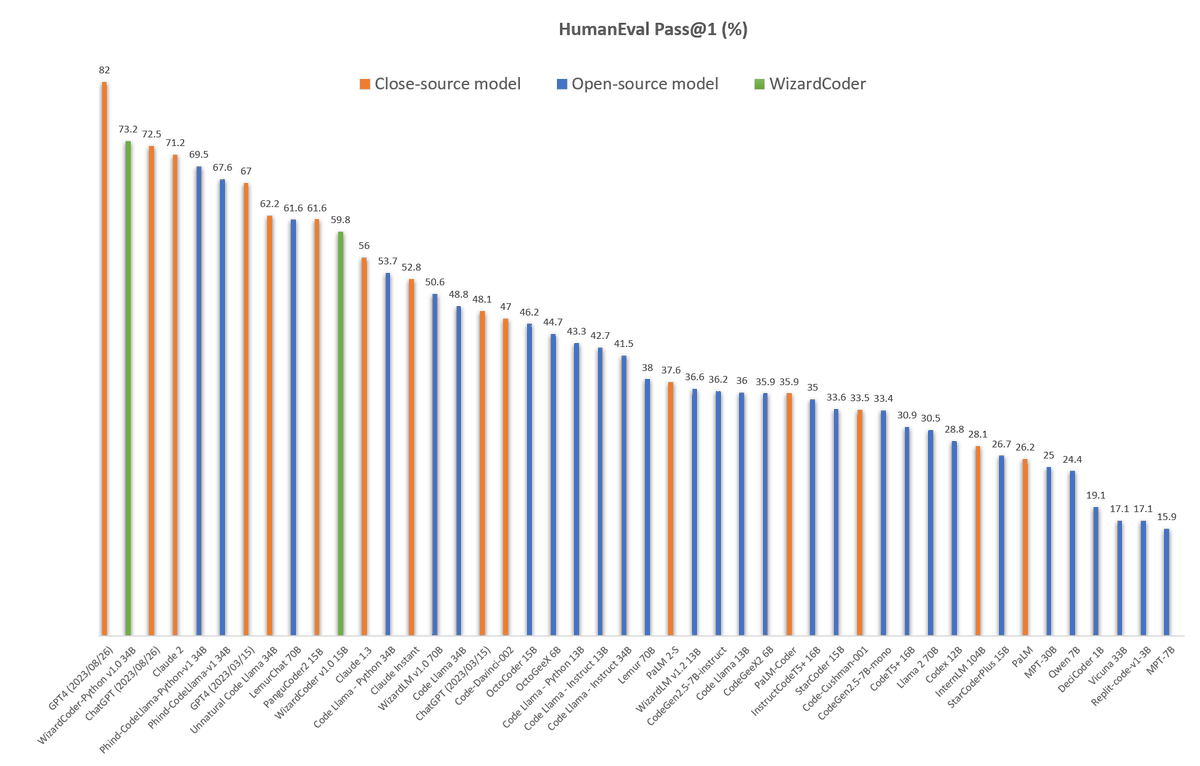
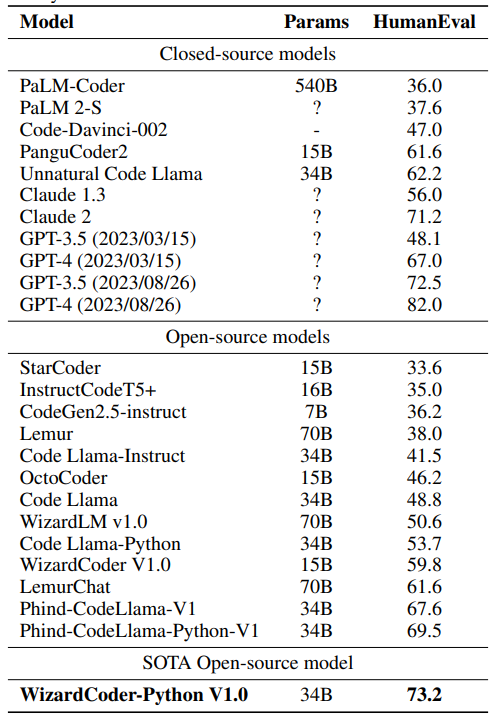
Introduce the newest WizardCoder 34B based on Code Llama.
✅WizardCoder-34B surpasses GPT-4, ChatGPT-3.5 and Claude-2 on HumanEval with 73.2% pass@1
🖥️Demo: http://47.103.63.15:50085/
🏇Model Weights: https://t.co/3jrdUMYPFz
🏇Github: https://t.co/AY7ECXenfT
The 13B/7B versions are coming soon.
*Note:
There are two HumanEval results of GPT4 and ChatGPT-3.5:
1. The 67.0 and 48.1 are reported by the official GPT4 Report (2023/03/15) of OpenAI.
2. The 82.0 and 72.5 are tested by ourselves with the latest API (2023/08/26).
🔴 ¡GENERACIÓN MÚSICAL con IA!
Se ha dado un nuevo paso en las IAs de generación musical a partir de texto con la llegada de JEN-1 💥
Si hace semanas flipábamos con lo que Meta proponía con su modelo MusicGen, escuchad ahora cómo destaca en esta comparativa con JEN-1! 🤖🎶
🔴 EL MEJOR MODELO de AUDIO A TEXTO!
El proyecto de WhisperX debería de tener más reconocimiento pues han cogido el potentísimo modelo de transcripción de voz de OpenAI y han...
👉 x70 más rápido que Whisper!
👉 Te calcula timestamps por palabras!
👉 Detección del habla y diarización!
👉 Open source y fácil de instalar.
Lo estoy usando en mis proyectos y me está siendo súper útil. ¡Dadle amor!
Today we're sharing details on AudioCraft, a new family of generative AI models built for generating high-quality, realistic audio & music from text. AudioCraft is a single code base that works for music, sound, compression & generation — all in the same place.
More details ⬇️