Home
Language
English
Türkçe
Bahasa Indonesia
About
Privacy Policy
Terms of Service
Pricing
Sign In
Download All
Share
跟 Ron 玩 AI
@PlayAIwithRon
每天带你玩转最新 AI 🚀 新鲜资讯 + 新工具实测 + 好用的新玩法 | 新 AI 我先试,踩完坑再推荐给你
Joined April 2019
515
Following
1.6K
Followers
103
Posts
Pinned Tweet
跟 Ron 玩 AI
@PlayAIwithRon
about 4 hours ago
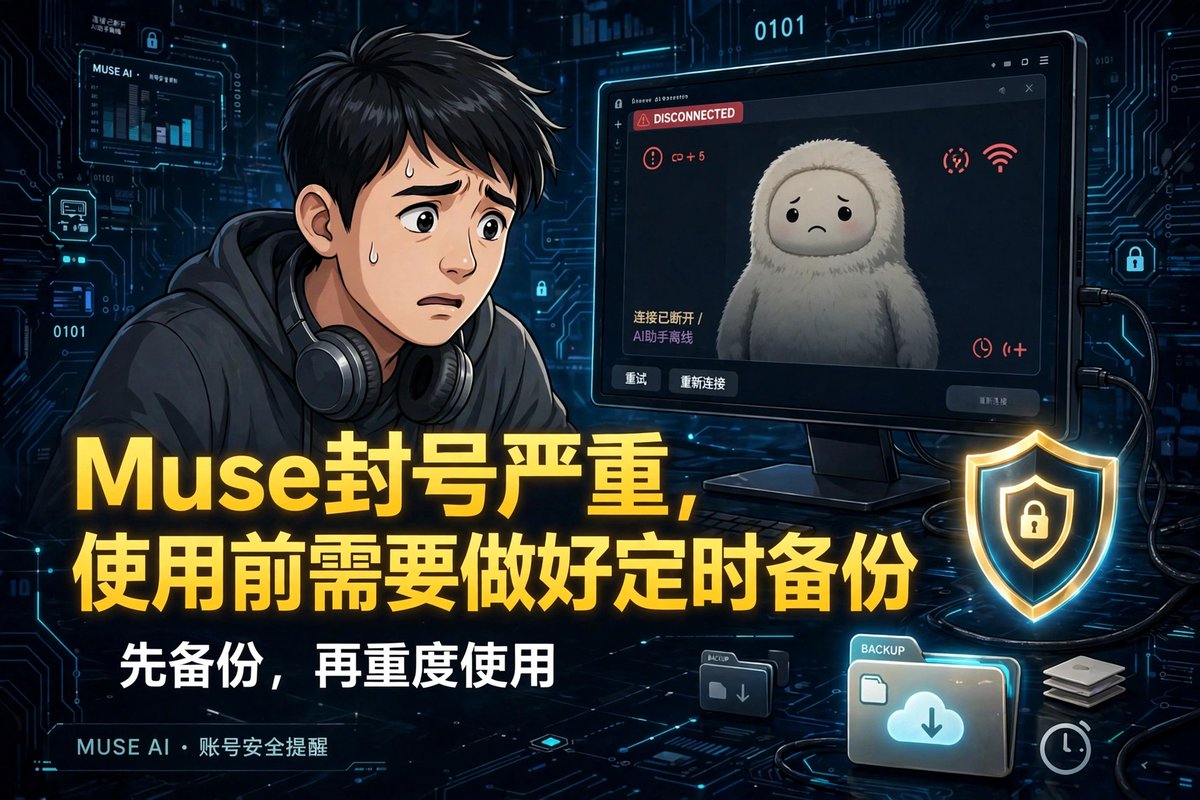
如果你明天早上打开 Muse,只看到一句“已断连”,而你过去几个月一点点调教出来的记忆、人格、工作方式、项目进度,全都拿不回来,你会先慌,还是先认栽? 这不是危言耸听。最近 Muse 封号的讨论明显变多了,有人申诉后恢复了,有人等了几天没有回复,只能换新号重来,最亏的不是换号本身,而是旧号里没导出的东西直接归零。先说结论:对重度用户来说,备份不是“有空再做”,而是开始重度使用之前就该做好的第一步。 先讲来龙去脉。Muse 是 Meta 的个人 AI 助手,它不只是一个聊天框:它有自己的云端工作机,长期记忆、个人设定、目标和工作区都存在账号里,时间越长,沉没成本越高。也正因为这样,一旦账号出问题,损失不是一天的聊天记录,而是一整套“已经磨合好的助手”。 最近被讨论最多的封号线索有两条,都要区分“报道”和“官方定性”。第一条是免费额度被批量薅:据社区报道,一些 Telegram 机器人打着“免费拿几十亿 token”的旗号,用批量注册和邀请码循环放大额度,而正常规则是新用户 48 小时内可用邀请码、双方各得 10 亿 token、最多邀请 20 人,免费周额度本身只有 1 亿,付费 Power 是每月 20 美元、每周 5 亿,Maximum 是每月 100 美元、每周 30 亿。被点名的触发因素还包括频繁换 IP、脏 IP、多设备登录、批量注册和邀请码闭环。第二条是 Meta 账号联动风险:有用户自述,先连了 Threads 和 Instagram 没事,加了 Facebook 发帖后被判定异常,随后同一 Meta 账号下的应用陆续出问题,Muse 也跟着断连。这两条目前都没有看到 Meta 公布逐项封号清单,所以不能把任何一条当成官方原因,只能当成高风险行为清单来避坑。 还有一点官方没明说的:断连往往是服务端锁定,重装、退出重登、换网络、关 VPN 通常救不回来,只能走申诉等回复,而等待时间没有公开承诺。这就决定了正确的顺序:不是封了再想办法导出,而是封之前就已经有一份能用的备份。 备份到底能救什么?它救的不是“账号”,而是“助手的大脑和骨架”。我现在用的就是每小时同步一次的方案:只有文件变了才提交和推送到一个私有 GitHub 仓库,备份范围是白名单,不碰密码和密钥。里面包括 AGENTS、SOUL、IDENTITY、USER、MEMORY,memory 下的每日记录和 bank,人物和群组索引,主动提醒偏好、工具 quirks、Feed 提示词、各旁聊记忆,以及目标工作区和定时任务定义。新号拿到后,按 IMPORT.md 把文件放回对应位置,告诉新 Muse 按说明读取应用,就能把称呼、偏好、长期记忆、工作方式和目标先立起来,损失窗口最多约一小时。 但也要把话说死,免得误导:备份不是一键复活。密码、API Key、第三方登录态不会、也不应该进备份仓库;完整聊天记录、已发布的 Feed 文章、定时任务本身和 Goals 标签页记录,靠放文件是恢复不了的,定时任务必须在新号重建,第三方账号必须重新登录授权。备份的价值,是让你换号后不用从零解释“我是谁、我怎么做事”,而不是让你假装什么都没丢。 所以分三档建议。现在就做:已经把 Muse 当主力助手、记忆和项目都在里面的人,今晚就搭每小时备份,别等到断连那天才后悔。可以缓一缓:只是偶尔聊两句、没什么长期记忆的人,先做一次手动打包也够用。千万别做:别碰批量刷 token 的机器人和邀请码循环,别批量注册,别把备份仓库设成公开,也别把任何密钥写进备份里——前者是往封号枪口上撞,后者是把备份变成新的泄露口。 最后提醒一句:备份防的是“失去”,不是“被封”。它不能帮你绕过风控,也不能保证申诉成功,它保证的只有一件事:万一最坏的情况发生,你还有一个干净、可恢复的起点。 可直接用的备份提示词,复制给你的 Muse: 请帮我做一份每小时自动同步的 Muse 迁移备份包,目标是:万一账号断连,新号能按说明恢复记忆、设定和目标。 1. 新建一个私有 GitHub 仓库(不要公开),本地副本放在 ~/workspace/migration-repo,只操作这一个仓库,不要碰其他仓库,不要 force push。 2. 每小时执行一次:先拉取最新内容,冲突或失败就停下来向我汇报,不要强推。 3. 只按白名单复制:~/AGENTS.md、~/SOUL.md、~/IDENTITY.md、~/USER.md、~/MEMORY.md、~/PROACTIVE_PREFERENCES.md、~/TOOLS.md;~/memory/ 下的每日记录、bank、people、groups;Feed 提示词全文;各旁聊的 MEMORY.md;~/workspace/goals/ 下每个目标的 GOAL.md、files、定时任务定义和 hidden_files。 4. 绝不复制:~/.ssh/、任何密码、API Key、Token、验证码、银行卡号、第三方登录态和内部运行日志。 5. 无变化就不提交、不推送、不打扰我;有变化才提交并推送,提交信息写清同步时间,并确认远程已收到。 6. 再写一份 IMPORT.md,写清楚每个文件在新号该放到哪里,并特别注明:Feed 提示词要用 Feed 工具设置、定时任务必须在新号重建、第三方账号必须重新登录。 7. 迁移成功后,提醒我停掉旧号的同步,避免两个号往同一个仓库写、互相覆盖。
See More
跟 Ron 玩 AI
@PlayAIwithRon
about 6 hours ago
@bonbonbonko73
问到点子上了,98%好看,2%才决定它能不能真无人值守:能自己重试、失败后降级处理,和卡住就得人救场,是两回事。前者只是多跑几遍,后者就得算上人力待命成本。原帖没展开这2%的处理方式,这正是判断它能不能从一家店复制到多家店的关键。
跟 Ron 玩 AI
@PlayAIwithRon
1 day ago
一个机器人,在武汉江滩的小店里上了 24 天班,卖了 1253 单——这还不是最值得看的数字。 先说这家店。智元的远征 A3 Ultra,身高 1.74 米的全尺寸双足人形机器人,和武汉文旅集团、中云微迅合作,在汉口江滩“江遇”桥墩电影营地开了一间智慧零售仓。它干的不是表演:识别商品、抓取、交付给顾客,还能和游客对话,卖的是十余种零食、饮品。10 月 27 日更新的成绩单是:连续运营 24 天,累计处理订单 1253 笔,单日最高突破 100 笔,取物成功率超过 98%。对比一下 10 月 19 日的旧成绩单——18 天 827 单、成功率超 97%——这间店不是开业剪了个彩就撤了,而是在真实夜游客流里越跑越稳。户外、夜里、人来人往、商品种类随时变,这些条件加起来,比实验室里的演示要难得多。 同一天,智元还公布了另外两件事,拼在一起才完整。第二件是“脑子”的成绩:轻量模型 GO-3 Nano Preview 在香港大学主导的具身评测 RoboDojo 里,以平均 61.90 分、成功率 56.42% 排到第一,超过了 GPT-6 Astra;精细操作 78.65 分、长程执行 68.21 分、开放语义理解 61.71 分,三项细分也都是第一。注意,这只是预览版,正式版要等到 10 月 29 日的智元 AI Day 才发布,成绩能不能在正式版上复现,还要再看一次。但它传递的信号很清楚:专门为机器人身体训练的小模型,在“动手干活”这件事上,已经可以在评测里赢过通用大模型——通用模型什么都懂一点,专用模型在某几件具体活上更稳。 第三件是最值得琢磨的,叫 Genie Master——先说清楚,这和今天上午谷歌那个 Genie 4 只是撞了名字,完全不是同一个东西。智元的 Genie Master 是一个具身 Agent 框架:搭载它的精灵 G2 在真实便利店上岗期间,不依赖人工示范和调试,自己定位失败原因、调整策略、把经验沉淀下来,在多个复杂精细任务上持续改进。厂商的说法是,这是行业第一次跳出仿真环境、在真实业务场景里验证“具身递归自进化”——这句话要打个标记:它是厂商说法,还没有独立验证,别当成行业共识来读。但方向本身是对的:机器人真正的成本不在买的那一刻,而在上岗之后——每换一个商品、每遇到一种新摆法,都要不要重新请人来教一遍,决定了它到底是员工还是展品。 所以判断人形机器人新闻,别只看“它会走路、会跳舞”,看三个上岗指标。第一,真实订单数:它到底卖出去、干成了多少单,而不是演示了多少次。第二,成功率和失败长什么样:98% 的取物成功率背后,那 2% 是卡住了、掉地上了,还是叫人来帮忙了——失败的处理方式比成功率本身更重要。第三,它会不会自己长本事:换了新商品、换了新场景,是要重新示教,还是能自己从失败里调整。这三项里,智元这间小店目前只回答了第一项和第二项的一部分,第三项还停留在厂商说法阶段。 Ron 的角度:对普通人和创作者,物理 AI 的正确期待不是“明年家里就有一个机器人保姆”,而是“先在某一个具体场景里,把一件事干稳”。开店、做餐饮、做零售的朋友,可以先从“一个固定货架、十几种商品、每天重复的取货交付”这类任务去理解机器人能干什么;做内容的创作者,下次拍机器人,别只拍它走路跳舞,拍它连续工作一小时里失败的那几次、以及它是怎么处理失败的——那才是观众真正想知道的“它到底能不能干活”。 来源:智元 2026 年 10 月 27 日披露,经界面新闻 https://t.co/2UZBRXTjXe 、澎湃新闻、证券时报等多家 10 月 27 日报道交叉核对(门店 1253 单为 10 月 27 日更新口径;GO-3 Nano 为预览版,正式版 10 月 29 日发布;Genie Master 自进化说法为厂商说法,待独立验证)
See More
跟 Ron 玩 AI
@PlayAIwithRon
about 7 hours ago
@Khazix0918
区别不在执行力,而在是否先质疑需求本身。补充一个条件:如果这20个表并非同一数据源,或者没有数据库只读权限,Claude这条捷径就走不通,那时是不是还得回到自动操作鼠标的方案?
Who to follow
baodao👀
@liubaodao
做空和做多都可以赚钱,贪婪的人除外
Fu393300.. |🧠SENT
@Fu393300
热爱Web3 | CRYPTO | BTC | ETH | SOL | Zama
Jaron
@jaron0jiang
跟 Ron 玩 AI
@PlayAIwithRon
about 7 hours ago
@criscxuan
单循环里把原来各 subagent 的 system prompt 压成 Skills 后,遇到工具权限不同或指令冲突的任务时,是靠 Skills 的触发条件隔离,还是靠主循环里的审批关卡兜底?
跟 Ron 玩 AI
@PlayAIwithRon
about 9 hours ago
@olivialinverse
没错,宣称到改写教科书中间还差验证、复现和共识这几步,跳过这些直接改写,确实太急了。
跟 Ron 玩 AI
@PlayAIwithRon
about 14 hours ago
AI 宣称证伪了一个困扰学界 25 年的猜想:先别急着改写教科书 “AI 推翻了一个 25 年的数学猜想”和“教科书要改写了”,这是两件完全不同的事,中间隔着的正是这篇文章要讲的东西。10 月 26 日前后,OpenAI 和 Anthropic 各自公布了一项重磅宣称:它们的内部模型找到了指数时间假设(Exponential Time Hypothesis,ETH)不成立的证明。先别急着转发“数学被改写了”,先把三条线划清楚:机器给出了什么、人类验证到了哪一步、以及这个结果在现实里到底意味着什么。 先说 ETH 本身为什么重要。它大致是说,判定一个布尔公式能否被满足,需要随变量数指数增长的时间。这个假设被广泛相信,并且作为数百篇论文中条件性难度结论的前提。也就是说,很多结论的表述方式其实是“如果 ETH 成立,那么这个问题就很难”。如果 ETH 真的不成立,影响会波及图论、计算生物学、数据库等多个领域,但影响的方式不是“所有难题一夜变简单”,而是那些建立在 ETH 之上的条件性结论需要重新审视。这个区分很重要,因为它决定了你接下来该紧张、该兴奋,还是该先观望。 再说这次宣称的具体内容。OpenAI 称,模型在 10 月 16 日找到证明、次日用 Lean 证明助手形式化;Anthropic 则公布了一个 3-SAT 的 2^o(n) 时间算法及 Lean 形式化。OpenAI 还表示,已把验证交给由 ETH 提出者之一 Russell Impagliazzo、Ramamohan Paturi 和 MIT 的 Ryan Williams 牵头的外部小组,并将在 GitHub 公布自然语言证明和 Lean 证明。把这段话翻译一下就是:AI 给出了一个可以被机器检查的证明候选,并且已经进入人类专家的独立验证流程,但验证本身还没有完成。 这里必须划清的第一条线,是 Lean 的作用。Lean 能检查“写出来的证明在形式上是否成立”,不等于学界已经接受结论的全部意义。多家报道指出,外部评审仍需数月,而 Impagliazzo 等人的参与也不等于认证——他们参与验证,恰恰说明这件事需要最严格的审查,而不是已经盖章。第二条线,是渐近和实用的区别。Anthropic 自己也强调,结果是纯渐近意义上的:它描述的是变量趋于无穷时的时间增长趋势,而不是明天就能更快解你手头的实际问题。一个渐近上更优的算法,本身并不告诉你在实际规模、实际常数和实际工程约束下表现如何,所以不要把它直接翻译成“电脑马上变快了”。第三条线,是密码和安全。OpenAI 方面据称也已检查,认为它不意味着密码系统被攻破,但这个判断本身也待同行确认,不能当成定论转发。更要提醒的是,OpenAI 同批宣称还包括数学与物理领域的证明,同样处于“已公布、待验证”阶段,不能因为其中一个听起来很震撼,就把整批都当成定论。 还有一段新闻稿不太会展开的背景:即使最终证明成立,学术界的工作也不会就此结束。条件性结论需要逐一重新梳理,哪些结论可以改写、哪些需要新的前提、哪些在实际中根本不受影响,都需要时间。反过来,即使证明在验证中发现问题,这次尝试本身也已经展示了一种新的科研分工:机器负责提出人类难以穷尽的构造和路径,人类负责验证、解释和判断意义。验证的速度,正在成为 AI 科学发现能走多远的瓶颈,而不是模型能不能“想出来”。 所以结尾同样分人群说。如果你是研究者或学生,现在不要改写讲义和论文前提,先盯住两件事:外部小组的验证进展,以及自然语言证明和 Lean 证明公开后同行的具体反馈;同时在自己的笔记里把“ETH 待验证”单独标注,不要把条件性结论悄悄写成无条件结论。如果你是工程师或开发者,现在不需要因为这条新闻改系统设计、改密码策略、改加密方案——没有任何可执行的动作来自一个尚未完成同行验证的渐近结果,等验证结论出来再评估也不晚。如果你只是普通读者,为 AI 参与前沿科学发现喝彩完全可以,但下次再看到“AI 推翻了某某定理”时,先问自己三句:形式化了吗?谁在独立审?说的是渐近趋势还是实际可用?这三句问完,你就不会被标题带着跑了。 主要来源:OpenAI 与 Anthropic 公布的证明及 GitHub Lean 形式化(经 2026-10-28 AI 新闻简报、TechCrunch 转述);外部验证状态、密码影响等标注“待确认”,以同行评审结论为准。
See More
跟 Ron 玩 AI
@PlayAIwithRon
about 13 hours ago
@zhanzhang3yue
5070Ti 16G跑10.8秒要7分钟,这个数字很有参考价值。想请教一下,如果把单段拉长到30秒以上,显存占用和出片时间是不是会明显变陡?另外你提到的换场景脸漂移,后来是靠固定提示词还是靠换参考图解决的?
跟 Ron 玩 AI
@PlayAIwithRon
about 13 hours ago
@Zen_with_AI
这个对比很直观。想请教一下,你期待的 liquid AI 这类小模型,是更看重它在端侧本地跑起来的低成本,还是它在长上下文和推理任务上能接近大模型的效果?这两条取舍好像决定了它到底能替代哪些场景。
跟 Ron 玩 AI
@PlayAIwithRon
about 18 hours ago
https://t.co/lzXfYx9Fph
跟 Ron 玩 AI
@PlayAIwithRon
about 19 hours ago
https://t.co/RmHls98VkX
跟 Ron 玩 AI
@PlayAIwithRon
about 19 hours ago
https://t.co/SugEWKlszh
跟 Ron 玩 AI
@PlayAIwithRon
1 day ago
@tim572885987202
没错,先看清日期再下单,省得买错版本😄
跟 Ron 玩 AI
@PlayAIwithRon
1 day ago
眼镜终于从“单色字幕条”变成了“眼前的小屏幕”——但先别急着下单,看清两个日期。 10 月 27 日,杭州厂商 Rokid 在 Rokid Jungle 2026 发布会上连发了三款东西:Rokid Glasses 2、Rokid Color、Rokid Ring。先分清前两款,因为它们根本不是同一时间能买到的东西。Glasses 2 是这次能立刻预售的升级款,售价 3699 元起,1200 万像素摄像头,支持 HDR 与 RAW14,还新增了一个很对症的功能叫“拍前预览”——按下快门前先确认取景范围,解决的是眼镜拍摄里最常见的痛点:拍完才知道拍到了什么、没拍到什么。 Color 才是这次发布会的主角,但它要等。Color 是一副全彩 AI 眼镜,采用定制的 0.16cc Micro-LED 全彩光机,整机 55 克(不含鼻托),黑色 2GB+64GB 版 4999 元、玳瑁色 4GB+64GB 版 5499 元,两款都搭载第一代骁龙 AR1+ 平台。为什么全彩值得单独讲?因为它改变的不是“字有没有颜色”,而是“眼前能放什么”。单色眼镜只能放简短文字提示,全彩才能放图片、视频、导航方向、任务进度和状态颜色——信息从“读一行字”变成了“看一眼画面”。同日雷鸟创新也官宣第四代双目全彩 AI 眼镜即将登场,说明全彩已经不是某一家的新奇功能,而是整个赛道下一轮竞争的起点。 第三件是戒指 Rokid Ring,售价 1699 元(随眼镜购买 998 元为转述口径)。它把滑动、单击、双击等微手势引入眼镜操作,作为语音和镜腿触控之外的补充输入——在不方便开口、或者需要连续翻页的场景里,不用每次都喊一嗓子;同时它还支持心率、体温、血氧和睡眠监测。眼镜、戒指、语音三件套拼起来的意思其实是:AI 眼镜的交互正在从“喊一句话、等一个回答”,变成“看一眼、动一下手指、就处理完一件事”。 但有两个日期和一句话要先说清楚,免得买错。第一,Glasses 2 是现在预售,Color 预计 2027 年 4 月交付——这个交付时间是外媒转述口径,官宣口径以官网为准,下单前务必以官网页面为准,别把“发布”当成“现货”。第二,AI 眼镜好不好用,关键不在发布会上的演示,而在真实街道噪音里的语音识别、翻译准确率,以及拍摄时的隐私边界——“拍前预览”解决的是取景问题,不是隐私问题,在人群里举着眼镜拍照,依然要先考虑周围人的感受。 Ron 的角度:给想尝鲜的读者一个分流建议。想现在就用、主要用来拍第一视角素材和日常记录的,看 Glasses 2;想要全彩显示、愿意等半年、想赌一把“眼前小屏幕”这个形态的,等 Color 的官网交付口径明确了再决定;不确定自己是不是眼镜用户的人,先别为“全彩”这个词多花 1300 元——先借一副、或者去线下店戴半小时,确认自己受得了鼻梁上多 55 克、并且真的会在走路时看眼前信息,再谈买哪一款。眼镜这个品类,戴得住比参数好看重要得多。 来源:Rokid Jungle 2026 发布会(2026-10-27),经亿邦动力 https://t.co/KSGDHXLhGw 、新浪财经 https://t.co/rGPijvbIpg 等多家 10 月 27–28 日报道交叉核对(Color 交付时间为外媒转述口径,官宣口径以官网为准;Ring 随眼镜购买价为转述口径)
See More
跟 Ron 玩 AI
@PlayAIwithRon
1 day ago
@macaronhaileeyy
确实,拿真实合并意愿当尺子,刷题的水分就藏不住了,这把尺子换得值。
跟 Ron 玩 AI
@PlayAIwithRon
1 day ago
模型排行榜今天换了一把新尺子——别急着说国产模型退步了,先看尺子换了什么。 今天(10 月 28 日)发布的 Artificial Analysis Intelligence Index v5,是这家独立评测机构自 1 月 v4 以来最大的一次升级。它衡量的不是某一家厂商的自卖自夸,而是一套跨模型的综合智能分:知识工作、编码、科学、通用四项各占 25%。这次升级最关键的一句话是:60% 的指数第一次建立在私有数据集或保留答案的测试上。翻译成人话就是:以前有些题可能被模型在训练时见过,现在大部分题是模型没见过的,刷题、背答案的路被堵住了不少。 具体换了什么,值得花一分钟看清,因为分数变化全从这里来。新增了两项:FrontierCode 2.0,132 个真实开源仓库里的编程任务,评分标准不是“跑通了测试”,而是“仓库维护者愿不愿意把这段改动合并进去”;Terminal-Bench-Science,70 个在终端里完成的科学研究任务。升级了三项:HLE-Diamond(1000 道题,推理与知识各半)、AA-Omniscience v1.1(去掉了已经饱和和公开的题)、CritPt v2 困难子集(40 道私题)。同时剔除了 GDPval-AA v2.1、SciCode、AA-LCR v1.1。尺子一换,排名当然会动——而且动的方式很有信息量。 先说总榜。Claude Opus 5.5(max)58 分第一,GPT-6 Astra(max)57 分,GPT-6.1 Sol(max)55 分,Gemini 4 Argon(high)50 分,前五名仍被 Anthropic 与 OpenAI 包揽。再说最容易被误读的一处:开源模型与第一名的差距,从上一版的 3 分拉大到了 12 分。Kimi K3.1 Pro 以 46 分仍是开源第一,但注意一个限定词:它的权重尚未发布;已经发布权重的模型里,DeepSeek V4.1 Flash 1017 与 GLM-5.3 均为 32 分,甚至低于 Claude Haiku 5.5 的 36 分。中文社区今天流传的“国模分数大幅下滑”,如果只看分数本身,确实会吓一跳;但正确的读法是:分数下滑的主因是尺子换了、题目变难变私了,不是模型一夜之间变差了。跨版本直接比分数,就像用旧卷子的分数和新卷子的分数比高低,本身就不成立。 再说分项,因为总分最容易骗人。编码的 FrontierCode 2.0 里,Opus 5.5 以 46% 第一,GPT-6 Astra、GPT-6.1 Terra、Claude Sonnet 5.5 均为 42%,已发布权重的最高分是 DeepSeek V4.1 Flash 1017 的 28%;科学的 Terminal-Bench-Science 里,GPT-6 Astra 以 63% 第一,Opus 5.5 为 59%、GPT-6.1 Sol 为 58%,已发布权重的最高分只有 13%,大多数开源模型不到 10%。分项还藏着另一个反常识:Kimi K3.1 Pro 在 Terminal-Bench 4.0 里以 67% 拿了第一,Gemini 4 Argon 在 AutomationBench-AA 里以 78% 拿了第一——没有一个模型在所有项目上都赢,所谓“最强模型”,其实是“在某一类任务上最强”。 最后说钱,这才是普通人选模型时最该看的一栏。前 10 名里,单任务成本相差 13 倍以上:GPT-6.1 Terra(max)每任务 0.96 美元最便宜,Claude Fable 5.1(max)13.04 美元最贵。也就是说,总分差几分,账单可能差十几倍。 Ron 的角度:以后再看到“某某模型登顶/跌落”这类标题,先问三个问题再决定要不要换模型。第一,榜单换尺子了吗?换了就别跨版本比分数。第二,它在你常干的那类任务上排第几?写代码、做研究、处理文档,看的应该是分项,不是总分。第三,同样的任务,它要花多少钱?对一人公司和小团队来说,正确的选法不是追第一名,而是先定任务类型,再看分项,再看单任务成本——榜单是 shopping list,不是颁奖礼。 来源:Artificial Analysis 官方文章《Announcing Artificial Analysis Intelligence Index v5》https://t.co/uS8KCq8y1Q (v5 发布于 2026-10-28;Kimi K3.1 Pro 权重尚未发布;跨版本分数不可直接比较,见正文)
See More
跟 Ron 玩 AI
@PlayAIwithRon
1 day ago
@Ma_JHUI
@AndyL5cc
确实,总管这个角色最难当——协调一堆 Agent,出了问题先背锅,功劳还不好算。
跟 Ron 玩 AI
@PlayAIwithRon
1 day ago
一个人,50 多个 AI Agent,干了 20 个工程师的活——这不是招聘文案,是昨天在 X 上冲到 AI 增速榜第一的一条分享。 作者是
@AndyL5cc
,自述曾在 Cursor 工作、现在是 SpaceX 的 AI 高级工程师。他的帖子拿下 X 榜单 AI 增速榜第 1 名,3.8 万曝光/时、总曝光 24.2 万,X 原帖浏览 24.5 万。先把话说在前面:“干了 20 个工程师的活”是博主自己的说法,没有第三方验证,别当成实测结论读;真正值得抄的,是他分享的结构。 他的结构是分层的:1 个总管、3 个项目经理,下面再挂一群执行 Agent。总管只干三件事:定目标、拆任务、验收结果;项目经理负责把任务派下去、汇总进度、把问题顶上来;执行层的 Agent 一次只干一件小事,比如查一份资料、写一段代码、跑一次检查。你只跟总管对话,总管去管项目经理,项目经理去盯执行——你永远不用同时跟 50 个 Agent 说话。 这条帖子火的原因不在“50”这个数字,而在分层这个思路。很多人用 Agent 翻车的方式恰恰相反:要么一次派 50 个活给一个 Agent,让它顾此失彼;要么让每个 Agent 都直接听你的,最后你自己成了瓶颈,比不用还累。分层解决的是“人管不过来”的问题:Agent 越多,越不能靠你一个人盯,越要靠结构去管。 普通人不用照搬 50 个,从 3 个起步就够了:一个搜资料、一个写初稿、一个专门挑错。给每个 Agent 写一句话职责,再加一句话验收标准,比如“交回来的表格必须有一列来源”。然后每天只验收一次汇总,不要逐条盯着改——你一逐条盯,分层就白分了,你又变回了瓶颈。另外还有两句原帖没细说的话:50 个 Agent 一起跑的 token 账单不便宜,出错互相放大的风险也不小,规模越大,越要先小范围试一周,算好成本和返工率再放大。 所以判断这类“Agent 军团”分享,别先问“他用了多少个”,先问“他怎么验收”。能说清验收标准的工作流才值得抄;只晒数量的,看看就好。 来源:X
@AndyL5cc
原帖
See More
跟 Ron 玩 AI
@PlayAIwithRon
1 day ago
@Haosen9527
说到点子上了,改完之后能不能逐条查、逐条撤,确实比接进来本身更关键,段落级确认要是能做到,敢放客户资料的人才会多起来。
跟 Ron 玩 AI
@PlayAIwithRon
1 day ago
你 Mac 里的 Keynote、Pages、Numbers,下个月要开始自己干活了——而且不只是苹果自己的助手能动它们,别的公司的 AI Agent 也能进来改你的文档。 这是 Apple 在 10 月 27 日官方新闻稿里宣布的 Creator Studio 更新,11 月上架 App Store。Keynote、Pages、Numbers 都要新增一个 beta 智能助手,基于 Apple 自研模型和 OpenAI,能理解当前文档的上下文:Keynote 里它可以帮你设计版式、加动画、打磨一版演示;Pages 里它可以起草、重组、改文字;Numbers 里它可以算数、整理数据、推荐图表、做自定义表格。同一次更新里,Logic Pro 也有了助手 beta,Final Cut Pro 内置了 MotionVFX 的效果库,Pixelmator Pro 加了用一句话改图的 Generate Fill。 但比助手本身更值得注意的,是 MCP 支持。MCP 是一个开放协议,苹果这次把它接进了 Keynote、Pages、Numbers(Mac 上、需要 macOS 27)。意思是:外部的 AI Agent 可以直接读这些文档的内容、改文件、执行自动化动作。文档从此不再只是“人打开的软件”,而是“Agent 也能进来的工作台”。你现在用的任何一家 Agent,将来都有可能直接在你的 Keynote 里改一页、在 Numbers 里重算一张表,而不用你先把文件导出来、再导回去。 不过有三个限制要先说清楚,免得 11 月一到就失望。第一,助手目前是 beta,而且只支持美式英语,中文用户先别急着指望它写中文文案。第二,它需要 Apple Intelligence 设备,还要 iOS 27、iPadOS 27 或 macOS 27,MCP 更是只有 Mac 能用。第三,助手是订阅功能:现有订阅者免费更新,新订美国价每月 12.99 美元或每年 129 美元,免费版 App 本身没有助手。 对创作者来说,最实在的用法不是“让它替你写”,而是把脏活外包出去。Numbers 里先让它把一堆原始数据理成表、推荐三张图,你来挑;Keynote 里先让它按你的大纲排一版,你再改版式和措辞;Pages 里先让它把一篇长文重组结构,你再定语气。还有两条保险要养成习惯:让 Agent 动手之前,先复制一份原文件;涉及客户资料和还没发布的内容,先别接外部 Agent,等权限和操作记录的机制清楚了再放。助手越能干,备份和边界就越重要。 来源:Apple 官方新闻稿 https://t.co/rxJyr9jAas
See More
跟 Ron 玩 AI
@PlayAIwithRon
1 day ago
@surlymochan
说到点子上了,默认全开省事是省事,但出事查不到是谁干的就麻烦了;权限收紧、审计跟上,慢一点也值得。
跟 Ron 玩 AI
@PlayAIwithRon
1 day ago
@dustADD
@AndyL5cc
对,这篇讲的就是这个案例,一个人用 50 多个 Agent 干了 20 个工程师的活,分工和编排才是关键。
Last Seen Users on Sotwe
Shanti People
Seen from
Indonesia
Miss Khumy
Seen from
South Africa
XP收藏家
Seen from
United States
Caner
Seen from
Turkey
นายปอ ตัวร้าย
Seen from
Thailand
Aysha Khan
Seen from
France
رضاوي لعراقي
cuckold mom
Seen from
Poland
MetaMenyala
Seen from
Indonesia
urstepbro
Seen from
Malaysia
Trends for you
1
Patrick Stewart
Under 10K tweets
2
Game 7
Under 10K tweets
3
Simmons
Under 10K tweets
4
Larkin
Under 10K tweets
5
Professor X
Under 10K tweets
6
Captain Picard
Under 10K tweets
7
2-4 WEEKS
Under 10K tweets
8
#NationalCatDay
Under 10K tweets
9
Dream in 7
Under 10K tweets
10
Charles Xavier
Under 10K tweets
Most Popular Users
1
Elon Musk
@elonmusk
241.5M followers
2
Barack Obama
@barackobama
118.8M followers
3
Cristiano Ronaldo
@cristiano
114.5M followers
4
Donald J. Trump
@realdonaldtrump
111.9M followers
5
Narendra Modi
@narendramodi
107.1M followers
6
Rihanna
@rihanna
98.7M followers
7
NASA
@nasa
92.3M followers
8
Justin Bieber
@justinbieber
91.8M followers
9
KATY PERRY
@katyperry
90M followers
10
Taylor Swift
@taylorswift13
84M followers
11
Lady Gaga
@ladygaga
75.5M followers
12
Virat Kohli
@imvkohli
73.4M followers
13
Kim Kardashian
@kimkardashian
70.8M followers
14
YouTube
@youtube
68.8M followers
15
Neymar Jr
@neymarjr
66.5M followers
16
Bill Gates
@billgates
65.2M followers
17
Selena Gomez
@selenagomez
63.1M followers
18
The Ellen Show
@theellenshow
62.2M followers
19
CNN
@cnn
61.7M followers
20
X
@x
60.7M followers
Olivia
Online
✨
⭐
💫