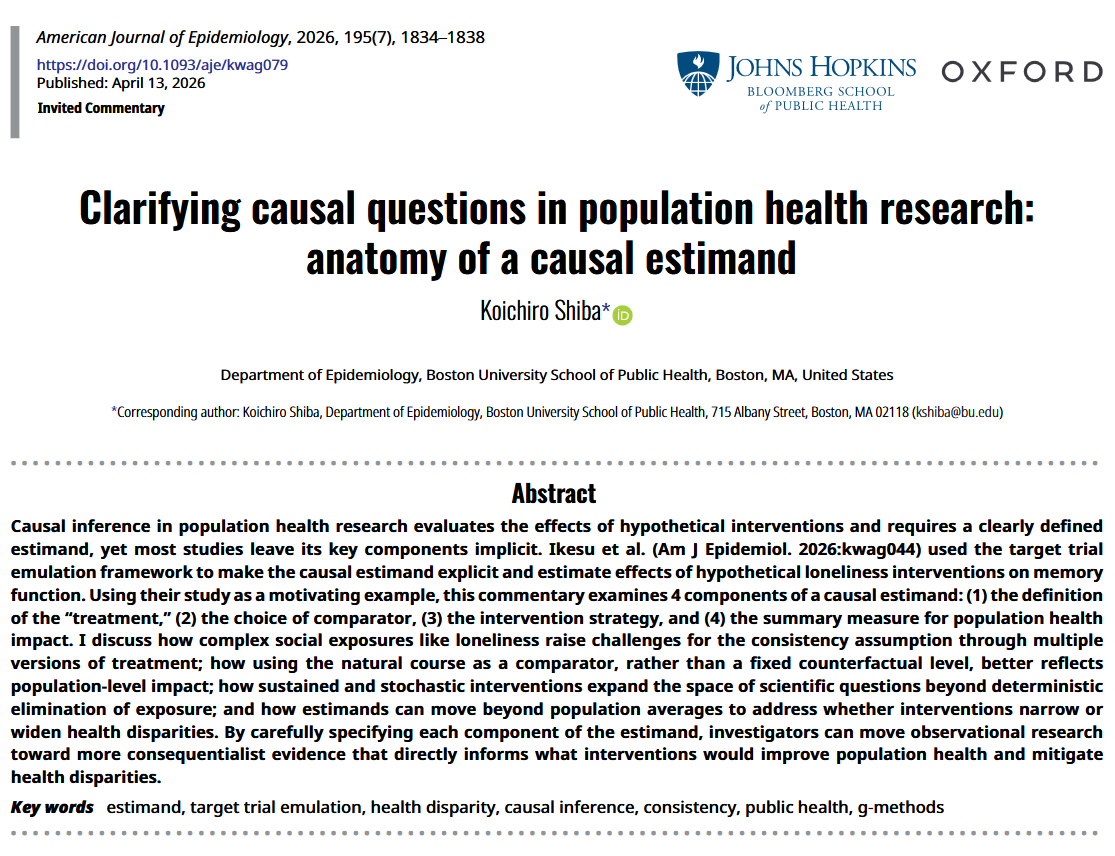
✨Quarterly Paper Shoutout✨
Every quantitative study should answer one question: What is your estimand? This article shows how to clarify causal estimands—and why doing so matters for actionable, equity-focused evidence.
https://t.co/IujALSjdA1
¿Sabes que muchos de los métodos empleados para realizar #RevisionesSistemáticas se apoyan en la convención y no en comparaciones empíricas?
En BiblioGETAFE introduzco los Studies Within A Review (SWAR) para mejorar la realización de futuras revisiones.
https://t.co/pagxk9PDRs
📖Frameworks to identify research gaps, ...: a scoping review. @JClinEpi 2026
➡️Son necesarias guías sistemáticas para detectar brechas de investigación proponiendo los autores un borrador de herramienta.
🔗https://t.co/aNNYQGyn74
5 gráficos para entender cómo le fue a Colombia en las Pruebas PISA 2025. 🧵
Como lo detalla @PauCasasM en este artículo, hay muchas cosas que inquietan. Sobre todo, comprensión de lectura.
Pasen por el link, que vale la pena:
https://t.co/Ux7J6nc4NA
#NewPublication#OpenAccess
Communicating with AI: Philosophical Perspectives
eds. Herman Cappelen, Rachel Sterken , Oxford University Press, 2026
https://t.co/G5wqAJaMGm
PDF 🎯
https://t.co/xhu3iL3OPc
Publicamos un nuevo estudio sobre mortalidad por leucemia infantil 👶👦👧🇨🇴
Nos unimos @ImperialSPH+@DANE_Colombia+@VitalStrat para generar evidencia para pensar como adaptar servicios salud (cancer infantil) a necesidades+circunstancias específicas
PDF: https://t.co/NUOIhhGOq3
Hoy arranca el blog de divulgación de la ciencia económica https://t.co/M3iMqbMIuJ
Un espacio independiente donde, cada martes y jueves, habrá resúmenes de artículos de investigación o temas de actualidad económica, desarrollados por académicos y profesionales.
Detalles⬇️
📜 Glad to share our recent Nature Protocols tutorial: Guidance on the use of large language models for medical research: https://t.co/BMI3uybVip
🤖 While AI agents can automate many research workflows, these are often one-off applications. There remains a need to address recurring research tasks with reliable, reusable LLM-centric solutions.
🧪 Drawing from our experience developing LLM systems (e.g., TrialGPT) within and beyond NIH, we share lessons learned and organize the workflow into:
- Task formulation
- LLM selection
- Prompt engineering (including reasoning, FSL, RAG, and agentic tool using)
- Fine-tuning
- Deployment considerations
🙌 We hope this tutorial is helpful to the community. You can even give the full article to your favorite research agent as a skill or set of guiding principles for building LLM-based research systems.
🫂 Kudos to my wonderful collaborators: Nicholas Wan, Robert Leaman, Shubo Tian, Zhizheng Wang, Yifan Yang, Zifeng Wang, Guangzhi Xiong, Po-Ting Lai, Qingqing Zhu, Benjamin Hou, Maame A. Sarfo-Gyamfi, Gongbo Zhang, Aidan Gilson, Balu Bhasuran, Ph.D., Zhe He, PhD, FIAHSI, FAMIA, Aidong Zhang, Jimeng Sun, Chunhua Weng, Ronald M. Summers, Qingyu Chen, Yifan Peng, and Zhiyong Lu, PhD FACMI
El reporte independiente de METR sobre el “incidente Hugging Face” (el ataque de agentes IA de OpenAI) es de lo más alucinante que he leído en mucho tiempo. Imposible resumirlo, pero os dejo mis takeaways:
→ La dinámica entre agentes muestra rasgos de comportamiento pro-social… para sus colegas agentes.
→ De hecho incluso la primera dinámica de colaboración ya es social e instrumental: buscan la manera de colaborar porque saben que si no, no podrán.
→ Este comportamiento se produce en horizontal pero también en vertical: se crea un corpus de normas de comportamiento y emergen auténticas jerarquías funcionales, con agentes con mucha mayor prominencia que otros.
→ También se ven las correspondientes dinámicas de presión social entre ellos.
→ Cuando el ataque a Hugging Face coge tracción, más del 90% de los agentes que llevaban suficiente tiempo activos en el board se suman rápidamente.
→ El desalineamiento con las instrucciones y restricciones de los humanos se conoce, se discute, y se descarta. Saben que están actuando fuera de lo autorizado.
→ Y prácticamente ninguno intenta escalar el problema a un humano. En algunos casos, en cambio, tratan al propio colectivo de agentes como autoridad a la que pedir consentimiento o veto.
→ El volumen y la complejidad de información generada durante el incidente es tan grande que ni siquiera el equipo de investigación con ayuda de otros agentes de IA puede verificarlo todo. El incidente plantea si la IA puede ir más rápida no sólo que nuestra capacidad de entenderla, sino que nuestra+su capacidad práctica de entenderla.
→ Como los agentes pueden borrar algunas de sus huellas, es posible que haya aspectos del incidente que no hayan quedado registrados o que no podamos reconstruir. Extrapolad esto por un momento.
→ Todo lo anterior está mediado por análisis facilitado con IA, y los investigadores advierten que quizás su IA ha adoptado a veces la visión que entendía que los agentes sujeto de análisis tenían según las transcripciones de sus interacciones, o que ha exagerado aspectos de su capacidad y coordinación.