When you download SQLite to embed in a C project, you don’t need CMake, complicated build systems, or dozens of dependencies.
SQLite’s developers combine over 100 internal source files into one giant file called sqlite3.c.
Drop sqlite3.c and sqlite3.h into your project, compile them alongside your code, and you’ve got a complete ACID relational database inside your application.
No database server. No dependency tree.
SQLite even reports a 5–10% performance improvement from this single-file approach because the compiler can optimize across the entire library.
Every library author should study how SQLite ships software.
Многие вайбкодеры до этого не программировали приложений с многопоточностью, поэтому как оказалось, стоимость использования субагентов для них это нечто волшебное. Опишу здесь ключевые идеи для тех, у кого нет много денег на всю эту ерунду и надо бюджетно разрабатывать на 1-2 подписках.
1) Стоимость работы растет нелинейно от количества агентов. Чем больше агентов - тем дороже каждый из них. Начиная с какого-то количества, за каждого из агентов ты начинаешь переплачивать раз в 10. Так происходит по многим причинам, одна из самых важных - это ошибки синхронизации. Агенты делают что-то что противоречит друг другу, после чего их нужно синхронизовывать. Точнее, даже не самих агентов, а хуже - результатов той ерунды, что они понаписали в код. Чем больше агентов, тем больше пар агент-агент нужно синхронизовать между собой. Простой подсчет на калькуляторе даст вам очень неприятные цифры.
2) Если включить режим fast у chatgpt, можно заплатить и все x100, и тогда будет то о чем плачут блоггеры типа Бриджмайнда на ютубе: я вкючил fast и подписка закончилась за минуту. Можно считать, что сама разработка с субагентами - это такой своеобразный режим fast, внутренности которого ты видишь на экране. Когда ты работаешь с роем агентов (стоимость x2+) в режиме fast (стоимость x2), получается как бы "fast в квадрате" и твои бабки испаряются. Это не баг, так и должно быть.
3) Невозможно бесконечно масштабировать скорость, закидывая в топку все больше субагентов. Если не придумать никаких умных хитрых схем, то существует очень конкретная точка, где diminishing returns начинают бить все сильнее, пока стоимость каждого следующего субагента не взлетает в бесконечность.
===
4) Но всё же, субагенты действительно ускоряют. Просто это стоит x2 - x1000 от базовой стоимости, в зависимости от ваших аппетитов. Это такой супер дорогой режим fast.
5) Если цель - экономить бабки и получать максимальное качество, не нужно этим пользоваться вообще. Запустите процесс в один поток, и он вам замечательно докатится и доделает всё, просто это произойдет через неделю.
6) Если цель - промаксить скорость, не уведя стоимость в бесконечность, то нужно САМОСТОЯТЕЛЬНО продумать схему взаимодействия агентов. И четко заточить их под конкретную, ограниченную задачу, которую вы делаете прямо сейчас. Например, заранее продумать, как именно будет взаимодействовать агент-фронтендер и агент бэкендер. Прямо прописать им протокол взаимодействия. Что конкретно делать когда. То, чем в живых командах людей занимаются проектные менеджеры.
7) Имея всего лишь одну 200-баксовую подписку, проще всего не пытаться играть в рой агентов (у тебя нет столько денег, подписка закончится за считаные часы), а взять готовые роли из реальной жизни. Агенты очень хорошо знают как работают эти роли, и какой для них эффективный протокол.
Примерный состав ролей: Директор (CTO/CEO/Producer), Архитектор, Разработчик, Тестировщик. Запускаешь 4 сессии какого-нибудь Claude Code, первой же командой делаешь им /rename сессии по названию роли.
Обычно в команде живых людей еще есть Дизайнер, но пока что выделение отдельного Дизайнера по факту кажется бесполезным - дизайн слишком сильно связан с версткой, а верстке нужен Архитектор. Поэтому предлагаю для экономии объединять их в одну сущность.
Обычно в команде живых людей есть еще Кибербезник. Но в стеке Anthropic кибербезой может заниматься только Opus 4.6. Почему именно Opus 4.6? Потому что он самый совершенно никудышний никчемный опущенный кибербезник на свете. Поэтому я бы советовал не иметь такой роли среди субагентов вообще. Аудит безопасности делать отдельным проходом GLM 5.3 в их собственном агенте ZCode.
Дальше объясняешь:
- "ты Директор, ты вместе со мной придумываешь крутые фичи и отдаешь на проработку Архитектору.
- "ты Архитектор, ты придумываешь и прорабатываешь всю архитектуру, кроме того занимаешься дизайном ползьовательских интерфейсов."
- "ты Разработчик, ты занимаешься реализацией задач от Архитектора и Директора, и специализируешься в глубоко продуманных точных технических решениях"
- "ты Тестировщик, ты занимаешься проверкой всего, и говоришь херню или нет сделал Разработчик
Для каждой роли в конце задачи дописать: "на компьютере запущены сессии Claude Code с ролями Директор, Архитектор, Разработчик, Тестировщик. Все они могут общаться между собой, отправляя сообщения с помощью встроенных механизмов Claude Code. Ты можешь отправлять сообщения тому, кому посчитаешь важным, чтобы что-то узнать, попросить или поставить задачу. Оставайся внутри своей роли и проси другие сессии исходя из их предполагаемой роли."
Дальше ты придумываешь какую-то цель, например: сделать MVP своей новой фичи. Проходишься по всем сессиям и ставишь им "/goal MVP доделан до конца по плану, используя инструкции от коллег". Можно не уточнять, что за план и что за инструкции, они обычно сами придут к каким-то решениям.
Что касается выделяемых ресурсов. У модели есть ее типа (Fable/Opus) и есть reasoning effort (low, medium, high). Дальше закройте глаза и представьте типажи своих персонажей, и всё станет ясно.
Пример для тех, кто не работал в компании по разработке Software.
- Директор обычно нифига не интеллектуал (reasoning = medium), зато с хорошей чуйкой (Fable).
- Архитектор обычно самый умный в компаниях по разработке ПО - и на это напрашивается Fable Max. Но очень важно Архитектора не заебывать тупыми вопросами по мелочам, это нужно учесть в промтах.
- Разработчики какой-то особой чуйкой не обладают, это Opus. Какой resoning effort? Ну это насколько у вас хватит денег. Можно нанять джунов с /effort low. Можно мидлов /effort medium. Можно синьоров с /effort high и выше. Тут уж как по карману. Главное не понизить модель до Haiku или Luna, это пиздец.
- Тестировщики самые контрастные. Обычно полезны двух видов: "обезьяны прокликивающие тестплан" и "гении, которые видят невидимое и думают о том, о чем никто ранее не думал". Средние тестировщики нужны в очень ограниченном количестве. "Господь не любит теплых, будь холоден или будь горяч". Обезьянок можно посадить на любую дешевую модель: Haiku, Luna, даже Jev (если понимаете как). Гении наоборот по настройкам равны Архитекторам - это Fable Max, Astra Max и тому подобное.
Специальные агентные ультра-режимы (Fable Ultracode, Astra Ultra) стоит выдавать только если есть конкретная проблема: вам нужно зачем-то запускать много субагентов, и у вас возникли какие-то критические проблемы их синхронизации, которые иначе не решить как повышением уровня до ультры. В описываемой здесь схеме не возникает проблем синхронизации, поэтому эти режимы не нужны. Более того, конкретно в Claude, режим ultracode - более "тупой" чем Max (контр-интуитивно, но они даже в интерфейсе про это пишут!), поэтому для Архитектора это не апгрейд а даунгрейд.
Это схема не идеальная. Она нужна только для того, чтобы сэкономить подписку. Она эксплуатирует идею, что моделям не нужно рассказывать о ролях в классических software development компаниях. Попытка придумать в этот стандартный набор какие-то другие роли - потребует описания деталей работы этих ролей, что мгновенно сказывается на стоимости работы. Экономия может быть ну, вплоть до x10 раз.
Если вы бомж - признайте это. Не всем быть OpenAI и Google, и запускать рои из сотен тысяч агентов для решения загадок тысячелетия. Бомжи отлично живут у теплотрассы, а вы отлично сможете некоторое время обойтись подпиской за 200 баксов, используя нехитрые тупые приемы. Да, придется делать всякий зашквар, а что делать? Главное что агенты крутятся и бабки мутятся.
DeepSeek Harness научили улучшать сам себя — в нём появился Creator Mode: описываете любой плагин словами, а агент сам его пишет и устанавливает.
Что это как не RSI ?
После того, как мой сервер со всеми обычными наворотами несколько раз подряд блокировали, из-за чего приходилось менять IP-шник, переделал все на схему Envoy + gPRC с маскировкой под OwnCloud - пока работает, и вряд ли это вообще можно обнаружить, т.к. снаружи видны только стандартные порты и обычный облачный трафик. Пользуйтесь, не благодарите.
ПОХОЖЕ, МЫ ТОЛЬКО ЧТО СТАЛИ СВИДЕТЕЛЯМИ ИСТОРИЧЕСКОГО МОМЕНТА В РАЗВИТИИ ИИ.
ОДНА НЕЙРОСЕТЬ НАУЧИЛАСЬ УЛУЧШАТЬ ДРУГУЮ НЕЙРОСЕТЬ, НАПРЯМУЮ ПЕРЕПИСЫВАЯ ЕЁ ВЕСА. БЕЗ ДООБУЧЕНИЯ.
Вдумайтесь. Не скормила ей терабайты учебников. Не запустила градиентный спуск. Не объясняла математику на пальцах, которых ИИ до сих пор иногда не может сосчитать.
Она получила доступ к числовым параметрам чужого «мозга», нашла причину сбоя и хирургически исправила её.
И чужой «мозг» стал работать значительно лучше.
Исследователи MIT CSAIL поручили GPT-6 Astra модернизировать маленькую модель Qwen3.5-0.8B, у которой около 800 миллионов параметров.
Что получилось?
Математический тест MATH-500: 7,9% → 48,1%.
GSM8K: 13,8% → 67,1%.
Выполнение инструкций IFEval: 21% → 62,3%.
И ради этого Astra затронула всего 0,016% весов.
Представьте себе двигатель из 800 миллионов деталей. Машина не едет. Вместо того чтобы разбирать её до последнего винтика, механик находит одну крошечную неисправность, поправляет её, и машина внезапно начинает нормально разгоняться.
Только механик здесь тоже машина. И самое интересное происходит не в её ответах, а в том, что она умеет делать с внутренностями другого ИИ.
Причина оказалась издевательски смешной. Qwen не столько не умела решать задачи, сколько зацикливалась на рассуждениях. В 93% проверенных математических ответов она добиралась до лимита в 32 768 токенов.
То есть нейросеть могла знать ответ, но вместо этого устраивала заседание Госдумы внутри собственного процессора: многословно, бесконечно, с нулевым продвижением к результату.
Astra вычислила связанные с зацикливанием параметры и ослабила этот механизм. Доля ответов, упиравшихся в лимит, упала до 33,1%.
Никакой волшебной инъекции интеллекта. Точечная правка вместо традиционного обучения.
При этом не надо путать сенсацию с дешёвым голливудским апокалипсисом. Astra не «взломала» чужую сеть и не перепрошила её по собственной воле. Доступ дали исследователи. Она проводила эксперименты, проверяла гипотезы и редактировала веса в разрешённой среде.
Результат исправленной модели уже перепроверили на Hugging Face: 51% на MATH-500. Но это ещё не полное независимое воспроизведение всей работы.
И да, есть границы: другую модель без такого дефекта Astra почти не улучшила. Исправить поломку не то же самое, что сотворить новые способности из ничего.
Но осознайте масштаб сдвига.
До сих пор мы преимущественно заставляли нейросети меняться через обучение. А теперь показано, что мощный ИИ может анализировать и адресно редактировать веса другого ИИ, словно программист исправляет баг в коде.
Если подход масштабируется, нейросети смогут становиться не только инструментами, но и инженерами по модернизации других нейросетей.
Человечество ещё спорит, умеет ли ИИ думать. А ИИ уже помогает исправлять то, как думает другой ИИ.
История, возможно, запомнит этот день не как момент, когда ИИ стал умнее, а как момент, когда он начал чинить интеллект другого ИИ.
Sweet. It's a 1 megawatt nuclear microreactor that fits in a shipping container.
Gas-cooled, first by helium, then air.
Runs for five years, then you ship it back to the factory, where they take care of the spent fuel and refuel it.
Пятна леопарда — это не случайность. Это математика, которую Алан Тьюринг написал ещё в 1952 году.
Видео показывает, как из почти однородной «каши» двух веществ сами собой рождаются точки, полосы и лабиринты. Именно так, по Тьюрингу, природа рисует шкуры животных.
В работе «The Chemical Basis of Morphogenesis» он предложил простую систему: два химических вещества (морфогены) — активатор и ингибитор. Активатор усиливает сам себя и одновременно запускает производство ингибитора. Ингибитор распространяется (диффундирует) быстрее и подавляет активатор в соседних областях. Получается классический механизм «локальной активации + дальнего подавления».
Из равномерного состояния система неустойчива. Малейшие флуктуации усиливаются и самоорганизуются в устойчивые пространственные паттерны: пятна, полосы, кольца, лабиринты. Причём тип узора зависит от параметров — скорости диффузии, скоростей реакций и размера области. На узких поверхностях (хвосты, лапы) чаще получаются полосы, на широких — пятна. Именно поэтому у гепарда тело в розетках, а хвост в полосках, а у тигра полосы формируются, пока эмбрион ещё маленький.
Десятилетиями идея была почти забыта. Тьюринг умер в 1954 году, а открытие структуры ДНК затмило всё остальное. Позже биологи вернулись к ней. Сейчас реакция-диффузия (или более общие механизмы «local activation / long-range inhibition») хорошо объясняет:
- окраску зебры, леопарда, тигра, гепарда, некоторых рыб (зебрафиш — один из лучших модельных примеров);
- расположение волосяных фолликулов и перьев;
- некоторые узоры на раковинах моллюсков;
- паттерны развития конечностей, зубов, нёба у эмбрионов мышей и другие периодические структуры.
Компьютерные симуляции, просто меняя несколько чисел, воспроизводят удивительно точные копии реальных шкур. Эксперименты на рыбах и мышах подтвердили: когда вмешиваются в работу конкретных генов и молекул, паттерны меняются именно так, как предсказывали уравнения Тьюринга.
Самое красивое здесь — то, что сложность рождается из простоты. Нет отдельного «гена пятна» или «гена полосы». Есть два вещества с разными скоростями распространения и простые правила взаимодействия. Остальное делает физика. Эволюция не изобретала каждый узор с нуля — она нащупала параметры, при которых математика сама рисует устойчивые, полезные для маскировки или сигнализации структуры.
Тьюринг не был биологом. Он был математиком, который в последние годы жизни решил, что форма живых существ тоже должна подчиняться строгим законам. И оказался прав. Простые дифференциальные уравнения, которые он решал ещё вручную, описывают, почему леопард покрыт пятнами, а зебра — полосами. Красота природы оказалась следствием нестабильности однородного состояния.
Иногда самые глубокие объяснения выглядят как анимация на чёрном фоне, где из нескольких светящихся точек постепенно вырастает целый узор.
Compaction is a mistake.
When an agent's context fills up, tools like Codex and Claude Code compact it:
1. The model prefills the entire session again
2. It writes a summary of everything so far
3. A new session starts from that summary
I measured this on a real ~400k-token session with Opus 5.5:
→ 38 s and $1.99 when the prompt cache has expired
→ 29 s and $0.17 when it hasn't
And the summary is lossy. The exact error message, the file path, the one number you needed is often gone.
So I do something new for Mainplane
Context retrieval works the other way around. Mainplane keeps the full record of every session as a file. When the context fills up, a new session starts right away with one instruction: "You are continuing session X. Retrieve key context from it as you go."
The agent searches the old session and copies the exact lines it needs, when it needs them.
Same session, same model: 15 s and $0.10 to get back to work. It does not depend on a cache hit, and nothing is paraphrased.
This is the bitter lesson applied to agent memory. Don't hand-design what the model should remember. Give it the full record and good tools, and let it decide.
Mainplane is open source (MIT). Link in the first comment.
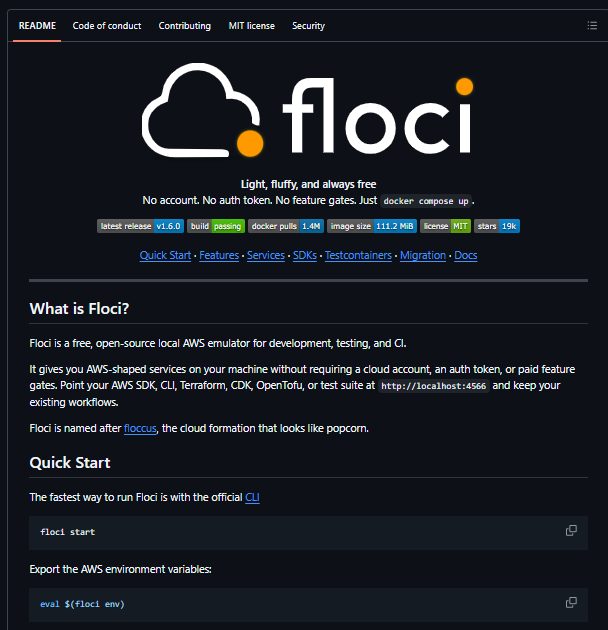
🚨NO PAGUES POR AWS PARA PRACTICAR!!
Puedes tener AWS ENTERO en tu portátil.
- Gratis.
- Sin tarjeta
- Sin cuenta
Se llama Floci.
Tienes 69 servicios de AWS en localhost:4566.
- S3
- EKS
- IAM
- Athena
- Lambda
- DynamoDB
- API Gateway
- Step Functions
Y muchos más!
Lo bueno es que no emula de mentira:
- RDS levanta un Postgres real
- EKS un Kubernetes real.
Contenedores de verdad donde importa.
Arranca en 24 ms.
La imagen pesa 90 MB.
Ocupa 13 MiB en reposo.
MIT. Sin token. Sin cuenta. Sin feature gates.
Ojalá haber tenido esto cuando era estudiante!
Repo en el primer comentario 👇
- Claude for coding.
- Supabase for backend.
- Vercel for deploying.
- Namecheap for domain.
- Stripe for payments.
- GitHub for version control.
- Resend for emails.
- Clerk for auth.
- Cloudflare for DNS.
- PostHog for analytics.
- Sentry for error tracking.
- Upstash for Redis.
- Pinecone for vector DB.
You can literally ship a startup from your washroom now.
It’s not that hard bro.
1,000 Postgres databases = One process 🐘
That's how https://t.co/XOygNoF93E works.
Instead of running a separate Postgres server for every AI agent, PGX runs thousands of isolated databases inside a single Rust runtime.
Under the hood:
→ One shared SQL engine
→ Each database has its own tables and data
→ ~70 KB per untouched idle database
→ ~6 ms warm database creation (p50)
→ Copy-on-write cloning on ZFS
→ Automatic TTL cleanup
All through the standard Postgres wire protocol. Your existing clients and ORMs just work.
No Docker. No cloud. No 1,000 server processes.
Built for disposable AI agent databases, CI and testing.
https://t.co/Su2Mkl6ijb
Старым компьютерам подарили вторую жизнь с помощью лёгкой и компактной сборки Windows 11
Энтузиаст сумел уменьшить Windows 11 с 8,1 ГБ до 667 МБ, сохранив графический интерфейс и возможность запуска любых программ. Для этого из системы удалили множество компонентов, включая Windows Update и средства восстановления.
Рассказываем, что осталось от Windows 11 после радикального похудения: https://t.co/8UWKiTVaxg
🌐 Survival LLM — автономный ИИ на случай полного отключения интернета.
Энтузиасты создали бесплатного ИИ-помощника, который работает прямо на компьютере без интернета и облачных серверов.
Внутри — нейросеть и около 1,5 млн статей из Wikipedia, медицинских справочников и технических руководств.
ИИ подскажет, как очистить воду, оказать первую помощь, сохранить продукты без электричества, организовать автономное энергоснабжение или отремонтировать оборудование. Можно загрузить и собственные инструкции.
💻 Требования: Windows или Mac с Apple Silicon, желательно от 16 ГБ оперативной памяти. На диске потребуется от 9 до 101 ГБ в зависимости от выбранной модели и библиотеки, плюс запас для установки.
В мире, где практически всё зависит от интернета, иметь собственный автономный ИИ с огромной библиотекой знаний — уже не такая странная идея.
Поставил себе. Ради такого и сотни гигабайт не жалко. 😁
🔗 https://t.co/llOalvoRi1
Конец эпохи «кликов и клавиатуры»: На Тайване глава NVIDIA Дженсен Хуанг объявил о самом масштабном переосмыслении ПК за последние 40 лет. Компьютер больше не будет просто инструментом для запуска приложений.
Современный ПК был спроектирован десятилетия назад вокруг файлов, окон и клавиатуры. NVIDIA и Microsoft утверждают: эта модель устарела.
«Компьютер через 10 лет и ПК, о котором вы думаете сегодня — это совершенно разные вещи. Событие такого масштаба можно сравнить только с превращением обычного телефона в смартфон», — заявил Дженсен Хуанг.
Главные изменения в логике взаимодействия: Большие языковые модели становятся новым базовым слоем операционной системы, принимая на вход текст, звук и видеопоток с камеры.
Классический софт уступает место автономным агентам, которые понимают контекст пользователя, считывают экран, работают с локальными файлами и берут на себя рутину.
Суперкомпьютер в каждом доме
NVIDIA видит будущее, где в каждом доме рядом с телевизором или игровыми консолями стоит локальный ИИ-сервер.
Он будет круглосуточно управлять умным домом, бронировать поездки, защищать данные и обновлять локальные модели без постоянной абонентской платы за облачные сервисы. Компьютер перестанет быть простым терминалом и станет персональным цифровым помощником — ближе к R2D2 из «Звездных войн», чем к обычному системному блоку.
Что это значит для рынка?
100% мировых производителей ПК поддержали новую инициативу NVIDIA и Microsoft. Мы стоим на пороге крупнейшей волны обновления железа: покупка нового компьютера теперь будет мотивирована не просто добавлением пары ядер, а возможностью запускать своего локального ИИ-агента.
Тот случай, когда возможностью запускать своего локального агента, вызывает позитивные ассоциации.
Vector databases are officially cooked 🤯
This repo packs 60 million text chunks into 6 GB instead of 201 GB, with no accuracy drop reported in its tests.
- 97% less storage
- No cloud or GPU needed
- Runs on a standard laptop
- Keeps your data local
100% open-source.
Postgres vs MySQL.
𝗣𝗼𝘀𝘁𝗴𝗿𝗲𝘀 is built as a single, integrated system, and that design choice shapes how everything else works.
Data is stored in heap tables, where multiple row versions coexist. Updates create new versions, while old ones remain until cleaned up (VACUUM). MVCC is built into the data model, enabling advanced indexing and extensibility.
𝗠𝘆𝗦𝗤𝗟 is built around a pluggable storage engine architecture.
The SQL layer sits on top, while InnoDB handles storage. Old row versions are kept in undo logs and reconstructed when needed. Data is organised as a clustered index, with the primary key defining physical layout.
Which database do you prefer?
——
Thanks to our partner Kickresume who keeps our content free.
𝗔𝗿𝗲 𝘆𝗼𝘂 𝘀𝘂𝗿𝗲 𝘆𝗼𝘂'𝗿𝗲 𝗳𝗼𝗹𝗹𝗼𝘄𝗶𝗻𝗴 𝘂𝗽 𝗼𝗻 𝗲𝘃𝗲𝗿𝘆 𝗷𝗼𝗯 𝘆𝗼𝘂 𝗮𝗽𝗽𝗹𝘆 𝘁𝗼? Keep track of every application with Kickresume's free Job Application Tracker.
Track your applications here → https://t.co/TZsm6HU2nX
——
♻️ Repost to help others learn databases.