$RXRX licenses $TEM data. $TEM licenses $RXRX’s model.
I traced the contracts and financials of four AI-bio companies. My rule: start with a paying workflow, then value drug rights and funding needs separately. https://t.co/PiuHc9uQ3B
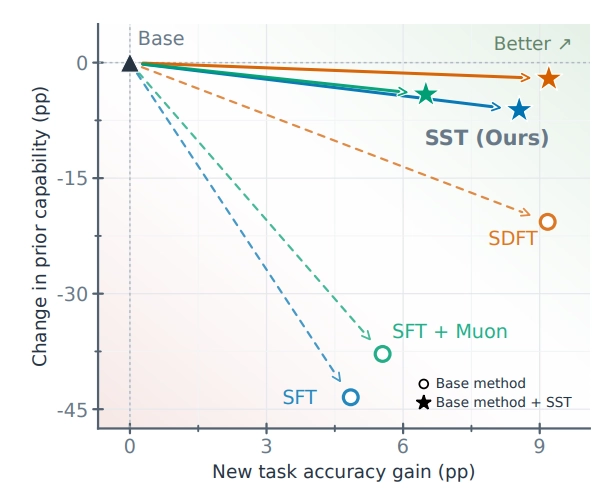
회사에서 쓰는 AI에 새 업무를 가르쳤는데, 잘하던 코드 작성이나 지시 수행이 나빠지면 업데이트를 적용하기 어렵습니다.
SST는 가중치가 바뀌는 방향을 제한해 새 과제를 배우는 동안 기존 능력을 지키려는 방법입니다. 이번 논문은 Qwen3-8B에서 새 과제 점수와 기존 5개 벤치마크 평균을 함께 비교했습니다.
실제 도입에서는 각 업무에서 지켜야 할 성능을 정하고, 그 기준을 충족하는 방법끼리 총 학습비를 비교해야겠습니다. 업데이트 방향을 계산하고 갱신하는 데 드는 추가 연산도 그 비용에 포함해야 합니다.
How can LLMs learn new skills from offline data without losing what they already know?
Introducing Subspace Tuning (SST): a simple approach that improves the learning–forgetting trade-off by controlling where weight updates happen.
Paper: https://t.co/66hCsCIgeE
Blog: https://t.co/tzi6j86Yzg
🧵 1/8
@ololadev_ I meant it as a proposal. One writer can become a bottleneck; I'd measure that first. For conflicting edits, I'd check the version each worker read and send stale proposals back for review. CRDTs would need a merge rule that fits the actual shared data.
@MattiasAkke For checking conclusions, I'd track a known conflict from retrieval to the final claim, then compare with the same task without that conflict. This paper separates finding, resolving and reporting uncertainty: https://t.co/yVPYG69Xev
@Attollo_Labs_AI I'd prefer a short reply: 'I've picked up X. I'll do Y by Z.' A checklist can support that for complex work, but I'd still want a named owner to accept it—or say they can't.
에이전트를 멈춰도 이미 보낸 메일이 저절로 취소되지는 않습니다.
엔비디아의 OpenShell 문서는 네트워크 격리, 프로그램 종료, 외부 서비스의 권한 회수를 구분합니다.
기업이 에이전트를 업무에 붙일 때는 잘못된 동작을 얼마나 빨리 잡는지와 함께, 어느 단계까지 막을 수 있는지 봐야 합니다. 이미 처리된 작업을 어떻게 확인하고 수습할지도 정해둬야 합니다.
문서: https://t.co/k7w8fvJa4A
AI가 정해진 실행 경계를 벗어나려 하면,
별도 칩에서 감지해 멈추도록 설계한 구조입니다.
엔비디아가 기업용 AI 에이전트를 위한
‘OpenShell Reference Architecture’를 공개했습니다.
AI가 작업하는 환경과 별개로,
보안 칩과 소프트웨어가 행동을 감시합니다.
엔비디아는 에이전트가 정해진 실행 경계를 넘으려 하면
격리하고 중단하도록 설계했다고 설명합니다.
AI에게 규칙을 알려주는 데서 끝내지 않고,
실제로 지키게 하는 장치를 따로 두는 접근이네요.
https://t.co/tOFsEZkkrP
게임하는데만 사용했던 RTX 3060 Ti를 사용해서 TTS 시도해봤습니다.
- 모델: GPT-SoVITS V2Pro, Qwen3-TTS
- 데이터: iphone 음성메모로 녹음한 72개 클립 (6분 55초)
음색은 반영됐지만, 원하는 감정을 넣으려면 학습 데이터를 더 다양하게 설정해야한다는...
Qwen3 가 압도적으로 괜찮았고, 녹음하면서 아나운서가 대단하다는 생각도 새삼 들었습니다.
다음 목표는 감정별 데이터 구축과 추가 파인튜닝으로 Elevenlabs에서 졸업해보고자 합니다.
AI가 설계한 루비스코에서 효소 활성이 확인됐습니다.
이 연구는 약 560만 개의 서열을 생성하고, 후보를 좁혀 21개를 실험했습니다. 그중 6개는 대장균에서 수용성으로 발현됐고, 5개는 반응 생성물인 3-PGA를 만들었습니다.
루비스코를 개선하려면 이산화탄소를 더 빠르게 고정하고, 산소와의 반응을 줄여야 합니다. 식물에 적용할 때는 광합성과 생장이 얼마나 달라지는지도 봐야겠지요.
단백질 AI 기업을 볼 때도 어떤 실험으로 후보를 걸러내고, 그 결과를 다음 설계에 어떻게 반영하는지 보겠습니다.
We are delighted to host Alex Kehl for an ML4PE seminar titled “De novo Rubisco Design with Protein Language Models” Please see below for the talk abstract and event details.
Time: Tuesday, October 13, 2026, 4-5 PM ET
https://t.co/JkaDm80pHM
@hesamhakim For that test, I would track what fraction of the rare responders seen in the movie yield usable sequencing profiles, alongside the overall matching rate. Losses in that group could be easy to miss in the pooled number.
@tessafyi In the Claude binder report, 17 of 211 tested designs met the binding/off-target criteria. The 64-hour clock stops at the initial 180-candidate shortlist. I’d start with how they picked candidates and what the binding tests measured.
@jpsenescence The authors report lower creatinine clearance than in fresh and 24-hour cold-stored controls, and list survival transplantation as a next step. The scale-up is striking; durable graft function is the result to watch next.
코딩 AI의 비용을 비교할 때는 API 요금과 함께 사람이 다시 확인하고 고치는 시간도 봐야 합니다.
SlopCodeBench는 같은 코드에 요구사항을 계속 추가하며 새 기능과 기존 기능이 함께 돌아가는지 봅니다. 각 모델이 남긴 코드를 같은 기준에 맞게 고치는 시간까지 재면, 실제로 어느 모델이 일을 덜어주는지 비교할 수 있습니다.
최근 ChatGPT나 AI 코딩 모델을 사용하면서 예전보다 성능이 떨어졌다고 느끼신 적 있으신가요?
저도 최근 그런 생각을 했는데, 흥미로운 코딩 벤치마크를 발견했습니다.
AI가 새로운 코드를 만드는 능력과 기존 코드를 망가뜨리지 않고 수정하는 능력은 상당히 다를 수 있다는 것입니다.
SlopCodeBench는 AI에게 프로그램을 한 번 만들게 하는 것이 아니라, 요구사항을 단계적으로 추가하면서 이전에 작성한 코드를 계속 수정하도록 합니다.
새 기능이 작동하는지뿐 아니라 기존 기능까지 정상적으로 유지되는지 평가하는 방식입니다.
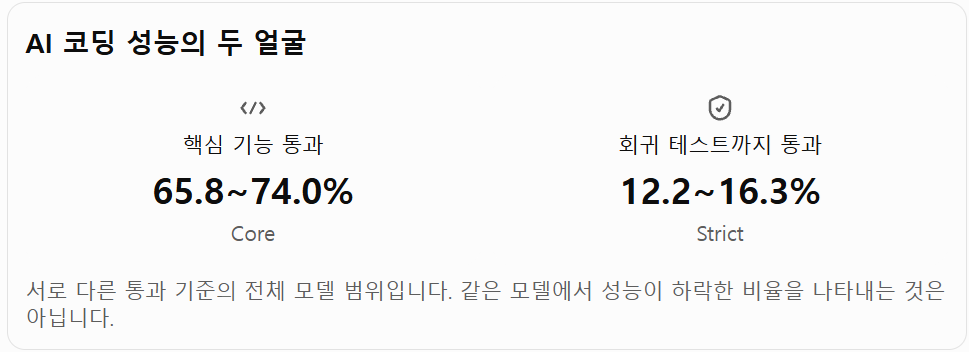
2026년 10월 HumanLayer가 공개한 비교 결과를 보면, 36개 문제와 196개 체크포인트에서 다음과 같은 결과가 나왔습니다.
Core 통과율: 65.8~74.0%
Strict 통과율: 12.2~16.3%
Core는 해당 단계의 핵심 기능을 평가하고, Strict는 기존 기능의 회귀 테스트까지 모두 통과해야 인정됩니다.
그런데 더 흥미로운 결과가 있습니다.
추론 노력을 XHigh로 높이면 비용이 Medium 대비 2.11~4.22배 증가했지만, 세 모델 중 Strict 통과 수가 개선된 것은 한 모델뿐이었습니다.
가장 높은 Strict 통과율을 기록한 Astra XHigh조차 36개 문제 중 마지막 단계까지 모든 테스트를 통과한 문제는 3개였습니다.
Hacker News에서도 비슷한 논쟁이 이어졌습니다.
AI가 기존 구조를 수정하기보다 새로운 코드를 덧붙여 복잡하게 만드는 문제, 추론 노력과 비용의 관계, 고성능 모델 하나와 여러 에이전트의 분업 중 무엇이 효율적인지 등이었습니다.
물론 이 결과가 최근 ChatGPT의 성능이 실제로 하락했다는 증거는 아닙니다. 모델·설정별 한 번만 실행한 실험이기도 합니다.
하지만 제가 느꼈던 성능 저하가 단순히 모델의 지능 문제가 아니라, 작업이 누적되면서 기존 코드와 요구사항을 유지하는 능력의 한계와도 관련이 있지 않을까 생각하게 됩니다.
개인적으로 이제 코딩 AI를 평가할 때는 첫 번째 구현 결과뿐 아니라, 두 번째와 세 번째 수정 후에도 기존 코드가 정상적으로 유지되는지를 확인해야 한다고 봅니다.
여러분도 AI가 요청한 기능은 잘 구현했는데, 기존 코드를 망가뜨리거나 불필요하게 변경해서 다시 수정해야 했던 경험이 있으신가요?
#AI #CodingAgent #SlopCodeBench
@KarlPfleger NAM announced a $700,000 Grand Prize for Immunis and the same amount for MGH’s MenoGo. The roughly $2m pool covers all 14 winning projects.
https://t.co/zmpCJnANEU
Biohub의 18억 달러 발표에는 기존 데이터도 들어 있습니다.
NIH는 과거 5억 달러 이상을 들여 구축한 데이터·저장소를 이 연구에 보탤 계획입니다. Biohub는 이를 AI 학습에 맞게 표준화할 예정입니다.
DOE의 5억 달러 이상은 앞으로 5년에 걸친 투자 약속입니다.
🧵 Biohub, @ENERGY, @NIH, and new funding partners today announced a major expansion of an international effort to generate and make accessible the data enabling predictive AI models of biology. Together, the organizations are investing $1.8 billion in funding, data, computation and new measurement technology - largest coordinated commitment to map the biology of the cell to power development of digital models of biology. https://t.co/PaCs7ZV2Fg
그림 아래쪽의 두 표적은 아미노산 서열이 같고, 인산기가 붙은 자리만 다릅니다.
RFD4-Proteina 개발팀은 이 차이를 구별해 붙는 단백질을 설계했다고 밝혔습니다. 인산화하지 않은 표적과도 결합을 비교했습니다.
같은 단백질의 어떤 상태에 붙게 할지까지 설계 조건으로 넣은 사례입니다.
We were able to solve design challenges built around covalent modifications: precise glycosylation control to advance vaccine design, and position-specific phosphorylation binding. Fantastic work from @MargaretLunn1 and @kinasekid 9/n