Doing a Ph.D. AI in Bio. | Ex @WhiteLabGx @BroadInstitute @MIT | Built @PiPleteam | ML, Cancer, Genomics, Data Sci, Entrepreneur, FullStack Dev | All Views Mine
🧑🎄🎄 Christmas Foundation Model Release: scPRINT-2
*One-liner:* a 20M-active-param single-cell foundation model trained on **350M cells / 16 species / 300 tissues / 500 cell types**.
AlphaGenome 2 is live! A step change in performance and new capabilities over AG1! @adamgayoso's thread covers the key results.
Manuscript: https://t.co/exVx6kxCxY
Blog: https://t.co/YkuyxDHs0D
API: https://t.co/I7zaZobbLx
A few notes under the hood & what's next:
UMAP 0.6 is out! A new initialization, new optimizers and faster nearest neighbour search make UMAP much faster and far better at large scale. On 3 million arXiv papers it finishes in under 5 minutes, before UMAP 0.5 has even found its nearest neighbours.
There’s enormous investment right now in predictive models of biology. Most of them learn from a single layer of the biological hierarchy, usually RNA, and assume what they find there carries over. Whether this large bet pays off depends on getting that mapping right. 🧵 [1/11]
Politicians like citizens always behave like the economy is something to be fitted against their wishes.
Summarized simply for most french elites: "Economy isn't a science it is a thought framework", there are no facts, just theories.
The lack of basic eco knowledge in France is explaining so much of what we have seen in the last decades. It permeates both working class and intellectual elites.
You get "economists" invited to primetime tv to say the craziest nonsense.
Really interesting (and worrying) polling on French pensions
The electorate estimates that for every pensioner we have 6 workers.
In reality it's 1.8/1... Even in 1960s we weren't close to 6/1.
Melenchon's supporters think its 13/1.
L'affaire devient de plus en plus folles. Pour résumer tout ce qu'on sait pour le moment :
- Les services de renseignement américains ont découvert que Jensen Huang, CEO de NVIDIA, entretenait une liaison avec Alice Huang, une espionne chinoise et cadre chez Megaspeed. (FT)
- Plusieurs enquêtes indépendantes ont conclu que Megaspeed est probablement une société écran chinoise, qui aide les entreprises chinoises à se procurer des puces d’IA ou à contourner les contrôles à l’exportation. (NYT et Bloomberg)
- Les services de renseignement américains ont également conclu que l’objectif d’Alice Huang était de convaincre Jensen de faire pression sur le gouvernement américain pour qu’il assouplisse les contrôles à l’exportation sur les puces d’IA de pointe. (NYT)
- Les services de renseignement ont transmis ces informations à « un petit groupe de hauts responsables du gouvernement américain » au début de l’année. (FT)
- Au cours de l’année écoulée, Jensen Huang a demandé à plusieurs reprises que le gouvernement américain assouplisse les contrôles à l’exportation sur les puces de pointe.
- Le gouvernement a accédé à ces demandes, non seulement en autorisant l’exportation de puces H200 vers la Chine, mais aussi en ne faisant pas respecter les contrôles à l’exportation qui auraient exigé une licence pour les exportations des puces Blackwell les plus avancées vers Megaspeed et l’Asie du Sud-Est.
- Bien que le departement du commerce ait vraisemblablement été informé de ces éléments par les services de renseignement américains, il n’a pris aucune mesure pour renforcer les contrôles sur Megaspeed ou l’Asie du Sud-Est.
- Megaspeed reste un partenaire cloud privilégié de Nvidia et continue de recevoir des puces Blackwell de Nvidia, alors même qu’il emploie un espion chinois qui entretiendrait une relation amoureuse avec le PDG de Nvidia.
- Des puces d’IA d’une valeur de plusieurs dizaines de milliards de dollars ont été exportées vers l’Asie du Sud-Est rien que cette année, et la Malaisie et Singapour comptent désormais parmi les quatre plus grands importateurs de puces d’IA au monde.
Les répercussions vont être considérables...
« J'ai deux passions ! »
Ambiance festive pour le concert géant de l'orchestre du Nouveau Monde sur la Place de la République à Paris.
#grevegenerale#5Novembre#greve5novembre
J'ai écouté le reportage sur TOTAL de France2.
Ce que je trouve génial, c'est l'enchaînement
- Le reportage explique -bien - que Total a pour souci de satisfaire la demande en France, notamment en gaz, vous savez le truc qui sert à chauffer...
- Donc, il extrait du gaz, alors que la demande de gaz des consommateurs ne baisse quasiment pas
- Donc, il ne peut tenir ses objectifs climatiques de réduction de l'extraction de gaz et les écolos hurlent !
- Donc Total est un vilain...
Mais en fait, j'ai alors compris que ces écolos décroissants voulaient inciter Total à ne pas satisfaire la demande, en extrayant moins de gaz, pour... faire baisser ladite demande : la base d'une économie de pénurie !
Mais si l'offre ne couvre pas la demande, les prix montent, c'est alors la crise sociale et là, l'écolo décroissant peut accuser les multinationales de piller les pauvres Français.
Ils nous prennent pour des cons !
Au passage, Pouyanné apparait peu, avec des extraits, disons "choisis" (pas par lui) : et, malgré cela, il rayonne de puissance industrielle.
Today we’re introducing Zyphra Hierarchical Attention (ZHA), a path to true subquadratic attention.
ZHA searches a learned tree of compressed summaries, with projected speedups of 35× over dense attention and 5× over MSA at 10M tokens, increasing to ~400× and ~55× at 1B. 🧵
We’ve received a lot of attention and questions about our ZHA release yesterday and how this compares to other sparse attention methods. Some thoughts below. 🧵
Today we are happy to share one of our first open research releases: Latent Sparse Attention (LSA), a step towards subquadratic attention that matches accuracy of full attention at ultra-long context.
Sparse attention attends to only a few tokens per query, but it has to find the right ones. At 10M tokens, that search takes 98% of the attention layer's time. LSA makes sparse attention up to 22.7× faster and full attention 72.4x faster.
With @kubicek_ales@caciolai@PengLiangzu@SukritSumant@Ben_Hoov@FraserGreenlee@RMBattleday@radim_urban@thoefler@jcrwhittington
Today we are happy to share one of our first open research releases: Latent Sparse Attention (LSA), a step towards subquadratic attention that matches accuracy of full attention at ultra-long context.
Sparse attention attends to only a few tokens per query, but it has to find the right ones. At 10M tokens, that search takes 98% of the attention layer's time. LSA makes sparse attention up to 22.7× faster and full attention 72.4x faster.
With @kubicek_ales@caciolai@PengLiangzu@SukritSumant@Ben_Hoov@FraserGreenlee@RMBattleday@radim_urban@thoefler@jcrwhittington
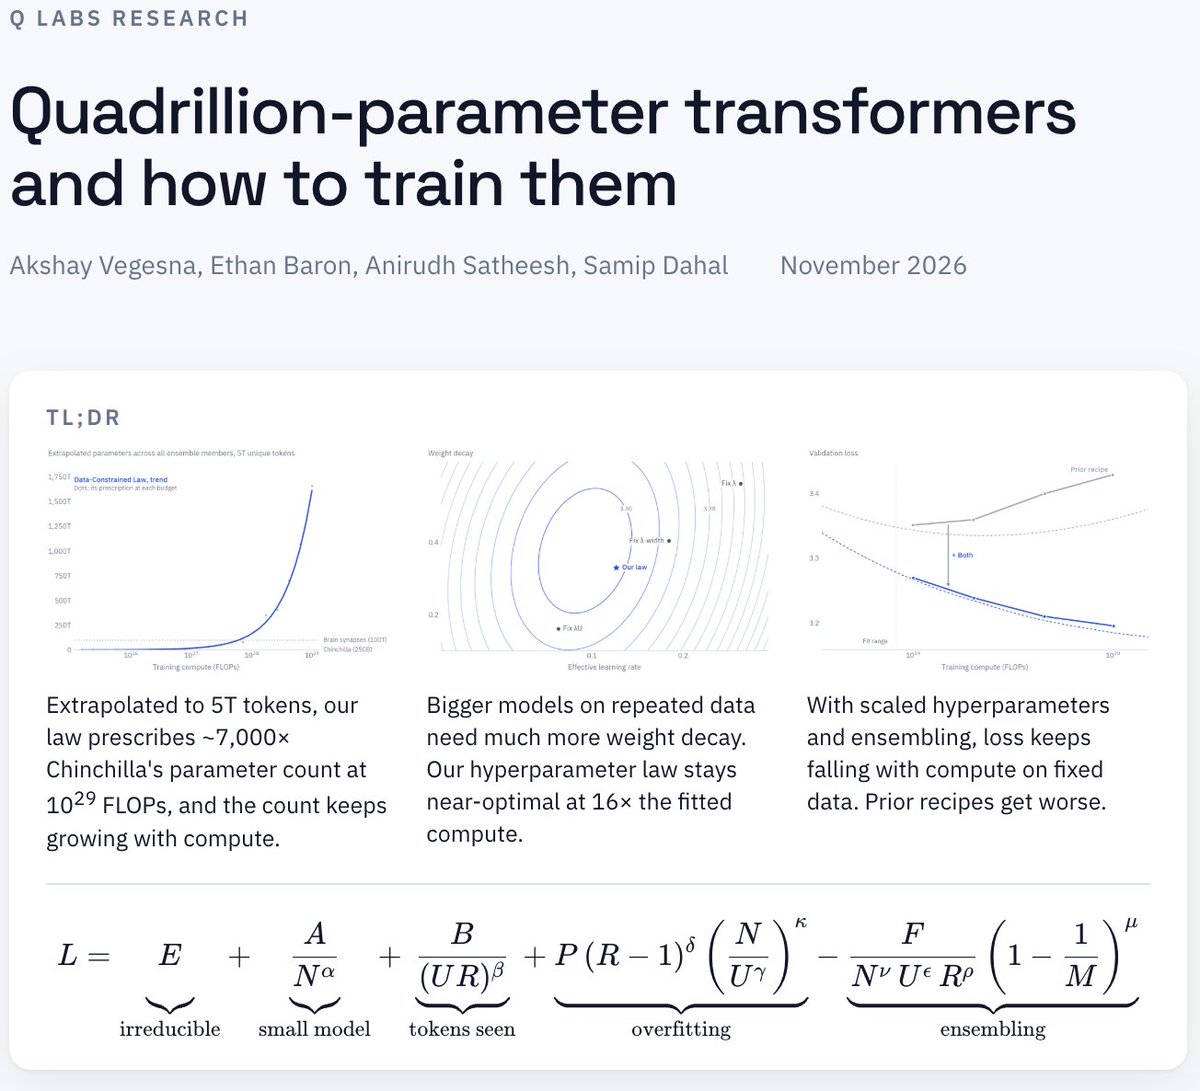
Humans are ~1,000,000x more sample efficient than LLMs, and there are no good explanations.
We’ve found that a big part of the answer is that LLMs are *massively* underparameterized by many orders of magnitude. The brain has 100T synapses learning from ~200M tokens of language. Chinchilla prescribes a 1T-parameter model on 20T tokens. That’s 7 OOMs apart in parameters per token.
After a lot of painstaking work, we present new data-constrained scaling laws and learning algorithms to scale to (extrapolated) quadrillion-parameter transformers.
w/ @akshayvegesna, @EthanBaron78553, @asatheesh6561
Full paper led by @EthanBaron78553, with @ShmuelBerman, @andrewgwils
We used coding agents to automatically build baselines for 36 "AI for science" deep learning methods from Nature, Science, and Cell-family publications. These baselines recovered a median of ~95% of the score of the published method, and beat them in 33% of cases.